L08d 图池化 DiffPool:用分配矩阵把节点合成簇
GCN 层不改节点个数,图分类却要整张图一个答案。DiffPool 用 softmax 给出分配矩阵 S,新特征是 SᵀZ,新邻接矩阵是 SᵀAS,图一层层缩小。这一页在四节点链上手算一遍,再把整讲串成图分类流程。
一句话版
图分类要给整张图一个答案,可 GCN 层做完节点还是那么多。DiffPool 先用一个 GNN 算出每个节点「进哪个簇、各占多少」,写成分配矩阵 S,再用 S 把节点特征和连接都合并到簇上,图就变小了。
上一页 L08c 的 GCN 层在这一页被当作积木反复使用。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 图池化 | graph pooling | 把图的节点合并,让图变小 |
| DiffPool | Differentiable Pooling | 一种可以求梯度的图池化方法 |
| 簇 | cluster | 合并后的新节点,由几个旧节点组成 |
| Z | embedding matrix | 每个节点的新特征 |
| S | assignment matrix | 每个节点分到各个簇的比例 |
| Sᵀ | S 的转置 | 行列互换,每行变成一个簇 |
一个类比:班级合并成小组
一个班 5 个人,要给全班打一个总评。先让每个人和邻座交流,更新自己的看法(GCN 层)。然后把 5 个人分成 4 个小组:每个小组的看法是组员看法之和,小组之间的往来是组员之间往来之和。
再交流、再合并,最后只剩一个「全班代表」,看它的看法就能给全班打分。
类比在哪里失效:
- 现实分组一人只进一个组;DiffPool 的 S 来自 softmax,一个节点可以按比例分到好几个簇。
- 现实分组靠人指定;DiffPool 的分组方式由 GNN₂ 学出来,训练时和整个网络一起调整。
从零讲起
1. 为什么需要图池化
它解决什么问题
节点分类时,每个节点各要一个答案,GCN 层不改节点个数正合适。图分类不一样:比如判断一个分子有没有毒性,整张图只要一个答案。节点数又每张图不同,没法直接接一个固定大小的全连接层。需要一种办法把图一步步缩小。
直觉
CNN 用池化把特征图变小,图上也想做同样的事。难处在于图没有固定的「相邻 2×2 方块」,哪些节点该合在一起,要看图的结构和特征来定。
一步一步看
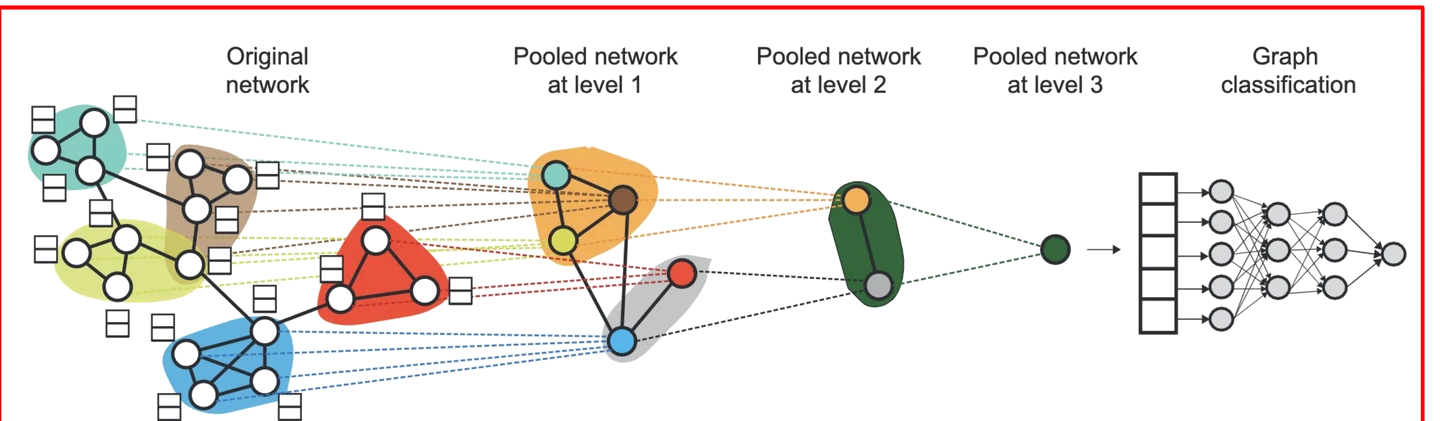
目标:对比 GCN 一层前后和课件的层级池化图,看 GCN 不改图的大小,图分类要靠池化一级级缩小。
-
一张五节点的图经过一层 GCN,还是那五个节点,只是特征变了。
-
课件的图:上面两层 GCN 的图大小不变;下面每一级把几个节点合成一个新节点,最后只剩一个,用来做图分类。
图片来源:COMP5541 Lecture 8 课件, p.23 -
池化每做一次,新图的节点数和特征长度都可以自己定,课件称为 self-defined。
怎么判断
问一句:任务要每个节点一个答案,还是整张图一个答案?前者(节点分类)堆 GCN 层就够;后者(图分类)要在 GCN 层之间插池化层,把图缩到一个节点。
常见误解
以为 GCN 层里的 Â 会把邻居合并掉
 只决定每个节点从邻居收集多少信息,收集完每个节点仍然各占一行,节点个数不变。
以为图池化可以照搬 CNN 的 2×2 最大池化
图没有固定的网格位置,「哪几个节点算一块」没有现成答案,所以 DiffPool 要用一个 GNN 去学这个分组。
试一下
预测一个社交网络里每个人支持谁,和判断一个分子能不能做药,哪个需要池化?
判断分子是图分类,整张图一个答案,需要池化。预测每个人支持谁是节点分类,不需要。
2. DiffPool 的四个矩阵
它解决什么问题
要把 N 个节点合成 K 个簇,得回答三件事:每个节点分到哪个簇(S),每个簇的特征是什么(X’),簇之间怎么连(A’)。而且这三步都要能求梯度,整个网络才能用反向传播一起训练。
从哪来(补充)
DiffPool 来自 Ying 等人 2018 年 6 月在 arXiv 发布的论文 Hierarchical Graph Representation Learning with Differentiable Pooling。摘要说它为深层 GNN 的每一层学一个可微的软簇分配,簇作为下一层的输入;和已有方法结合后,图分类基准上平均准确率提高 5-10%。论文正式发表于 NeurIPS 2018。
出处:arXiv 1806.08804,NeurIPS 2018 论文页
直觉
两个 GNN 同时看同一张图:GNN₁ 给每个节点算新特征 Z,GNN₂ 给每个节点打「属于各个簇」的分数,softmax 把分数变成加起来为 1 的比例,得到 S。
有了 S,簇的特征 = 成员特征按比例加起来(SᵀZ),簇之间的连接 = 成员之间的连接按比例加起来(SᵀAS)。
一步一步看
目标:先看课件里四个矩阵的形状,再用四节点链手算硬分配和软分配,看 A’ 和 X’ 怎样把节点并成簇。
先看课件的形状,再用一条四节点链手算。
-
课件:5 个节点合成 4 个簇。A 是 5×5,X 是 5×3;Z 是 5×12,S 是 5×4;X’ 是 4×12,A’ 是 4×4。
-
手算用四节点链 1-2-3-4,先用「硬分配」:1、2 进簇 c1,3、4 进簇 c2,S 每行只有一个 1。
-
算 A’ = SᵀAS(A 不加自环)。对角线 2:簇内有 1 条边,两个方向各算一次。非对角 1:两簇之间只有 2-3 这 1 条边。
-
算 X’ = SᵀZ。设 Z 的四行是 [1, 0]、[3, 2]、[0, 1]、[2, 2],每个簇把成员的特征加起来:c1 = [4, 2],c2 = [2, 3]。
-
真正的 DiffPool 里 S 来自 softmax,是软分配。比如节点 2 一半进 c1、一半进 c2,A’ 就变成 [1, 1] / [1, 3]:边按比例分到两个簇上。
怎么算
Z = GNN₁(A, X),S = softmax(GNN₂(A, X)),X’ = SᵀZ,A’ = SᵀAS
意思是:S 的第 i 行是节点 i 分到 K 个簇的比例,softmax 保证每行加起来是 1(softmax 怎么算见 L03a-4)。Sᵀ 的第 k 行列出每个节点对簇 k 的比例,乘 Z 就是把成员特征按比例加起来。A’ 的第 k 行第 l 列,是簇 k 的成员和簇 l 的成员之间所有边按比例加权的和。
维数:(K×N)(N×F’) = K×F’;(K×N)(N×N)(N×K) = K×K。
常见误解
以为 softmax 是对每一列(每个簇)做的
课件写 softmax is applied on the 4 new clusters:对每个节点(每一行),在 4 个簇上做 softmax,所以每一行加起来是 1。
以为新特征长度一定等于旧特征长度
X’ 的列数等于 GNN₁ 的输出长度,可以自己定。课件里旧特征 3 个数,新特征 12 个数。
以为 A' 只有 0 和 1
A’ 是按比例加权的和,可以出现 2、3,软分配时还会有小数。它记录的是簇之间连接的强弱。
试一下
N = 6 个节点合成 K = 2 个簇,GNN₁ 输出长度 5。S、X'、A' 各是什么形状?
S 是 6×2,X’ = SᵀZ 是 (2×6)(6×5) = 2×5,A’ = SᵀAS 是 (2×6)(6×6)(6×2) = 2×2。
3. 整讲串起来:图分类的流程
它解决什么问题
前面学了 GCN 层和 DiffPool 层,还要知道怎么把它们组装成能做图分类的整个网络。课件最后的 take-home message 第 5 条写的是 stack multiple layers ???,这一节把它补完整。
直觉
GCN 层负责「交流」,DiffPool 负责「合并」。交替做下去,图从 5 个节点变 4 个,再变更少,直到剩 1 个节点,它的特征就代表整张图。
一步一步看
目标:把 GNN 和 DiffPool 交替排成一条流水线,看图怎样缩到一个节点交给分类器,分组又怎样跟着学。
-
第 0 层:GNN(A⁰, X⁰) 更新节点特征,DiffPool 得到更小的 (A¹, X¹)。
-
第 1 层:GNN(A¹, X¹) 再更新,DiffPool 再缩小,得到 (A², X²)。
-
重复到只剩一个节点,把它的特征交给全连接层判断类别。
-
整个网络每一步都能求梯度,所以分类损失可以一路反向传到 GNN₁、GNN₂ 的参数,分组方式也跟着学。
怎么判断
拿到一个图任务,按顺序判断:
- 每个节点一个答案(节点分类):堆两层 GCN,中间 ReLU,最后 sigmoid,见 L08c。
- 整张图一个答案(图分类):GCN 和 DiffPool 交替,池化到一个节点后接分类器。
- 预测两点之间有没有边(连边预测):课件只列了这类任务,没展开具体做法。
常见误解
以为分组方式要人工事先定好
S 由 GNN₂ 算出来,GNN₂ 的参数和整个网络一起训练。分组方式是学出来的。
以为池化一次就要缩到一个节点
课件的图是一级一级缩小的,每级合并一部分节点,层级结构保留了图在不同尺度上的信息。
试一下
一张 5 个节点的图,第一次 DiffPool 合成 4 个簇,第二次合成 1 个簇。第二次的 S 是什么形状?每一行是什么?
第二次输入 4 个节点,输出 1 个簇,S 是 4×1。softmax 只在 1 个簇上做,每行都是 1:所有节点全部进这一个簇。
把它们串起来
GCN 层只改特征,不改节点个数,做节点分类够用;做图分类就要池化。DiffPool 用两个 GNN 同时看图:GNN₁ 给新特征 Z,GNN₂ 经 softmax 给分配矩阵 S。
有了 S,新特征 X’ = SᵀZ 把成员特征按比例加到簇上,新邻接矩阵 A’ = SᵀAS 把成员之间的边按比例加到簇之间。课件里 5 个节点变成 4 个簇,特征长度从 3 变成 12。
把 GNN 和 DiffPool 交替堆叠,图一级级缩小到一个节点,再接分类器,就是课件最后给出的图分类流程。
课件里的坑
- [课件有误] p.24 的 Objective 框写第 i+1 层 Xⁱ⁺¹ 是 (4×3),p.25 同一个框写 (4×12)。特征长度是自定的,按 p.25 的算法,Xⁱ⁺¹ 的列数等于 GNN₁ 的输出长度 12,应为 4×12。
- [符号] p.24 的 A typical GNN layer 把 D̃⁻¹ÃD̃⁻¹(平均两次)的矩阵标成 A 送进 GNN,和 p.21 GCN 用的  不是同一个矩阵。两者都是归一化写法,课件没交代为什么换。
- [缺字] p.28 第 5 条写 stack multiple layers ???。按 p.21 和 p.26:节点分类堆两层 GCN;图分类时 GCN 和 DiffPool 交替堆叠,池化到一个节点后接分类器。
- [省略] p.28 第 6 条 How to implement? 只有问题没有答案,课件没给代码。
课后 10 分钟:考点复习
这 10 分钟怎么用:先默写 DiffPool 的四个公式和形状;再在四节点链上算一遍 SᵀAS 和 SᵀZ;最后口述节点分类和图分类的网络各怎么搭。
必背
- GCN 层不缩小图(The graph size is not reduced),图分类需要池化把节点合并。
- DiffPool 的嵌入矩阵 Z = GNN₁(A, X),形状 N×F’,F’ 是自己定的新特征长度。
- 分配矩阵 S = softmax(GNN₂(A, X)),形状 N×K,softmax 在 K 个新簇上做,每行加起来是 1。
- 新特征 X’ = SᵀZ,形状 K×F’。
- 新邻接矩阵 A’ = SᵀAS,形状 (K×N)(N×N)(N×K) = K×K。
- 图分类:GNN 和 DiffPool 交替堆叠,图越缩越小,最后接分类器。
课件例题
例 1(课件 p.25):DiffPool 各矩阵的维数
题面:第 i 层 A 是 5×5、X 是 5×3,新图 4 个节点,新特征长度 12。写出 Z、S、Xⁱ⁺¹、Aⁱ⁺¹ 的形状。
提示
Z 和 S 的行数是旧节点数;X’ 和 A’ 的行数是新节点数。
解答
Z 是 5×12,S 是 5×4;Xⁱ⁺¹ = SᵀZ 是 (4×5)(5×12) = 4×12;Aⁱ⁺¹ = SᵀAS 是 (4×5)(5×5)(5×4) = 4×4。
例 2(课件 p.23、p.26):为什么要池化,怎么用于图分类
题面:说明 GCN 层为什么不能直接做图分类,以及 DiffPool 怎么接进网络。
提示
看 p.23 的红字和 p.26 的流程。
解答
GCN 层不缩小图,输出仍是每个节点一行。图分类时 GNN 和 DiffPool 交替:GNN(A⁰, X⁰) → DiffPool → GNN(A¹, X¹) → DiffPool → …,最后接分类器。
完整例题
自编情境。四节点链 1-2-3-4,A(不加自环)= 0 1 0 0 / 1 0 1 0 / 0 1 0 1 / 0 0 1 0。分配 S = 1 0 / 1 0 / 0 1 / 0 1,Z 的四行是 [1, 0]、[3, 2]、[0, 1]、[2, 2]。求 X’ 和 A’。
- Sᵀ = 1 1 0 0 / 0 0 1 1:第 1 行挑出节点 1、2,第 2 行挑出节点 3、4。
- X’ = SᵀZ:c1 = [1, 0] + [3, 2] = [4, 2],c2 = [0, 1] + [2, 2] = [2, 3]。
- AS:每行把节点的邻居按簇数一下。节点 1 的邻居 2 在 c1,得 [1, 0];节点 2 的邻居 1、3 得 [1, 1];节点 3 的邻居 2、4 得 [1, 1];节点 4 的邻居 3 得 [0, 1]。
- Sᵀ(AS):c1 = [1, 0] + [1, 1] = [2, 1],c2 = [1, 1] + [0, 1] = [1, 2]。
答案:X’ = [4, 2] / [2, 3],A’ = [2, 1] / [1, 2]。
要点:SᵀZ 是按簇把成员特征加起来;SᵀAS 的对角线数簇内边(两个方向各一次),非对角数簇间边。
答题格式:先写 Sᵀ,再写 SᵀZ;A’ 先算 AS 再左乘 Sᵀ,每步写出至少一行。
变式题(先自己做)
(1) 改编自课件 p.25:N = 8,K = 3,GNN₁ 输出长度 16。写出 Z、S、X’、A’ 的形状。 (2) 自编情境:同一条四节点链,S 改成 1、2、3 进 c1,4 进 c2。求 A’。 (3) 自编情境:S 的某一行是 [0.7, 0.2, 0.1],这一行说明什么?
提示
(1) 按 N×F’、N×K、K×F’、K×K 填。(2) 数 c1 内部几条边、c1 和 c2 之间几条边。(3) softmax 输出。
判分点与答案(非官方评分标准)
判分点:① 形状写对;② A’ 对角线按两个方向数;③ 说出「比例、加起来为 1」。
- (1) Z 8×16,S 8×3,X’ 3×16,A’ 3×3。
- (2) c1 内有 1-2、2-3 两条边,对角 2×2 = 4;c1 和 c2 之间只有 3-4 一条边;c2 内没有边。A’ = [4, 1] / [1, 0]。
- (3) 这个节点 70% 分到第 1 个簇、20% 到第 2 个、10% 到第 3 个,三者加起来是 1;它的特征和连接按这个比例分到三个簇上。
闪卡自测
1. 为什么图分类需要池化?
GCN 层不缩小图,整张图要一个答案,需要把节点合并(p.23)。
2. DiffPool 的 Z 怎么算?形状?
Z = GNN₁(A, X),课件里 5×12(p.25)。
3. S 怎么算?softmax 在哪个方向?
S = softmax(GNN₂(A, X)),每一行在 K 个新簇上做 softmax(p.25)。
4. 新特征怎么算?
X’ = SᵀZ,课件里 4×12(p.25)。
5. 新邻接矩阵怎么算?
A’ = SᵀAS,(4×5)(5×5)(5×4) = 4×4(p.25)。
6. 新节点数和新特征长度由谁定?
自己定,课件称 self-defined(p.24)。
7. 图分类网络怎么搭?
GNN 和 DiffPool 交替堆叠,最后接分类器(p.26)。
8. GNN 能做哪三类任务?
节点分类、图分类、连边预测(p.28)。
下一讲
图神经网络这一讲到这里结束。下一讲 L09a 进入无监督学习:数据没有标签时,用自编码器把输入压成一份短编码再还原回来。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。