L08c 一层 GCN 逐步手算,再叠成两层做节点分类
一层 GCN 就是 ReLU(ÂXW):先用归一化邻接矩阵 Â 聚合邻居,再乘所有节点共用的权重 W,最后过 ReLU。这一页在一条三节点的链上把每一步的数字算出来,再讲两层 GCN 怎么输出类别、怎么算损失。
一句话版
一层 GCN 做三件事:用 Â 让每个节点按权重收集自己和邻居的特征,乘一个所有节点共用的权重矩阵 W,再过 ReLU。叠两层,最后接 sigmoid,就能给每个节点输出一个类别概率。
上一页 L08b 讲了 Â 怎么来,这一页把它接进一层完整的网络。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| GCN | Graph Convolutional Network | 在图上做「收集邻居 + 变换」的网络 |
| Â | A-hat | 归一化邻接矩阵 D̃^-1/2 Ã D̃^-1/2 |
| W | weight | 可学习的权重矩阵,所有节点共用 |
| shared dense layer | 共享全连接层 | 同一个 W 作用在每个节点上 |
| ReLU | 修正线性单元 | 负数变 0,正数不变 |
| H | hidden | 一层 GCN 的输出,每个节点一行新特征 |
一个类比:开会再写报告
每个人先听自己和邻座的发言,按「谁的人缘广就打点折扣」加权记下来(Â 乘 X)。然后所有人用同一张评分表把笔记换算成新的几个分数(乘 W)。负分一律记 0(ReLU)。
开两轮会,每个人听到的就不只是邻座,还有邻座的邻座。第二轮结束后,每人报一个「支持 / 不支持」的概率(sigmoid)。
类比在哪里失效:
- 现实里每个人的评分表可以不同,GCN 里所有节点共用同一个 W,这是它参数少的原因。
- 开会的人会主动挑重点听,GCN 的权重只由度决定,和发言内容无关。按内容挑重点是 attention 的做法,见 L07e。
从零讲起
1. 先准备 Â:在三节点链上算一遍
它解决什么问题
一层 GCN 的公式里有 Â,手算之前要先把它算出来。课件的五节点图手算量太大,这里用一条三节点的链 A-B-C,每一步都能在纸上算完。Â 只和图的结构有关,同一张图上只需算一次,每一层都能复用。
直觉
 的每一格只看两件事:两个节点之间有没有连(含自环),以及两端各自的 d̃。
有连就填 1/√(d̃_i × d̃_j),没连就是 0。两端越「热闹」,权重越小。
一步一步看
目标:在三节点链上从邻接矩阵一路算到 Â,看它左右对称,行和接近 1 但不正好等于 1。
-
写出链 A-B-C 的邻接矩阵 A,再加单位矩阵得到 Ã,对角线变成 1。
-
数 Ã 每行 1 的个数,得到 d̃ = (2, 3, 2)。再取「1 除以平方根」:D̃^-1/2 的对角线约 0.707、0.577、0.707。
-
逐格填 Â:A-A 是 1/√(2×2) = 0.5,A-B 是 1/√6 ≈ 0.408,B-B 是 1/3 ≈ 0.333;A 和 C 没连,保持 0。
-
检查:Â 对称,A 行和 C 行一样;行和约 0.908、1.150、0.908,在 1 附近但不正好是 1。
怎么算
Â[i][j] = Ã[i][j] / √(d̃_i × d̃_j)
意思是:先看 Ã 里 i、j 这一格是不是 1,是 1 才有权重;权重等于 1 除以两端度数乘积的平方根。等价写法是 Â = D̃^-1/2 Ã D̃^-1/2:左乘每行除以 √d̃_i,右乘每列除以 √d̃_j。
常见误解
以为每一层 GCN 都要重新算 Â
 只由图的连接决定。图不变, 就不变,两层 GCN 用的是同一个 Â。每层不同的是 W。
以为 D̃^-1/2 是 D̃⁻¹ 再除以 2
是取平方根再取倒数。d̃ = 2 时,D̃^-1/2 的对角线是 1/√2 ≈ 0.707,不是 1/4。
试一下
如果链变成 A-B-C-D(四个节点),B-C 这一格的 Â 是多少?
B、C 各有 2 个邻居,加自环后 d̃ 都是 3。B-C = 1/√(3×3) = 1/3 ≈ 0.333。
2. 一层 GCN:ÂX、乘 W、过 ReLU
它解决什么问题
只做 ÂX,每个节点得到的是邻居特征的加权和,没有可学习的东西,网络什么也学不会。GCN 在后面接一个可学习的权重 W 和激活函数,和 MLP 的一层一样,让网络能学「哪些特征组合对分类有用」。MLP 的一层怎么算,见 L04a。
直觉
一层 GCN = 先在图上做一次邻居聚合,再对每个节点各自做一次全连接层。
关键在「共享」:所有节点用同一个 W。所以参数个数只和特征长度有关,和图里有几个节点无关,这和 CNN 卷积核在所有位置共用是一个思路。
一步一步看
目标:用三节点链依次算 ÂX、乘 W、过 ReLU,看一层 GCN 后节点数不变,每个节点换了一组新特征。
继续用上一节的 Â,特征 X 的三行是 A [1, 0]、B [0, 1]、C [1, 1],权重 W 是 [1, 1] / [-1, 0]。
-
ÂX:B 行第 1 个数 = 0.408×1 + 0.333×0 + 0.408×1 ≈ 0.816;第 2 个数 = 0.408×0 + 0.333×1 + 0.408×1 ≈ 0.741。
-
乘 W:这个 W 让新的第 1 列 = 旧第 1 列 − 旧第 2 列,新的第 2 列 = 旧第 1 列。C 行第 1 列 = 0.5 − 0.908 = −0.408。
-
过 ReLU:负数变 0,只有 C 行第 1 列被截成 0。
-
结果 H 还是 3 行:节点个数没变,每个节点换了一组新特征。
怎么算
H = ReLU(Â X W)
意思是: 负责「从谁那里收集、各占多少」,X 是每个节点现有的特征,W 负责「把特征换算成新的几个数」,ReLU 把负数截成 0。维数上, 是 N×N,X 是 N×F,W 是 F×F’,结果 H 是 N×F’:N 不变,特征长度从 F 变成 F’。ReLU 的作用见 L05b。
课件写法是 D̃^-1/2 Ã D̃^-1/2 X W,再过 ReLU,称 W 为 a shared dense layer。
常见误解
以为每个节点有自己的一套 W
所有节点共用同一个 W,课件特地写了 shared。节点之间的差别全部来自 Â(连接不同)和 X(特征不同)。
以为先乘 W 再乘 Â 会得到不同的结果
矩阵乘法满足结合律,Â(XW) = (ÂX)W,结果一样,ReLU 必须放在最后。实际实现常先算 XW,因为特征长度变短后再乘 Â 更省计算。
以为 GCN 层会把图变小
H 的行数和 X 一样,节点个数不变。想把图变小要靠下一页的池化。
试一下
换成 W = [1, 0] / [0, 1](单位矩阵),这一层的输出 H 是多少?
ÂXW = ÂX,三行都没有负数,ReLU 不改变:H = [0.5, 0.408] / [0.816, 0.741] / [0.5, 0.908]。
3. 两层 GCN 和节点分类
它解决什么问题
一层 GCN 只能让节点看到直接相连的邻居。很多时候邻居的邻居也有用:朋友的朋友支持谁,也有参考价值。叠第二层,每个节点就能间接拿到两步以内所有节点的信息。最后还要把特征变成一个类别概率,并定一个损失函数来训练。
从哪来(补充)
Kipf 和 Welling 的 GCN 论文题目就是 Semi-Supervised Classification with Graph Convolutional Networks,任务是半监督的节点分类:图里只有一部分节点带标签。课件 A、B、C 有标签、D、E 没有,正是这种设定。
直觉
第一层:Â 聚合一次,乘 W⁰,过 ReLU,得到隐藏特征。
第二层:同一个 Â 再聚合一次,乘 W¹,过 sigmoid,每个节点得到一个 0 到 1 之间的概率。第二层收集的是邻居第一层的结果,而那些结果里已经混了邻居的邻居。
一步一步看
目标:把两层 GCN 的流程写成公式再放进课件例子,看只用有标签的节点训练,怎样读出 D、E 的预测。
-
课件的图把流程画成 Input → Hidden layer → ReLU → Hidden layer → sigmoid → Output。
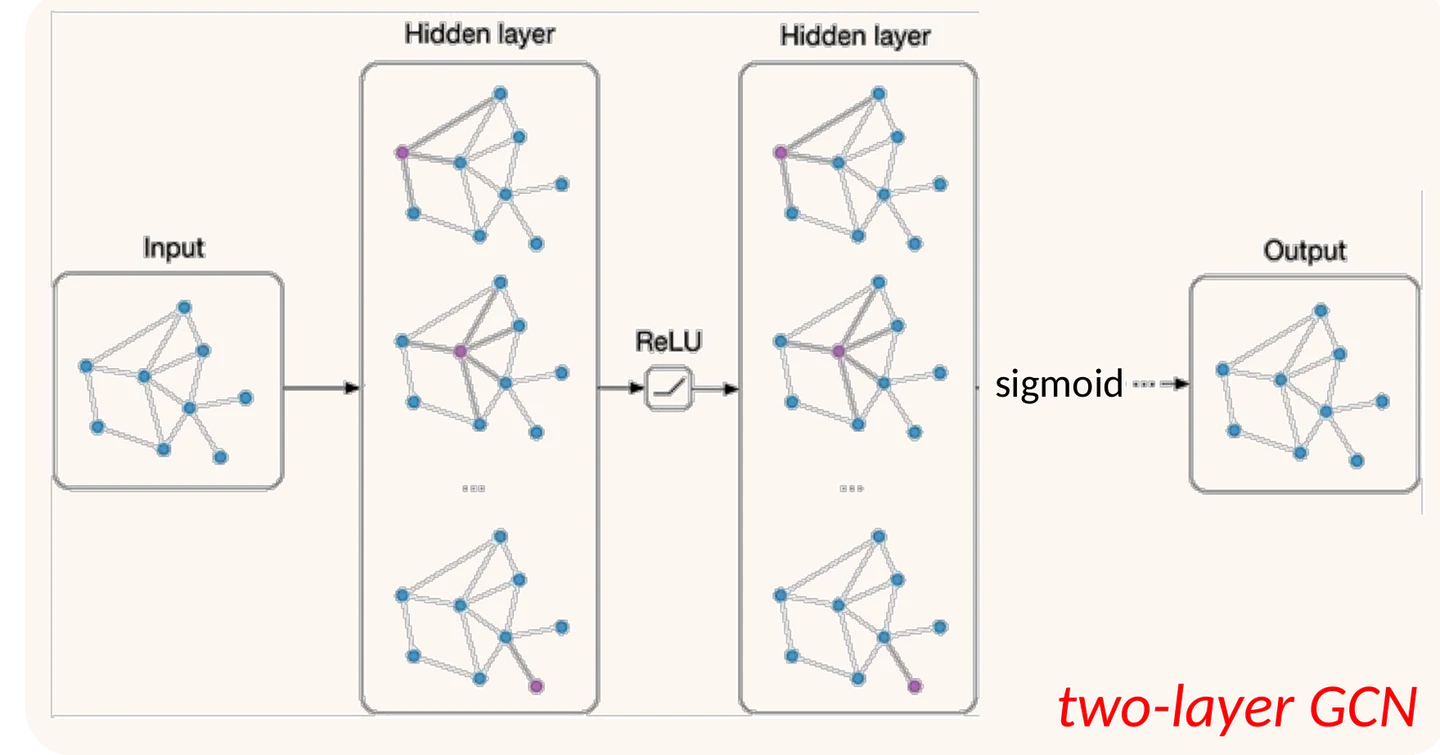
图片来源:COMP5541 Lecture 8 课件, p.21 -
写成公式就是 y = sigmoid(Â ReLU(ÂXW⁰) W¹),同一个 Â 用两次,W⁰ 和 W¹ 各是一组参数。
-
课件的例子里 A、B、C 有标签,D、E 没有。训练时只把 A、B、C 的交叉熵加进损失。
-
训练好以后,把整张图再跑一遍前向,读出 D、E 的 y,就是对它们的预测。
怎么算
y = sigmoid(Â ReLU(ÂXW⁰) W¹),损失 = Σ(有标签的节点 i)交叉熵(y_i, 标签_i)
意思是:先按上一节算出第一层的输出,再把它当作新的 X 送进第二层,最后用 sigmoid 把每个节点的分数压到 0 到 1。损失只在有标签的节点上累加,每个节点的交叉熵就是二分类逻辑回归的那一个,见 L03a。
常见误解
以为两层 GCN 只用到直接邻居的信息
第二层收集的是邻居的第一层输出,那里面已经有邻居的邻居,所以两层能看到两步以内的节点。
以为没有标签的节点不参与训练
它们不进损失,但仍在图里参与聚合:它们的特征会通过 Â 传给有标签的节点,影响那些节点的输出和梯度。
试一下
五节点图,X 是 5×3,W⁰ 是 3×4,W¹ 是 4×1。第一层输出和 y 各是什么形状?
第一层:(5×5)(5×3)(3×4) = 5×4。第二层:(5×5)(5×4)(4×1) = 5×1,每个节点一个概率。
把它们串起来
一层 GCN 是 ReLU(ÂXW)。Â 由图决定,负责「从谁那里收集、各占多少」;W 是所有节点共用的可学习参数,负责把特征换算成新的长度;ReLU 截掉负数。
在三节点链上, 是 0.5、0.408、0.333 这几个数拼成的对称矩阵。乘上 X 和 W 再过 ReLU,三个节点各得到一组新特征,节点个数不变。
叠两层,中间 ReLU、最后 sigmoid,就是课件的两层 GCN。损失只在有标签的节点上算交叉熵,没标签的节点照样参与聚合。
课件里的坑
- [符号] p.20 的 W 和 p.21 的 W⁰、W¹ 是同一类东西:p.20 只画一层,p.21 两层各有一组。课件没特地说明。
- [省略] p.21 只写 cross-entropy loss on each node,没说没标签的 D、E 怎么处理。按 p.14 的设定,损失只算有标签的节点,D、E 训练后再预测。
- [省略] p.21 图里节点特征从 3 个数变成 4 个数,说明 W 可以改变特征长度,课件没有写出 W 的形状。
课后 10 分钟:考点复习
这 10 分钟怎么用:先不看图在三节点链上算一遍 Â;再算 ÂX、ÂXW、ReLU;最后默写两层 GCN 公式,说出每个矩阵的形状。
必背
- 一层 GCN:H = ReLU(ÂXW), := D̃^-1/2 à D̃^-1/2。
- Â 的第 i 行第 j 列 = Ã[i][j] / √(d̃_i d̃_j),只由图的结构决定。
- W 是 shared dense layer:所有节点共用同一组参数,W 的列数决定新特征的长度。
- GCN 层只改每个节点的特征,不改节点个数。
- 两层 GCN:y = sigmoid(Â ReLU(ÂXW⁰) W¹)。
- 训练时在每个有标签的节点上算交叉熵损失,再加起来。
课件例题
例 1(课件 p.20):一层 GCN 的写法
题面:写出带共享全连接层的一层 GCN。
提示
在修正平均的写法后面乘 W,再过激活。
解答
ReLU(D̃^-1/2 Ã D̃^-1/2 X W),W 是所有节点共用的 shared dense layer。
例 2(课件 p.21):两层 GCN
题面:写出两层 GCN 的输出公式,并说明损失怎么算。
提示
第一层 ReLU,第二层 sigmoid;同一个 Â。
解答
y = sigmoid( ReLU(ÂXW⁰) W¹), := D̃^-1/2 à D̃^-1/2。在每个有标签的节点上算交叉熵,再相加。
完整例题
自编情境。用正文的三节点链 A-B-C,X 的三行是 [1, 0]、[0, 1]、[1, 1],W = [1, 1] / [-1, 0]。求一层 GCN 的输出 H。
- Ã = 1 1 0 / 1 1 1 / 0 1 1,d̃ = (2, 3, 2)。
- Â:A-A = C-C = 1/2 = 0.5,A-B = B-C = 1/√6 ≈ 0.408,B-B = 1/3 ≈ 0.333,A-C = 0。
- ÂX:A 行 = 0.5×[1, 0] + 0.408×[0, 1] = [0.5, 0.408];B 行 ≈ [0.816, 0.741];C 行 = 0.408×[0, 1] + 0.5×[1, 1] = [0.5, 0.908]。
- ÂXW:每行 [p, q] 变成 [p − q, p]。A = [0.092, 0.5],B = [0.075, 0.816],C = [−0.408, 0.5]。
- ReLU:C 行第 1 个数变 0。
答案:H ≈ [0.092, 0.5] / [0.075, 0.816] / [0, 0.5]。
要点:先算 Â 再算 ÂX;W 对每一行做同样的换算;ReLU 最后做。
答题格式:依次写 Ã、d̃、Â、ÂX、ÂXW、H,每步写出至少一行的算式。B 行第 2 个数用三位小数算是 0.741,精确值约 0.7416,写哪个都算对。
变式题(先自己做)
(1) 改编自课件 p.20:同一条链,X 不变,W = [0, 1] / [1, 0],求 H。 (2) 改编自课件 p.21:五节点图,X 是 5×3,想让第一层输出每个节点 8 个数,W⁰ 是什么形状? (3) 自编情境:用一层 GCN 时,A 的输出会受到 C 的特征影响吗?两层呢?
提示
(1) 这个 W 把两列对调。(2) 看 XW 的形状。(3) A 和 C 隔着 B。
判分点与答案(非官方评分标准)
判分点:① 先 ÂX 后乘 W;② 形状写成 行×列;③ 说出两层能看到两步以内的节点。
- (1) ÂXW 把 ÂX 两列对调:[0.408, 0.5] / [0.741, 0.816] / [0.908, 0.5],都是正数,H 就是它。
- (2) X 是 5×3,要得到 5×8,W⁰ 是 3×8。
- (3) 一层不会:Â 的 A-C 格是 0。两层会:第二层 A 收集 B 的第一层输出,而那里面有 C 的特征。
闪卡自测
1. 一层 GCN 的公式?
H = ReLU(ÂXW), := D̃^-1/2 à D̃^-1/2(p.20–21)。
2. 课件怎么称呼 W?
a shared dense layer,所有节点共用(p.20)。
3. 三节点链 A-B-C 的 Â 的 A-B 格?
1/√(2×3) = 1/√6 ≈ 0.408。
4. Â 每层要重新算吗?
不用,图不变 Â 就不变,每层不同的是 W。
5. GCN 层会改变节点个数吗?
不会,只改每个节点的特征长度。
6. 两层 GCN 的公式?
y = sigmoid(Â ReLU(ÂXW⁰) W¹)(p.21)。
7. 两层 GCN 的损失怎么算?
每个有标签的节点算交叉熵,加起来(p.21)。
8. 没有标签的节点在训练中有什么作用?
不进损失,但通过 Â 把特征传给邻居,参与聚合。
下一讲
GCN 层不改节点个数,可图分类要的是整张图一个答案。下一页 L08d 讲图池化 DiffPool:用一个分配矩阵把节点合成簇,一层层把图缩小。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。