L09a 无监督学习与自编码器:没有标签时学什么
数据没有标签,模型还能学:聚类、降维、密度估计、自监督学习。这一页先分清有监督和无监督的任务,再看自编码器怎么用编码器压缩、解码器还原、重构误差训练,以及中间的瓶颈为什么必须比输入窄。
一句话版
前八讲的数据都带标签,模型学「输入对应哪个答案」。这一讲开始,数据没有标签,模型只能从数据自己身上找规律:分成几团、压成更短的表示、学出数据的分布。
自编码器是最直接的一种做法:先把输入压短,再从短的那份还原回来,还原得越像越好。压短的那份就是模型学到的东西。
先认识这几个词
读之前最好记得全连接层和损失函数是什么,这门课前几讲都讲过。
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 有监督学习 | supervised learning | 每个训练样本都带标准答案 |
| 无监督学习 | unsupervised learning | 训练样本没有答案,只有数据本身 |
| 聚类 | clustering | 把相似的样本分到同一团 |
| 降维 | dimension reduction | 用更少的数表示一个样本 |
| 自编码器 | autoencoder,简称 AE | 先压缩再还原、拿自己当答案的网络 |
| 潜在表示 h | latent representation | 自编码器中间那份压短的编码 |
| 瓶颈层 | bottleneck | 网络里最窄的那一层 |
一个类比:给朋友发一段压缩过的描述
你看到一张照片,要用一条很短的短信描述给朋友,朋友只看短信把照片画出来。你写的短信越抓重点,朋友画得越像。
写短信的人是编码器,短信是潜在表示 h,照着短信画画的朋友是解码器。最后把画和原照片一比,差多少就说明短信漏了多少。
类比在哪里失效:
- 现实中你已经会写短信。自编码器的编码器和解码器一开始都什么也不会,两边是一起练出来的。
- 短信用的是人能读的字。h 只是几个数,人通常看不出每个数代表什么。
- 朋友可以靠常识补细节。解码器只能用训练时见过的规律来补,没见过的东西画不出来。
从零讲起
1. 有监督和无监督
它解决什么问题
给每张图片标上「猫」「狗」要花大量人力,很多数据根本没人标。没有标签时,分类和回归都做不了,需要另一类任务,让模型从数据本身学到有用的结构。
直觉
有监督像做带答案的练习册,每题做完对一下答案。无监督像只给你一堆题、不给答案,你只能自己看出哪些题是同一类型、哪些题的关键信息是什么。
课件把无监督任务分成四类。聚类是分团,降维是压短,密度估计是学「什么样的数据常见」,自监督是自己从数据里造出答案来练。
一步一步看
目标:对照课件左右两栏,分清两种学习各做什么任务,再把四类无监督任务各对上一个方法。
-
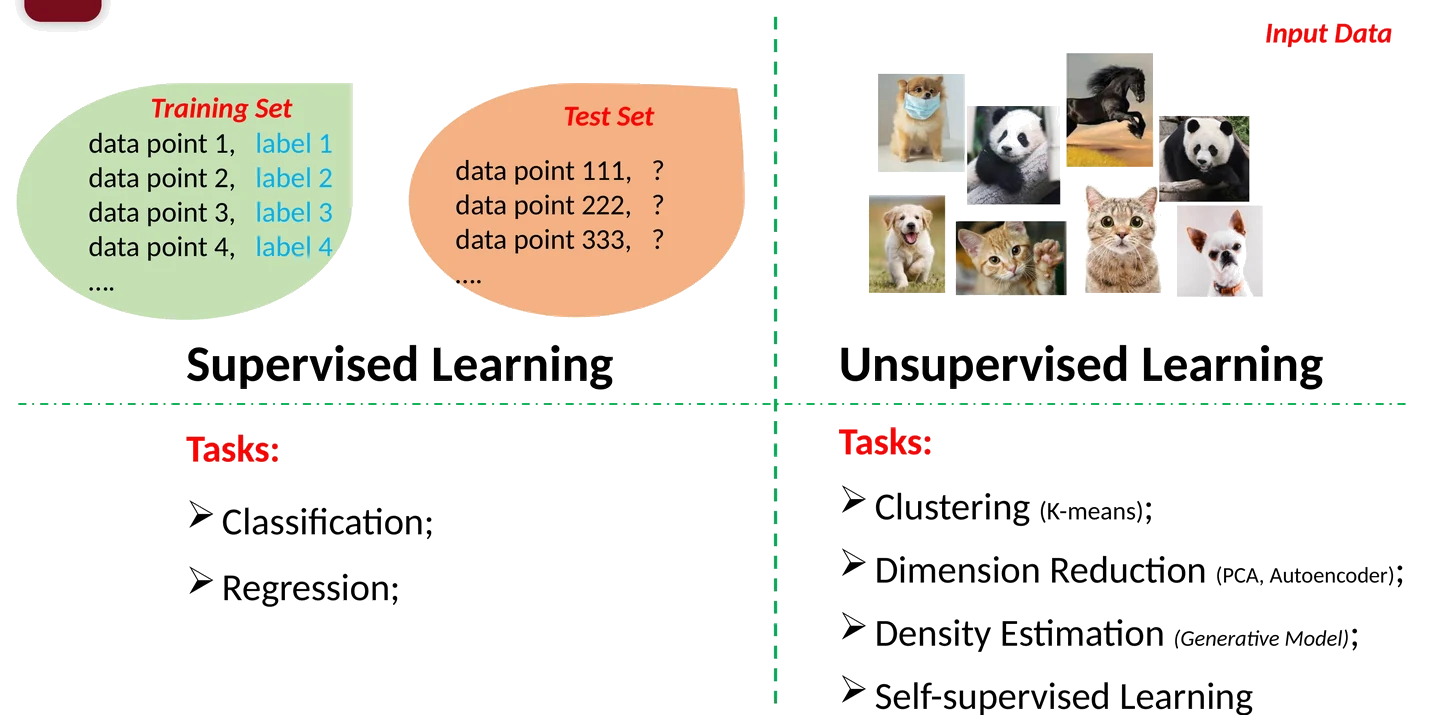
左栏有监督:训练集是 data point 1–4,各配 label 1–4;测试集的数据点标签是问号,要模型预测。
图片来源:COMP5541 Lecture 9 课件, p.8 -
有监督的任务只有两类:答案是类别就是分类,答案是数值就是回归。
-
右栏无监督:输入是一堆动物图片,一张标签也没有。
-
四类任务各对一个方法:聚类用 K-means,降维用 PCA 或自编码器,密度估计用生成模型,最后一类是自监督学习。
-
课件下一页配了两张图:K-means 把平面上的点分成 3 团;PCA 把二维的点投到一条直线上,二维降成一维。
怎么判断
先看训练数据有没有标签,再看要的结果是什么。
意思是:有标签、要预测类别或数值,是有监督;没有标签、要分团,是聚类;没有标签、要用更少的数表示样本,是降维;要学出数据长什么样、能生成新样本,是密度估计。
常见误解
以为无监督学习就是聚类
聚类只是四类之一。课件还列了降维、密度估计和自监督学习,这一讲的自编码器属于降维。
以为没有标签就没有损失函数
无监督学习照样要有损失函数,只是损失不拿标签来算。自编码器的损失比较的是还原结果和输入本身。
试一下
一家网店有 10 万个用户的购买记录,没有任何标签,想把用户分成几群做推荐。这是哪类任务?
数据没有标签,要分群,是无监督学习里的聚类,可以用 K-means。
2. 自编码器:编码、解码、损失
它解决什么问题
想把一张图压成几个数,但没有人告诉你「这张图该压成哪几个数」。自编码器的办法是:随便你怎么压,只要能从压好的数还原出原图就行。这样就不需要标签了。
从哪来(补充)
用一个单隐层网络做降维的想法很早就有:1982 年 Oja 指出 PCA 等价于一个单隐层网络,1989 年 Baldi 与 Hornik、1991 年 Kramer 把它推广成非线性 PCA。2006 年 Hinton 与 Salakhutdinov 在 Science 发表的论文里,用 30 个神经元的瓶颈做到了比 PCA 前 30 个主成分更好的重构。出处:Wikipedia: Autoencoder。
直觉
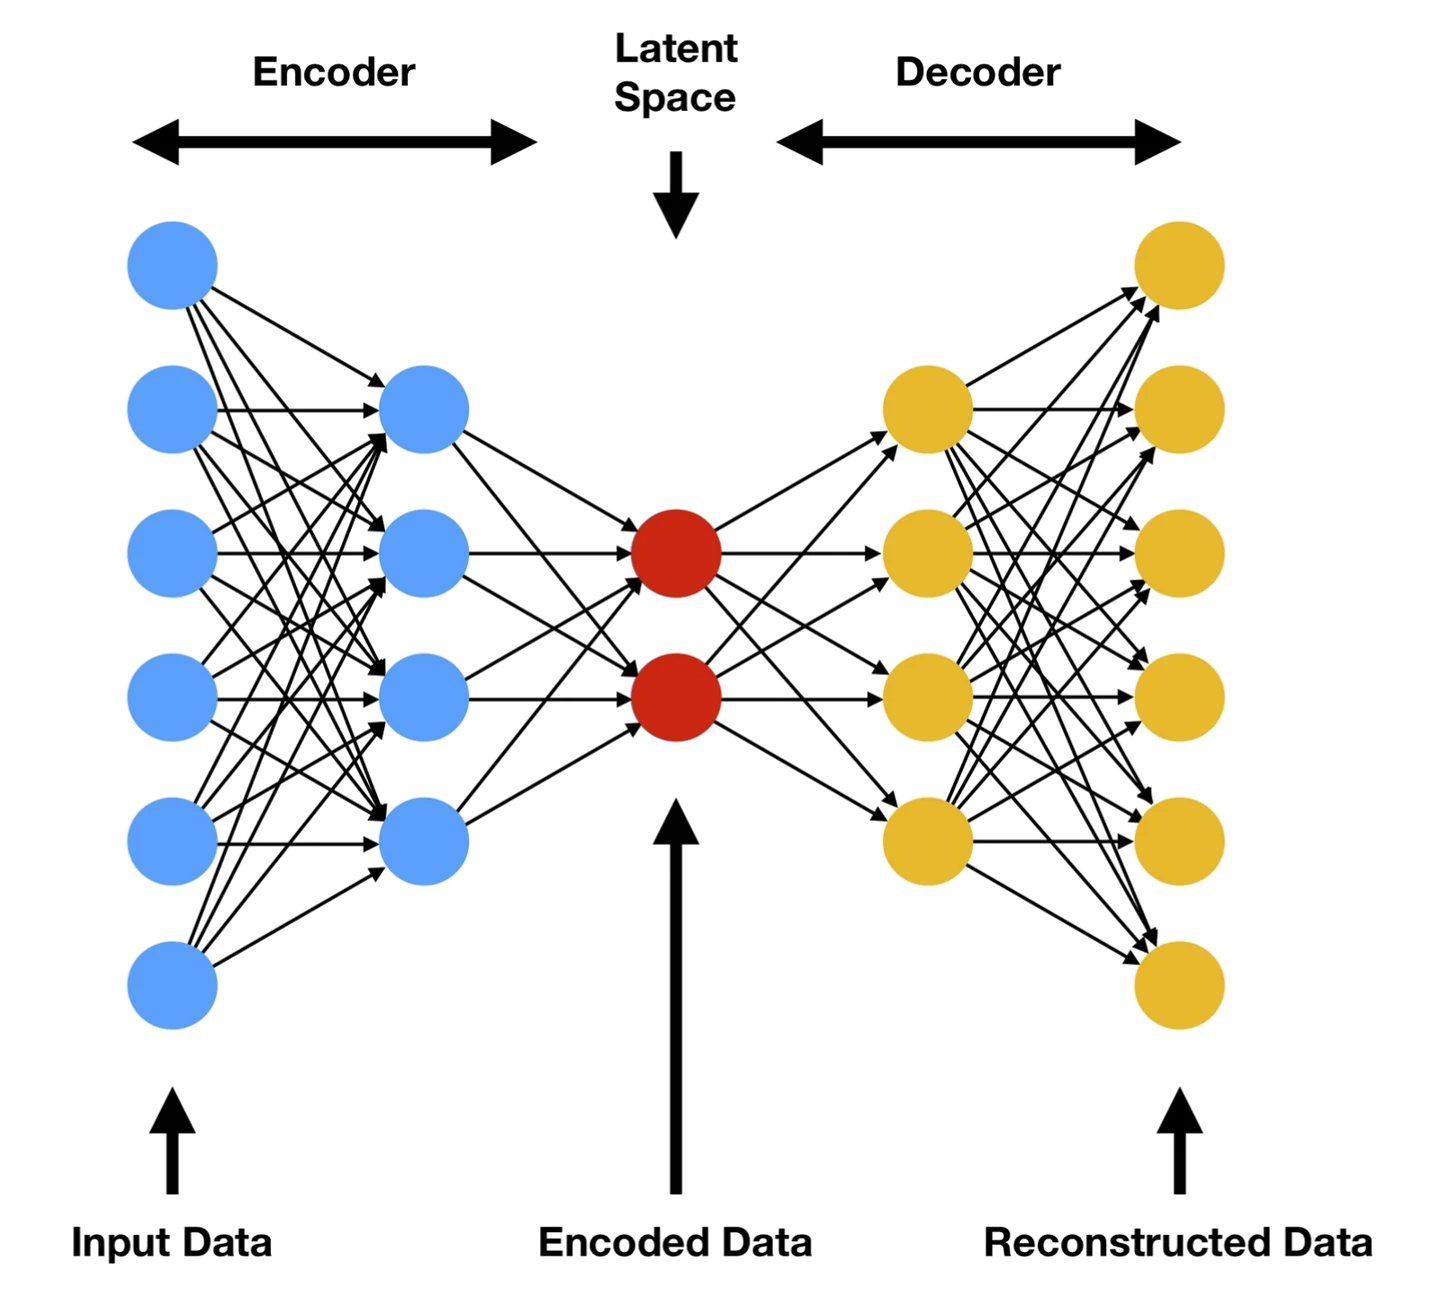
网络两头一样宽,中间窄。左半边叫编码器,把输入一层层压窄;右半边叫解码器,把窄的那份一层层放宽。
训练时把输入同时当成答案。输出和输入差得越少,说明中间那份编码留住的信息越多。
一步一步看
目标:用一个 6-4-2-4-6 的小网络依次走编码、解码、算损失三步,看清输入为什么能当答案。
-
课件的结构图:输入 6 个节点,经过 4 个节点,到中间 2 个红色节点,再经过 4 个节点,输出 6 个节点。
图片来源:COMP5541 Lecture 9 课件, p.11 -
编码:h = e(x),6 个数变成 2 个数。
-
解码:x’ = d(h),只拿这 2 个数还原出 6 个数。
-
算损失:x = (1, 0, 1, 0, 1, 0),假设还原出 x’ = (0.9, 0.1, 0.8, 0, 1, 0.2)。逐个相减、平方、相加得 0.10,开根号约 0.316。
-
反向传播把损失往回传,编码器和解码器的权重一起更新。整个过程没用到任何标签。
怎么算
h = e(x),x’ = d(h),ℓ = ||x’ − x||
意思是:e 是编码器,把输入 x 变成短的编码 h;d 是解码器,把 h 变回和 x 一样长的 x’;损失是 x’ 和 x 之差的长度,两者越接近损失越小。
课件写的是不带平方的范数。实际训练常用平方误差,两种写法在 x’ = x 时都取到最小值 0,考试按课件写法写即可。
常见误解
以为自编码器要的是输出 x'
还原出来的 x’ 只是训练用的,和原输入差不多,本身没多大用处。真正要的是中间的 h,它是输入的一份短编码,可以拿去做降维、聚类、当特征。
以为损失里的 x 是标签
x 就是输入本身。自编码器把输入同时当成要还原的目标,所以不需要额外的标签。
试一下
x = (2, 0, 1),还原出 x' = (2, 1, 1),按课件写法算损失。
差 = (0, 1, 0),长度 √1 = 1,所以 ℓ = 1。
3. 瓶颈层为什么要比输入窄
它解决什么问题
如果中间层和输入一样宽,网络有一个偷懒的办法:每个节点原样照抄一个输入,输出就和输入一模一样,损失为 0。这时网络什么规律也没学到。
直觉
让你把一篇文章原封不动抄一遍,你不用读懂它。让你用三句话转述,你就得先弄清哪些是重点。
瓶颈层就是那「三句话」的篇幅限制。比输入窄的自编码器叫 undercomplete autoencoder,课件选择题考的就是这一点。
一步一步看
目标:对比中间层和输入一样宽、比输入窄两种网络,看出照抄为什么在窄的网络里行不通。
-
中间层也是 6 个节点:三层之间各接一条一对一的线,输出等于输入,误差为 0。
-
中间层只有 2 个节点:6 个数放不进 2 个格子,照抄不了。
-
网络只能学一种压缩办法,让这 2 个数尽量多地留住还原需要的信息。
-
课件后面的卷积自编码器更极端:28×28 的图有 784 个数,中间只留 10 个。
| 中间层宽度 | 能不能照抄 | 学到什么 |
|---|---|---|
| 和输入一样宽 | 能 | 可能什么也学不到 |
| 比输入窄 | 不能 | 输入里最重要的特征 |
怎么判断
比一比中间层的宽度和输入的长度。
意思是:中间层的数比输入少,就是 undercomplete,网络被迫压缩;中间层的数不少于输入,网络就有可能照抄,要另加限制(这一讲不讲)。
常见误解
以为瓶颈层的作用是加噪声让模型更稳健
瓶颈层只是窄,不加噪声。往潜在空间里加随机性是下一讲 VAE 的做法,课件选择题的 C 选项就是拿这个当干扰项。
以为瓶颈越窄越好
太窄会丢掉还原必需的信息,重构误差降不下去。宽度是要调的超参数,课件的 MNIST 例子用的是 10。
试一下
一个自编码器输入 100 维,中间层 120 维。它算 undercomplete 吗?可能出什么问题?
不算,中间层比输入宽。网络有可能直接照抄输入,学不到有用的压缩。
把它们串起来
没有标签时,模型还能做四类事:聚类、降维、密度估计、自监督学习。自编码器属于降维,和 PCA 放在一起讲。
自编码器的训练不需要标签。编码器把输入压成短的 h,解码器从 h 还原输入,损失比较还原结果和输入本身。
能这样训练的前提是中间够窄。瓶颈比输入窄,网络就没法照抄,只能学会保留输入里最重要的特征,学到的 h 才有用。下一页把全连接换成卷积,看图片怎么一路缩到 10 个数,再放回原来的大小。
课件里的坑
- [公式] p.11 的损失写成 ||x’ − x||,没有平方。常见实现用平方误差(MSE),两者在 x’ = x 时同取最小值,作答按课件写。
- [留白] p.9 的 K-means 和 PCA 两张图只是示意,课件没有讲这两种算法的步骤,这一讲不作为考点。
- [留白] p.8 的密度估计(生成模型)和自监督学习,课件进度表排在后面两讲,这一讲只列名字。
课后 10 分钟:考点复习
这 10 分钟怎么用:先说出有监督和无监督各做哪些任务;再默写自编码器的三条公式,用一个小向量手算一次损失;最后用一句话讲清瓶颈层为什么要窄。
必背
- 有监督学习的数据带标签,任务是分类和回归;无监督学习的数据没有标签。
- 无监督学习的四类任务:聚类(K-means)、降维(PCA、Autoencoder)、密度估计(生成模型)、自监督学习。
- 自编码器三条公式:编码 h = e(x),解码 x’ = d(h),损失 ℓ = ||x’ − x||。
- 自编码器训练不用标签,输入自己就是要还原的目标;h 叫潜在表示(latent representation)。
- undercomplete 自编码器的瓶颈层比输入窄,逼网络学出输入最重要特征的压缩表示。
- 自编码器可以用全连接层、卷积层搭,解码器放大尺寸时用转置卷积层。
课件例题
例 1(课件 p.25):瓶颈层的作用
题面:What is the primary architectural purpose of the bottleneck layer in an undercomplete autoencoder? A. expand dimensions for linear classifiers;B. force a compressed low-dimensional representation of salient input features;C. introduce stochastic noise into the latent space;D. eliminate the need for nonlinear activations。
提示
undercomplete 的意思是中间层比输入窄。窄了会逼网络做什么?
解答
选 B。瓶颈比输入窄,网络没法照抄,只能学一份保留重要特征的低维表示。A 方向反了,瓶颈是缩小维数;C 是下一讲 VAE 往潜在空间加随机性的做法;D 和激活函数无关。
例 2(课件 p.27):无监督学习的应用场景
题面:Take-home 第 1 条:What are the application scenarios of unsupervised learning? 说出课件列的场景。
提示
p.27 列了三个,p.8 列了四类任务。
解答
p.27 写的是 clustering、density estimation、dimension reduction(聚类、密度估计、降维)。p.8 还多列一类 self-supervised learning(自监督学习)。
例 3(课件 p.8):有监督还是无监督
题面:判断下面各题属于哪种学习、哪类任务:(a) 已知房屋面积和成交价,预测新房价格;(b) 一堆没有标签的动物照片,按相似度分组;(c) 把 784 维的图片压成 10 维。
提示
先看有没有标签,再看结果是类别、数值、分组还是更短的表示。
解答
(a) 有监督,回归;(b) 无监督,聚类;(c) 无监督,降维,可以用 PCA 或自编码器。
例 4(课件 p.11):写出自编码器的三条公式
题面:写出 Encoder、Decoder、Loss 三条公式,并说明各符号的意思。
提示
编码器输出 h,解码器输出 x’,损失比较谁和谁?
解答
Encoder:h = e(x);Decoder:x’ = d(h);Loss:ℓ = ||x’ − x||。x 是输入,h 是潜在表示,x’ 是还原结果,损失是 x’ 和 x 之差的范数。
完整例题
自编情境。一个自编码器输入 4 维,层宽 4-2-4。输入 x = (1, 2, 0, 1),还原出 x’ = (1, 1, 0, 2)。(a) h 有几个数?(b) 按课件写法算损失。(c) 按平方误差算损失。(d) 它是 undercomplete 吗?
- 中间层宽 2,所以 h 有 2 个数。
- 差 x’ − x = (0, −1, 0, 1)。
- 平方和 = 0 + 1 + 0 + 1 = 2。
- 课件写法 ℓ = √2 ≈ 1.414。
- 平方误差 = 2(求平均则是 2 / 4 = 0.5)。
- 中间 2 维比输入 4 维窄,是 undercomplete。
答案:(a) 2 个;(b) 约 1.414;(c) 2;(d) 是。
要点:损失比较的是 x’ 和输入 x,不是标签;先求差、再平方相加、按要求开根号。
答题格式:先写差向量,再写平方和,最后写损失,并说明用的是范数还是平方误差。
变式题(先自己做)
(1) 改编自课件 p.11:把上题的 x’ 改成 (1, 2, 0, 1),损失是多少?这说明什么? (2) 自编情境:一个自编码器层宽 8-16-8,训练后损失接近 0。能说明它学到了好的特征吗? (3) 改编自课件 p.8:一家医院有大量没标注的 X 光片,想先学一份短编码,再交给少量标注数据训练分类器。前一步属于哪类任务、可以用什么模型?
提示
(1) 输出和输入一样时差是多少?(2) 中间层比输入宽还是窄?(3) 前一步有没有用到标签?
判分点与答案(非官方评分标准)
判分点:① 损失按 x’ − x 算;② 判断瓶颈宽窄;③ 无标签任务归类正确。
- (1) 差全为 0,损失 = 0,还原完全一样。
- (2) 不能。中间 16 维比输入 8 维宽,网络可能直接照抄,损失低不代表学到了压缩。
- (3) 没有用标签,是无监督的降维 / 特征提取,可以用自编码器取中间的 h。
闪卡自测
1. 有监督学习的两类任务?
分类和回归(p.8)。
2. 无监督学习的四类任务和对应方法?
聚类(K-means)、降维(PCA、Autoencoder)、密度估计(生成模型)、自监督学习(p.8)。
3. 自编码器属于哪类任务?
降维,和 PCA 并列(p.8)。
4. 自编码器三条公式?
h = e(x),x’ = d(h),ℓ = ||x’ − x||(p.11)。
5. 自编码器训练用标签吗?
不用,输入自己就是要还原的目标(p.11)。
6. 课件结构图的层宽?
6-4-2-4-6,中间 2 个红色节点是编码(p.11)。
7. undercomplete 自编码器瓶颈层的作用?
比输入窄,逼网络学出重要特征的低维压缩表示(p.25)。
8. 自编码器可以用哪些层搭?
全连接层、卷积层、转置卷积层(p.11)。
9. 往潜在空间加随机噪声是自编码器瓶颈的作用吗?
不是,那是下一讲 VAE 的做法,是 p.25 选择题的干扰项。
下一讲
下一页 L09b 把全连接换成卷积:看 28×28 的手写数字怎么一路缩到 10 个数,转置卷积怎么把小图放大回去,以及这 10 个数能拿来做什么。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。