L02b 评估模型与多项式基展开:直线贴不上,就给表格加一列 x²
训练好的直线要拿没见过的数据打分;贴不上弯的数据时加 x²、x³ 这些列,模型仍是线性的;加得越多训练误差越小,测试误差却会反弹。
一句话版
模型训练完,要拿它没见过的数据打分。直线贴不上弯的数据时,给表格多加一列 x²,模型还是线性回归,照样能用闭式解和梯度下降。
加的列越多,训练误差越小。没见过的数据上的误差却会先降后升,这就是欠拟合和过拟合。
先认识这几个词
读之前最好先懂线性回归的模型和 MSE,见 L02a。
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 训练误差 | training error | 模型在拟合时用过的那批点上的平均误差 |
| 测试误差 | test error | 模型在拟合时没见过的点上的平均误差 |
| 多项式基展开 | polynomial basis expansion | 给表格加 x²、x³ 这些列,让直线能弯 |
| 模型复杂度 | model complexity | 这里就是多项式的最高次数 |
| 欠拟合 | underfitting | 模型太简单,连训练点都贴不上 |
| 过拟合 | overfitting | 模型太复杂,把训练点的噪声也记住了,新点上反而差 |
一个类比:背题和学会
一个学生拿到一本习题册,把每道题的答案都背了下来。拿习题册里的原题考他,满分。换几道没见过的新题,他就不会了。
训练误差相当于拿原题考,测试误差相当于拿新题考。要知道他学没学会,只能看新题的分数。
背得越细,原题分数越高;可背到连印刷错误都记住时,新题上反而更容易出错。模型也是这样:加的项越多,训练点贴得越紧,太紧了就把噪声当成规律。
类比在哪里失效:
- 学生可以重新理解题目,模型只能在你给的形状里调参数。直线这个形状本身贴不上弯的数据时,调多久都没用,要换形状。
- 真实数据带噪声,就算形状选对了,测试误差也到不了零。
从零讲起
1. 训练误差和测试误差
它解决什么问题
模型训练时就是在让训练点上的误差变小,所以训练误差小是应该的,它说明不了模型在新数据上好不好用。要判断模型能不能用,得拿一批拟合时没碰过的数据来算误差。
直觉
训练点是模型「看过答案」的题。测试点是新题。同一条直线,在看过的点上误差小,在新点上误差通常会大一些;大多少,说明它学到的东西有多少能带到新数据上。
一步一步看
目标:用同一条直线分别在训练点和没见过的测试点上算 MSE,看测试误差为什么大得多。
用上一页的三个训练点 (1,2)、(2,4)、(3,5) 和它们的最小二乘直线 y = 1.5x + 0.667。另外拿三个拟合时没用过的点当测试点:(0.5, 1.0)、(2.5, 5.2)、(3.5, 5.6)。
-
训练点上,上一页已经算过:三个误差是 −0.167、+0.333、−0.167,训练 MSE ≈ 0.056。
-
测试点 (0.5, 1.0):预测 1.5 × 0.5 + 0.667 = 1.417,误差 1.0 − 1.417 = −0.417,平方 0.174。
-
测试点 (2.5, 5.2):预测 4.417,误差 +0.783,平方 0.613。
-
测试点 (3.5, 5.6):预测 5.917,误差 −0.317,平方 0.100。
-
测试 MSE = (0.174 + 0.613 + 0.100) / 3 ≈ 0.296,是训练 MSE 的五倍多。
怎么算
测试误差和训练误差用同一个公式,只是换一批点:
测试 MSE = (1/M) Σ (ȳᵐ − ŷᵐ)²,m 从 1 数到 M,M 是测试点个数。
意思是:拿训练好的 w、b 不动,对每个测试点算预测、算误差、平方,最后取平均。算测试误差时绝不能再调 w、b。
测试误差大,课件给了三条改进方向,各管一件事:
- 调 ε、η 重新训练:只影响能不能找到最优的 (w, b)。找到了也还是一条直线。
- 收集更多数据:能让模型对某一份数据的随机性没那么敏感,下一页细讲。
- 重新设计模型:直线这个形状贴不上时,换形状。下一节就是这条路。
常见误解
以为训练误差小就说明模型好
训练就是在压低训练误差,它小是必然的。模型好不好要看它在没见过的数据上的误差。
以为测试误差大就该调学习率重新训练
学习率只决定能不能找到这个形状下的最优参数。线性回归 + MSE 的最优解已经有闭式解,再怎么调也还是同一条直线。形状不对要改模型。
试一下
直线 y = 1.5x + 0.667,再加一个测试点 (4, 7)。它的误差平方是多少?测试误差会变大还是变小?
预测 1.5 × 4 + 0.667 = 6.667,误差 7 − 6.667 = 0.333,平方约 0.111。
它比原来三个测试点的平均 0.296 小,所以四个点的测试 MSE = (0.887 + 0.111) / 4 ≈ 0.250,变小了。测试误差会随测试点的选取波动,测试点越多越稳。
2. 多项式基展开:加一列 x²
它解决什么问题
数据明显是弯的,直线怎么摆都贴不上。办法是在数据表里多加一列 x²(还可以再加 x³……),模型变成 y = w₁x + w₂x² + b,画出来是一条抛物线。
从哪来(补充)
多项式回归的历史很早,最早为多项式回归设计实验的是 Gergonne 1815 年的论文。多项式回归对未知参数是线性的,所以在统计里被当作多元线性回归的一个特例。
出处:Wikipedia: Polynomial regression
直觉
模型只会做一件事:把每一列乘一个权重,加起来,再加 b。它不关心某一列是怎么来的。把 x² 算好写进表里,在模型眼里那就是普通的一列新特征,和面积、房龄没有区别。
所以「线性」说的是对参数 w 线性:每个 w 都只是乘在一列上。对输入 x 来说,因为有 x² 这一列,画出来是弯的。
一步一步看
目标:三个落在 y = x² + 1 上的点先用直线拟合,再加一列 x²,看训练误差怎样从 0.222 降到 0。
三个训练点 (0,1)、(1,2)、(2,5),它们正好在 y = x² + 1 上。
-
先用直线拟合。x 的均值是 1,y 的均值是 8/3。按闭式解,w = 2、b = 2/3 ≈ 0.667。
-
直线的三个预测是 0.667、2.667、4.667,误差是 +0.333、−0.667、+0.333,训练 MSE = (0.111 + 0.444 + 0.111) / 3 ≈ 0.222。两端在线上方、中间在线下方,这是数据弯而直线不弯的标志。
-
给表格加一列 x²,三行分别是 0、1、4。
x x² y 0 0 1 1 1 2 2 4 5 -
模型变成 y = w₁x + w₂x² + b,解出 w₁ = 0、w₂ = 1、b = 1,三个点全部穿过,训练 MSE = 0。
-
求解时,x 和 x² 就是两列特征,和多特征线性回归的解法一样,闭式解和梯度下降照用。
怎么判断
判断一个模型是不是线性模型,只看参数:
y = w₁x + w₂x² + w₃x³ + b
意思是:把 x、x²、x³ 各看成一列特征 x₁、x₂、x₃,模型就是 y = w₁x₁ + w₂x₂ + w₃x₃ + b。每个 w 都是一次方、单独乘一列,所以对 w 线性,是线性模型。
反过来,如果参数出现在指数里、平方里或者两个参数相乘,比如 y = e^(wx) 或 y = w₁w₂x,对参数就不线性了,闭式解那一套不能直接用。
次数越加越高时,训练误差不会变大。原因是高次模型包含低次模型:把 x³ 的权重设为 0,三次模型就退化成二次模型。它最差也能做到和二次一样好,充分优化时只会更好或持平。
输入不止一个时,同样的思路可以用两个原始特征造一个新特征,写成 x₃ = k(x₁, x₂),比如两者相乘。这里的 k 是一个「造特征的函数」。
常见误解
以为加了 x² 项就变成非线性模型了
判断线性看 w,不看 x。y = w₁x + w₂x² + b 对 w 线性,是线性模型;它对 x 是非线性的,画出来是抛物线。
以为加了 x² 就要换一套新的求解方法
把 x² 算好写进表里,它就是多出来的一列特征。闭式解和梯度下降一个字都不用改。
试一下
下面三个模型,哪些是线性模型?① y = w₁x + w₂x³ + b ② y = w₁√x + b ③ y = w₁²x + b
① 是:x 和 x³ 各是一列特征,w 都是一次方。
② 是:√x 也只是一列算好的特征。
③ 不是线性模型的标准写法:参数 w₁ 被平方了。虽然可以令 v = w₁² 换元,但那时参数就成了 v,而且 v 只能取非负数。
3. 误差和复杂度:欠拟合与过拟合
它解决什么问题
既然加 x² 有用,是不是越加越好?这一节回答:训练误差会一路降,测试误差会先降后升。加太少叫欠拟合,加太多叫过拟合,要在中间找位置。
直觉
次数太低,模型的形状太死板,连训练点都贴不上,新点自然也贴不上。
次数太高,模型的形状太灵活,能弯到穿过每一个训练点。训练点本身带噪声,模型把噪声也照着弯了进去,新点一来就离得很远。
一步一步看
目标:同一组 6 个点分别用 1、2、5 次多项式拟合,看训练误差一路降到 0,5 次曲线却已经过拟合。
同一组 6 个训练点,x 从 0 到 5,分别用 1 次、2 次、5 次多项式拟合。
-
1 次(直线):数据是往上弯的,直线两头在点下面、中间在点上面,训练 MSE ≈ 1.75。这是欠拟合。
-
2 次(抛物线):顺着数据的弯走,训练 MSE 降到约 0.06。
-
5 次:6 个点、6 个参数,曲线能穿过每一个点,训练 MSE = 0。可是点和点之间它会为了穿点而扭来扭去。
-
训练误差从 1.75 到 0.06 再到 0,次数越高越小。但 5 次曲线在点与点之间的扭动,换一批新点就会变成大误差。
-
课件把这件事画成一张图:横轴是模型复杂度,纵轴是误差。训练误差一路下降,测试误差先降后升,左端是欠拟合,右端是过拟合。
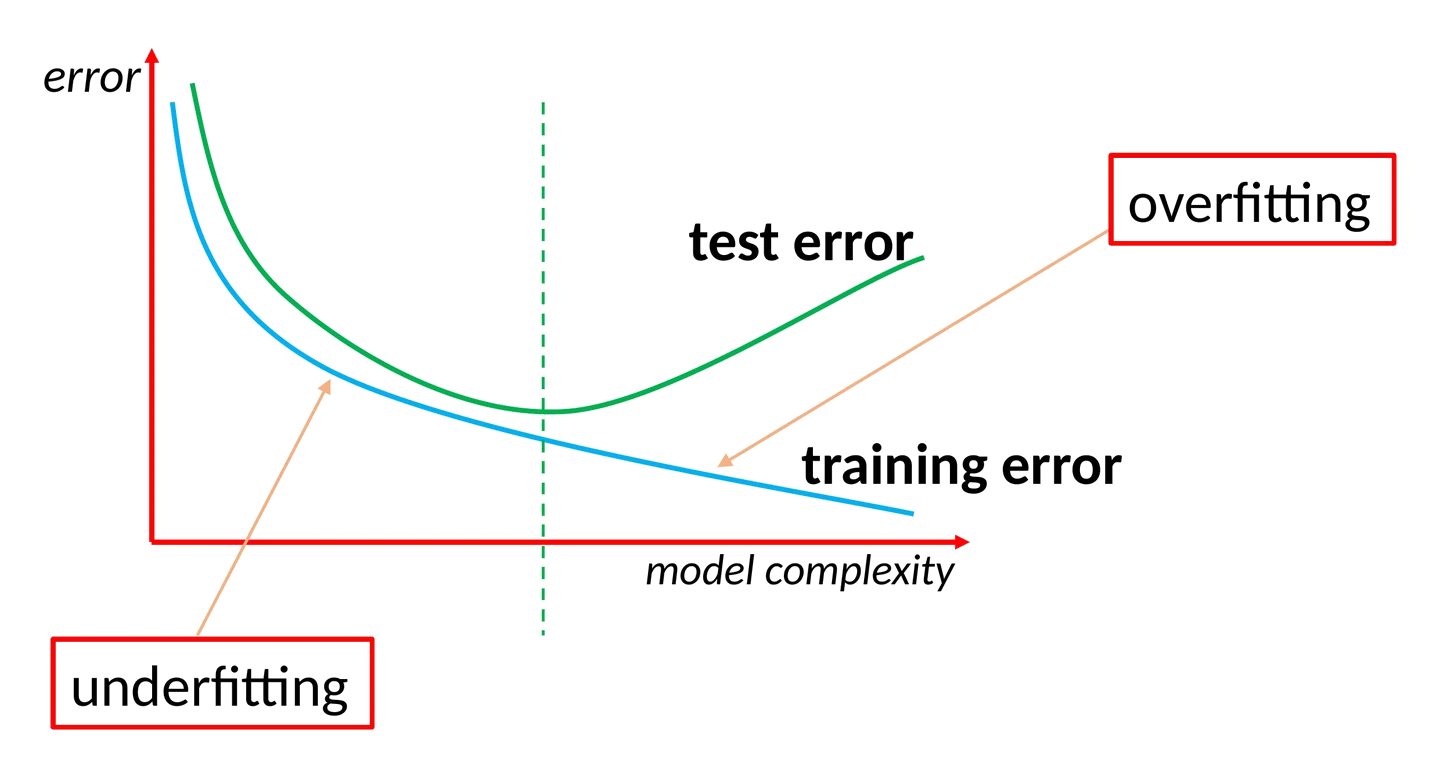
图片来源:COMP5541 L02_Linear Regression.pptx, p.30
怎么判断
看两个数,就能大致说出模型在曲线的哪一侧:
| 训练误差 | 测试误差 | 位置 |
|---|---|---|
| 大 | 大 | 左端,欠拟合 |
| 小 | 小 | 中间,合适 |
| 小 | 大 | 右端,过拟合 |
意思是:训练误差告诉你模型的形状够不够用,测试误差告诉你学到的东西能不能带到新数据上。两个都大,是形状不够;训练小、测试大,是形状太灵活、记住了噪声。
最好的复杂度在测试误差最低的地方,也就是 U 形的底部。U 形是示意:训练误差随次数不增是有保证的,测试误差的形状取决于数据,不一定是规整的 U。
常见误解
以为训练误差为 0 的模型最好
训练误差为 0 往往说明模型把噪声也记住了。6 个点配 5 次多项式,必然能穿过每个点,这说明的是参数够多,不是规律学得好。
以为测试误差一定是规整的 U 形
课件的 U 形是示意。能保证的只有一条:嵌套模型充分优化时,训练误差随复杂度不增。测试误差的具体形状取决于数据。
试一下
3 个训练点,用 2 次多项式拟合,训练误差会是多少?这能说明 2 次就是合适的次数吗?
2 次多项式有 w₁、w₂、b 三个参数,三个点(x 各不相同)一定能全部穿过,训练误差为 0。
这说明不了次数合适。点数和参数个数一样多时,训练误差为 0 是必然的,要看测试误差才知道。
把它们串起来
这一页是课件四个阶段里的 Stage 3:评估。训练好的模型拿没见过的数据算误差,这才是它的成绩。
测试误差大,有三条路,各管一件事。直线形状贴不上时,最直接的是加 x² 这类新列。加完还是线性模型,求解方法不变。
加得太多会翻到另一侧:训练误差一路降到 0,测试误差反弹。下一页给这两侧起名字,叫偏差和方差,并讲怎么在不偷看测试集的前提下选次数。
课件里的坑
- [补充] p.29 的
x₃ = k(x₁, x₂)里的 kernel 只是「构造特征的函数」的意思,和后面核方法里隐式计算内积的 kernel trick 不是一回事,课件没有展开。 - [口径差异] p.30 的测试误差 U 形是示意。嵌套模型充分优化时训练误差不增有保证,测试误差先降后升没有保证。
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先画出误差对复杂度的两条曲线,标出欠拟合和过拟合。然后把「完整例题」自己算一遍,再做「变式题」。最后回查两个最容易错的地方:以为加了 x² 就是非线性模型,以为训练误差为 0 就最好。
必背
- 评估只看模型没见过的数据:训练误差小不等于模型好,测试误差才反映模型在新数据上的表现。
- 加 x²、x³ 等高次项后仍是线性模型,因为对参数 w 线性;多项式基展开用来抓非线性关系,嵌套模型充分优化时,次数增加使训练误差不增。
- 改进模型的三条路各管一件事:调 ε、η 重新训练只影响能不能找到最优 (w, b),加数据对减小方差有用,改模型(加特征)才能解决直线拟合不了曲线。
- 误差—复杂度曲线:训练误差随复杂度一路下降,测试误差常示意为先降后升的 U 形但不保证;左端欠拟合,右端过拟合。
- 输入不止一维时可以用 x₃ = k(x₁, x₂) 这类函数从原始特征造新特征,思路和加 x² 一样:造特征让线性模型表达非线性。
课件例题
例 1(课件 p.26):测试误差大,怎么改进
题面:同一条拟合线 y = wx + b,训练集上的平均误差小,测试集上的点离线更远、平均误差更大。课件问 How to improve?,列了三个方向:调 ε、η 重新训练,收集更多数据,重新设计模型。各管什么用?
提示
想一想:调 ε、η 之后,模型的形状变了吗?多收集数据,直线能变弯吗?
解答
- 调 ε、η 重新训练:只影响能不能找到最优的 (w, b)。找到了也还是这条直线,拟合不了曲线关系。
- 收集更多数据:对减小方差有用,对模型本身太简单没用。
- 重新设计模型:直线贴不上时要换模型,下一题就是加 x²。
- 教训:训练误差小不等于模型好,评价只看测试集。
例 2(课件 p.27):加一列 x² 后还是线性模型吗
题面:把训练表从 (x, y) 扩成 (x, x², y),模型变成 y = w₁x + w₂x² + b。课件问 Is it still a linear model?
提示
「线性」是对谁线性?把 x² 改名叫 x₂ 再看一遍模型。
解答
- 是。线性回归的「线性」指对参数 w 线性。
- 把 x² 看成新特征 x₂,模型就是 y = w₁x₁ + w₂x₂ + b,和多特征线性回归同一个形式,闭式解和梯度下降照用。
- 它对输入 x 是非线性的,画出来是抛物线。
例 3(课件 p.29):多项式基展开,次数越高会怎样
题面:模型依次是 y = wx + b、y = w₁x + w₂x² + b、y = w₁x + w₂x² + w₃x³ + b……三条曲线叠在同一组训练点上。课件标 Lower training error,并问输入不止一维时怎么办(kernel functions:x₃ = k(x₁, x₂))。
提示
三次模型能不能退化成二次模型?训练误差降了,测试误差一定降吗?
解答
- 次数越高曲线越弯、越贴训练点。高阶模型把低阶模型当特例,充分优化时训练误差不增。
- 训练误差降不代表测试误差降,次数太高会过拟合,这要靠验证集判断。
- 多维输入时,可以用两个原始特征造一个新特征,比如乘积 x₁x₂,思路同样是「造特征让线性模型表达非线性」。
完整例题
题面(自编情境):训练点 (0,1)、(1,2)、(2,5),测试点 (−1, 2)、(3, 10)。(a)用直线 y = wx + b 拟合,求 w、b 和训练 MSE。(b)加一列 x² 用 y = w₁x + w₂x² + b 拟合,求参数和训练 MSE。(c)两个模型的测试 MSE 各是多少?(d)对直线模型,「调学习率」「多收集数据」「加 x²」哪条路有用?
(a)直线。
- x 的均值 = (0 + 1 + 2)/3 = 1,y 的均值 = (1 + 2 + 5)/3 = 8/3。
- Σ(x − x̄)(y − ȳ) = (−1)(−5/3) + 0 × (−2/3) + (1)(7/3) = 12/3 = 4。
- Σ(x − x̄)² = 1 + 0 + 1 = 2,所以 w = 4/2 = 2。
- b = ȳ − w·x̄ = 8/3 − 2 = 2/3 ≈ 0.667。
- 预测 0.667、2.667、4.667,误差 +0.333、−0.667、+0.333,训练 MSE = (0.111 + 0.444 + 0.111)/3 ≈ 0.222。
(b)加 x²。
- 表格多一列 x²:0、1、4。
- 三个方程:b = 1;w₁ + w₂ + b = 2;2w₁ + 4w₂ + b = 5。
- 代入 b = 1:w₁ + w₂ = 1,2w₁ + 4w₂ = 4,解得 w₂ = 1、w₁ = 0。
- 模型 y = x² + 1,三个点全穿过,训练 MSE = 0。
(c)测试误差。
- 直线:x = −1 预测 −2 + 0.667 = −1.333,误差 2 − (−1.333) = 3.333;x = 3 预测 6.667,误差 3.333。测试 MSE = (11.11 + 11.11)/2 ≈ 11.11。
- 抛物线:x = −1 预测 2,x = 3 预测 10,测试 MSE = 0。
(d)改进路线。 直线的训练误差和测试误差都大,是形状不够。调学习率找到的仍是这条直线;多收集数据,直线也弯不起来;加 x² 改了形状,有用。
答案:直线 w = 2、b ≈ 0.667,训练 MSE ≈ 0.222、测试 MSE ≈ 11.11;抛物线 y = x² + 1,训练和测试 MSE 都是 0;该走「加 x²」这条路。
变式题(先自己做)
自编情境。训练点 (−1, 1)、(0, 0)、(1, 1)。(a)用直线拟合,求 w、b 和训练 MSE。(b)用 y = w₁x + w₂x² + b 拟合,结果如何?它还是线性模型吗?(c)有人再用 5 次多项式拟合这三个点,训练误差也是 0,他说「5 次和 2 次一样好」,对不对?
提示
(a)x 的均值是 0,算起来很快。(c)三个点、六个参数,训练误差为 0 说明了什么?要比较两个模型,该看哪个误差?
判分点与答案(非官方评分标准)
判分点:① 直线斜率为 0 算对;② 训练 MSE 算成 2/9;③ 说出加 x² 后仍是线性模型及理由;④ 指出训练误差为 0 不能用来比较模型。
(a)x̄ = 0,ȳ = 2/3。Σx(y − ȳ) = (−1)(1/3) + 0 + (1)(1/3) = 0,所以 w = 0,b = 2/3。误差 1/3、−2/3、1/3,训练 MSE = (1/9 + 4/9 + 1/9)/3 = 2/9 ≈ 0.222。直线是一条水平线,完全没抓到弯。
(b)解出 w₁ = 0、w₂ = 1、b = 0,即 y = x²,训练 MSE = 0。它对参数 w 线性,仍是线性模型。
(c)不对。三个点配 5 次多项式,参数比点多,能穿过这三点的曲线有无穷多条,训练误差为 0 是必然的。两个模型谁更好,要看没见过的数据上的误差,或者用下一页的验证集比较。
闪卡自测
1. 训练误差小,能说明模型好吗?
不能。训练就是在压低训练误差,评价只看测试集上的误差(p.26)。
2. 验证误差大时,调 ε、η 重新训练能解决「直线拟合不了曲线」吗?
不能。调这两个只影响能不能找到最优 (w, b),找到了也还是这条直线(p.26)。
3. y = w₁x + w₂x² + w₃x³ + b 是线性模型吗?
是,对参数 w 线性;x²、x³ 只是新特征,对输入 x 非线性(p.27)。
4. 把直线换成抛物线后,课件的测试误差变了吗?
变小了。p.28 是 p.26 的复刻,换成抛物线后训练集贴得更紧,测试集误差也比直线小,说明这次改模型有效(p.28)。
5. 多项式次数从 1 升到 9,训练误差和测试误差各怎么变?
嵌套模型充分优化时训练误差不增;测试误差常示意为先降后升,并非必呈 U 形(p.30)。
6. x₃ = k(x₁, x₂) 这一招想做什么?
输入不止一维时,用两个原始特征构造一个新特征(比如乘积 x₁x₂),让线性模型能表达非线性(p.29)。
7. 误差—复杂度曲线的左端和右端各叫什么?
左端欠拟合:训练、测试误差都大。右端过拟合:训练误差很小、测试误差反弹(p.30)。
下一讲
L02b-2 偏差、方差与交叉验证:给欠拟合和过拟合各起一个名字,看两个数就能诊断,再讲怎么在不偷看测试集的前提下选多项式次数。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。