L02b-2 偏差、方差与交叉验证:看两个数诊断模型,用验证集挑次数
偏差是多次训练的预测平均偏离真值多远,方差是这些预测散得多开;看训练误差和测试误差就能分清是哪种毛病,各有各的药;选多项式次数只能靠验证集或 N 折交叉验证。
一句话版
模型出错有两种毛病。太简单,怎么训都偏,叫偏差大;太复杂,换一份数据就变样,叫方差大。
看训练误差和测试误差两个数就能分清是哪种,两种毛病各有各的药。挑多项式次数这类决定,只能用从训练集里另切出来的验证集,测试集留到最后报分。
先认识这几个词
读之前最好先懂上一页的欠拟合和过拟合,见 L02b。
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 偏差 | bias | 换很多份训练集各训一次,预测的平均离真值多远 |
| 方差 | variance | 这些预测彼此散得多开 |
| 正则化 | regularization | 给过于复杂的模型加惩罚,限制参数取值 |
| 验证集 | validation set | 从训练数据里另留一份,专门用来挑模型 |
| 测试集 | test set | 训练和挑模型时都不碰,最后打一次分 |
| N 折交叉验证 | N-fold cross validation | 训练集切 N 份,轮流拿一份当验证集,结果取平均 |
一个类比:射击和换枪
一个射手打了一组靶。弹孔挤在一起、却都偏在靶心左上方,说明准星歪了:每一枪都差不多,平均起来系统性地偏,这是偏差。弹孔东一个西一个、平均位置倒在靶心附近,说明手抖:每一枪差别很大,这是方差。
准星歪了,多打几枪也没用,得校准星。手抖,多打几枪取平均就能稳一些,或者换一把更好握的枪。
类比在哪里失效:
- 射手每一枪是同一个人在打。模型的「每一枪」要想象成换一份训练集、重新训练一次,现实里通常只有一份数据,这件事只能靠想象或重抽样来看。
- 靶心的位置射手看得见。模型要预测的真值藏在噪声后面,偏差和方差没法直接量,只能通过训练误差和测试误差间接诊断。
从零讲起
1. 偏差和方差
它解决什么问题
上一页看到,次数太低会欠拟合,次数太高会过拟合。偏差和方差给这两侧各起了一个名字,说清楚误差是从哪来的:是形状本身偏了,还是对训练数据太敏感。
从哪来(补充)
统计学习里把这两种误差这样定义:偏差是学习算法里错误的假设造成的误差,偏差高会导致欠拟合;方差是对训练集的小幅波动太敏感造成的误差,方差高会导致过拟合。两者此消彼长,叫偏差—方差权衡。
出处:Wikipedia: Bias–variance tradeoff
直觉
想象同一个模型,用很多份不同的训练集各训一次,每次对同一个输入都给出一个预测。把这些预测画在靶上,每个预测是一个弹孔。
弹孔的平均位置离靶心多远,是偏差。弹孔彼此散得多开,是方差。
一步一步看
目标:先看靶盘的四种组合,再把直线和 5 次多项式各训 20 次,看复杂度上升时偏差降、方差升。
-
先看四种组合。低偏差低方差:弹孔紧凑且在靶心。低偏差高方差:弹孔散开但围绕靶心。高偏差低方差:弹孔紧凑但偏离靶心。高偏差高方差:又散又偏。
-
再换到模型上。从同一条真实曲线上抽 20 次训练集,每次 8 个点,各训一次,把 20 个模型画在一起。
-
直线:20 条挤成一束,每次训出来都差不多,方差小。可是真实曲线是弯的,这一束在两端都偏离它,偏差大。
-
5 次多项式:平均下来能顺着真实曲线走,偏差小。可 20 条四处散开,换一份数据就变一个样,方差大。
-
合起来:复杂度往上,偏差降、方差升。上一页那条 U 形曲线,左半段的误差主要来自偏差,右半段主要来自方差。
怎么算
课件给了两个统计量的通用公式。设有 N 个预测值 x¹ … xᴺ:
均值 m = (1/N) Σ xⁿ
意思是:所有预测加起来除以个数,就是弹孔的平均位置。偏差就是 m 离真值有多远。
方差 s = (1/N) Σ (xⁿ − m)²
意思是:每个预测离平均位置有多远,平方后取平均。弹孔越散,s 越大。
小例子:同一个输入的真值是 5,某个模型五次训练给出 3、4、3、4、3。
m = (3 + 4 + 3 + 4 + 3)/5 = 17/5 = 3.4,离真值差 1.6,偏差大。s = (0.16 + 0.36 + 0.16 + 0.36 + 0.16)/5 = 1.2/5 = 0.24,预测挤在一起,方差小。
这是靶盘上「紧凑但偏离靶心」那一格。
常见误解
以为偏差和方差是用一次训练就能算出来的
两者都要想象「换很多份训练集各训一次」才有定义。一次训练只给一个预测,看不出它们彼此散得多开。实际中靠训练误差和测试误差间接判断。
以为简单模型什么都比复杂模型差
简单模型方差小,每次训出来都差不多,这是它的长处。它的问题是偏差可能大。复杂模型反过来。
试一下
真值是 5,模型五次训练给出 2、8、5、3、7。算均值和方差,它落在靶盘的哪一格?
m = (2 + 8 + 5 + 3 + 7)/5 = 25/5 = 5,正好等于真值,偏差为 0。
s = (9 + 9 + 0 + 4 + 4)/5 = 26/5 = 5.2,散得很开,方差大。
落在「低偏差、高方差」那一格:弹孔散开,但围着靶心。
2. 诊断与开药
它解决什么问题
偏差和方差不能直接量。实际手里有的是训练误差和测试误差两个数。这一节讲怎么用这两个数判断是哪种毛病,再对症下药。
直觉
模型连训练点都贴不上,说明形状本身不够用,这是偏差的事。训练点贴得很好、新点一塌糊涂,说明模型把训练数据的偶然细节当成了规律,这是方差的事。
药也分两边。形状不够用,就要更灵活的形状。太灵活,就要往回收,或者给它更多数据让偶然细节互相抵消。
一步一步看
目标:按先看训练误差、再看测试误差的顺序诊断模型,看大偏差和大方差各该用什么药。
-
拿到一个模型,先看训练误差。训练误差大:模型贴不上训练集,判为大偏差,欠拟合。
-
训练误差小,再看测试误差。测试误差也小:正常。测试误差大:判为大方差,过拟合。
-
大偏差的药:重新设计模型,加特征(多项式基展开)或换更复杂的模型。多收集数据没用,直线怎么训也弯不起来。
-
大方差的药有三种:正则化,限制参数取值;更多训练数据;把模型往简单里改,比如降阶、减特征。
怎么判断
课件在误差曲线旁边写了两条规则,原话是:
If the model cannot fit the training data, then large bias; If it can fit the training data, but large errors on testing data, then probably large variance.
意思是:贴不上训练集,是大偏差;贴得上训练集、测试误差大,多半是大方差。第二条写的是 probably,因为测试误差大也可能有别的原因,比如测试数据和训练数据本身差别大。
两边的药容易记混,按方向记:
| 毛病 | 方向 | 具体做法 |
|---|---|---|
| 大偏差 | 加 | 加特征、换更复杂的模型 |
| 大方差 | 减、多 | 减复杂度、加正则化、多收集数据 |
判断题常把两边的药交换来考,比如「欠拟合时多收集数据就能解决」,这一条是错的。
常见误解
以为数据不够就多收集,什么毛病都能治
加数据只对方差有效。偏差是模型本身表达不了那个关系,再多数据也只是更确信地拟合出一条错的直线。
以为过拟合了只能换简单模型
简化模型是一条路,还有正则化和多收集数据。正则化保留复杂的形状,但惩罚过大的参数,后面讲优化与正则化时展开。
试一下
三个模型:甲训练误差 0.02、测试误差 0.03;乙训练误差 0.40、测试误差 0.45;丙训练误差 0.01、测试误差 0.60。各是什么情况,该怎么办?
甲:两个都小,正常,不用改。
乙:训练误差就很大,大偏差、欠拟合。加特征或换更复杂的模型,多收集数据没用。
丙:训练很小、测试很大,大方差、过拟合。加正则化、多收集数据或降低复杂度。
3. 验证集与 N 折交叉验证
它解决什么问题
要选多项式次数,就得比较几个模型。拿测试集比,测试集就参与了决定,最后报出来的分数会虚高。办法是从训练集里再切一块出来当验证集,所有选择都只看验证集。
从哪来(补充)
交叉验证在统计里也叫 rotation estimation。k 折交叉验证把数据随机分成 k 份大小相等的子集,轮流拿一份做验证、其余训练,k 次结果取平均。10 折交叉验证很常用。
出处:Wikipedia: Cross-validation (statistics)
直觉
测试集像期末考试的卷子。平时拿它来练、拿它来挑复习方法,到了考试分数就不代表真实水平。所以要另准备几套模拟卷,也就是验证集。
只切一块验证集,结果可能碰巧偏好或偏坏。N 折交叉验证让每一份数据都轮流当一次验证集,取平均,运气的成分就小了。
一步一步看
目标:从切出验证集到 5 折交叉验证再到测试集报分,看每一份数据各管哪一个决定。
-
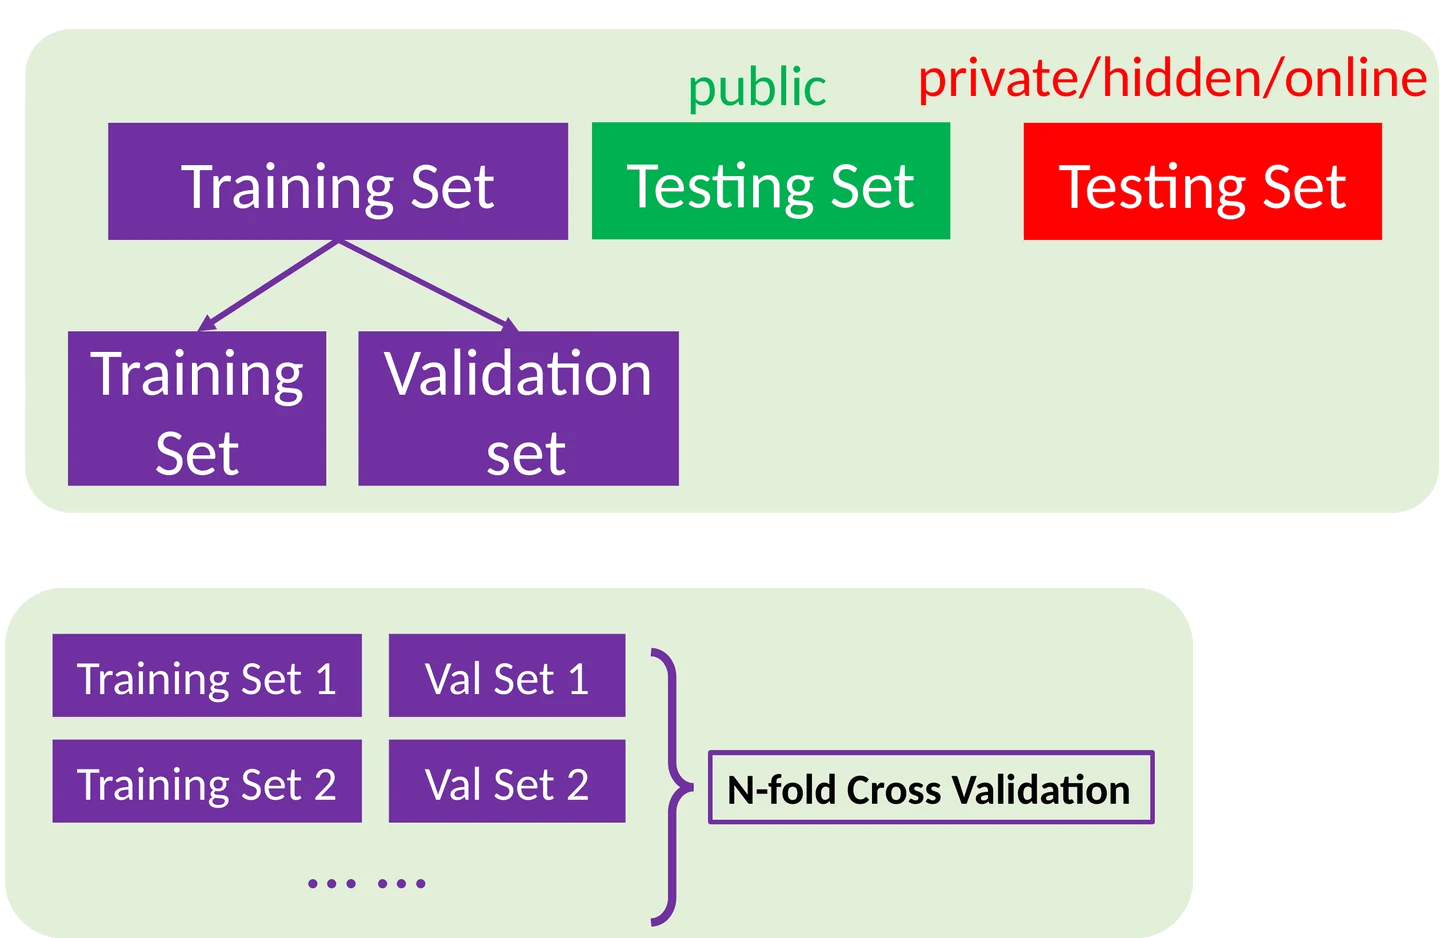
全部数据先分成训练集和测试集。课件里测试集还分公开和隐藏两种,那是竞赛平台的设定:公开榜的分数你看得到,隐藏榜的标签你永远看不到。
-
训练集内部再切出验证集。比较多项式次数、调学习率这些决定,只看验证集上的误差。
图片来源:COMP5541 L02_Linear Regression.pptx, p.37 -
N 折交叉验证:把训练集切成 N 份。下面以 5 折为例,第 1 轮拿第 1 份验证、其余 4 份训练,得到一个验证误差。
-
第 2 轮换第 2 份验证,依此类推,一共轮 5 次,得到 0.21、0.19、0.25、0.20、0.15 五个验证误差。
-
交叉验证误差是这五个数的平均,等于 0.20。每个候选次数都这样算一遍,选平均值最小的那个。
-
次数选定后,在测试集上报一次分。这个分数不再拿去改模型。
怎么算
交叉验证误差 = (1/N) Σ 第 i 折的验证误差,i 从 1 数到 N。
意思是:N 轮各算一次验证误差,取平均。比较候选模型时比的是这个平均值,不挑某一折单独比。
整个流程按顺序是:
- 列出候选,比如多项式次数 1、2、3……
- 每个候选都做一遍 N 折交叉验证,得到一个交叉验证误差。
- 选交叉验证误差最小的候选。
- 用选好的设置在全部训练集上重新训练一次。
- 在测试集上报一次最终分数。
常见误解
以为测试集分数最高的模型就是最好的
用测试集挑模型,等于把测试集变成训练过程的一部分,报出来的分数虚高。测试集只在最后报一次分。
以为某一折上赢了就说明这个模型更好
单折的结果随划分而波动,交叉验证就是用平均来抵消这种波动。比较时只看平均值。
试一下
4 折交叉验证,某模型四折的验证误差是 0.30、0.34、0.26、0.30。交叉验证误差是多少?每一轮用多少份数据训练?
(0.30 + 0.34 + 0.26 + 0.30)/4 = 1.20/4 = 0.30。
每一轮拿 1 份验证、其余 3 份训练。
把它们串起来
模型的误差可以分成两种来源。偏差来自形状不够用,方差来自对训练数据太敏感。复杂度往上,偏差降、方差升,上一页的 U 形曲线就是两者此消彼长的结果。
实际中看训练误差和测试误差就能诊断。贴不上训练集是偏差,用「加」治;训练好测试差是方差,用「减」和「多」治。
最后挑次数时,测试集不能碰。用验证集或 N 折交叉验证取平均来选,选好后在测试集上报一次分。这套评估框架和线性回归本身无关,后面每一讲都会再用。
课件里的坑
- [补充] p.34–36 的诊断规则用的是测试误差,这是为了讲清概念。真正做选择、决定加特征还是加正则化时,按 p.37 的铁律应该看验证误差,测试误差留到最后。
- [补充] p.37 把测试集分成 public 和 private/hidden/online 两种,这是竞赛平台的设定,一般项目里只有一份测试集。
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先画出 2×2 的靶盘,说出每格的偏差和方差。再默写两边的药,然后把「完整例题」自己做一遍,再做「变式题」。最后回查两个最容易错的地方:欠拟合时以为加数据有用,拿测试集挑模型。
必背
- 偏差 = 多次训练所得预测的平均偏离真值多远,方差 = 这些预测彼此散得多开;简单模型方差小,复杂模型方差大。
- 训练集都拟合不了是大偏差(欠拟合),训练好测试差是大方差(过拟合);诊断只看训练误差和测试误差两个数。
- 大偏差靠加特征或换更复杂的模型,仅加数据通常不能解决模型表达力不足;大方差靠正则化、更多数据或简化模型。
- 选模型只能用验证集或 N 折交叉验证,测试集不参与任何选择,只在最后报一次分。
- N 折交叉验证:训练集切 N 份,轮流拿 1 份验证、其余 N−1 份训练,N 个验证误差取平均,比的是平均值。
- 线性模型四问:假设标签是特征的线性函数加噪声;关键步骤是最小化 MSE;优点是简单、可解释、有闭式解;局限是只能表达对参数线性的关系、对离群点敏感。
课件例题
例 1(课件 p.35):大偏差怎么办
题面:课件问 What to do with large bias?
提示
大偏差的病根在模型的形状。形状不够用,该往哪个方向改?多收集数据能改变形状吗?
解答
- 重新设计模型:多项式基展开,加更多特征;或换更复杂的模型(课件写 deep learning??,预告后面的神经网络)。
- 大偏差时加数据没用,模型表达不了那个关系,再多数据也只是更确信地拟合出一条错的直线。
例 2(课件 p.36):大方差怎么办
题面:课件问 What to do with large variance?
提示
大方差是模型对单份数据太敏感。有三类办法:限制参数、增加数据、改简单。
解答
- 正则化:限制参数取值,后面讲优化与正则化时展开。
- 更多训练数据:模型对单份数据的随机性没那么敏感。
- 重新设计模型,往简单里改:降阶、减特征。
- 和上一题合起来记:偏差用「加」治,方差用「减」和「多」治。判断题会把两边的药交换来考。
例 3(课件 p.38):线性模型的四问
题面:课件只列四个问题,Assumption? Key step? Advantages? Limitations?,附一句 Linear Model: to view datapoints from a new angle!
提示
按本讲的顺序回想:模型长什么样、用什么损失、怎么求参数、加 x² 能做什么、什么时候会出问题。
解答
- Assumption:标签是特征的线性函数加噪声,用平方损失衡量好坏。
- Key step:最小化 MSE 求 (w, b),用闭式最小二乘解或梯度下降。
- Advantages:形式最简单、参数可解释、有闭式解、训练快、可用基展开表达非线性。
- Limitations:只能表达对参数线性的关系;平方损失对离群点敏感;特征尺度不一致时梯度下降收敛慢;特征多时容易过拟合。课件本页没给答案,以上按本讲内容整理。
完整例题
本讲课件的例题都是讨论题,没有给数据。下面用自编情境把 p.30、p.34–37 的诊断和选模型串成一道计算题。
题面:同一份数据分别用 1 次、3 次、9 次多项式拟合。训练误差依次是 0.48、0.12、0.01;5 折交叉验证的平均验证误差依次是 0.50、0.15、0.85。(a)三个模型各是欠拟合、合适还是过拟合?(b)选哪个次数?(c)9 次模型可以怎么修?给 1 次模型多收集数据有没有用?(d)选完之后测试集怎么用?
第一步,逐个诊断。 1 次:训练 0.48、验证 0.50,两个都大,是大偏差,欠拟合。3 次:两个都小,正常。9 次:训练 0.01 很小、验证 0.85 很大,是大方差,过拟合。
第二步,选次数。 只比验证误差,0.15 最小,选 3 次。训练误差 0.01 最小的 9 次不能选,训练误差随次数只降不升,比它没有意义。
第三步,开药。 9 次是大方差:加正则化、多收集训练数据、或降低次数。1 次是大偏差,多收集数据没用,直线怎么训也贴不上弯的数据,要加特征或换更复杂的模型。
第四步,用测试集。 次数定为 3 之后,在全部训练集上重新训练,再在测试集上报一次分,这个分数不再拿去改模型。
答案:1 次欠拟合、3 次合适、9 次过拟合;选 3 次;9 次用正则化、更多数据或降阶,1 次加数据无效;测试集只在最后报一次分。
变式题(先自己做)
自编情境。用 5 折交叉验证比较 3 次和 6 次多项式。3 次模型五折的验证误差是 0.30、0.26、0.28、0.31、0.25;6 次模型是 0.12、0.45、0.20、0.50、0.18。(a)各自的交叉验证误差是多少,选哪个?(b)6 次模型在第 1、3、5 折上都比 3 次好,能不能说 6 次更好?(c)6 次模型各折误差起伏很大,说明了什么?
提示
交叉验证误差是五个数的平均,比的是平均值。(c)回想方差的定义:换一份数据,结果变多少。
判分点与答案(非官方评分标准)
判分点:① 两个平均值算对;② 按平均值选模型;③ 说出单折结果会随划分波动;④ 把各折起伏大联系到方差大。
(a)3 次:(0.30 + 0.26 + 0.28 + 0.31 + 0.25)/5 = 1.40/5 = 0.28。6 次:(0.12 + 0.45 + 0.20 + 0.50 + 0.18)/5 = 1.45/5 = 0.29。选 3 次。
(b)不能。赢的折数多不代表平均更低,单折的结果随划分而波动,交叉验证就是为了取平均来抵消这种波动。
(c)6 次模型换一份验证数据,误差从 0.12 跳到 0.50,对数据的变化很敏感,这是方差大的表现。
闪卡自测
1. 靶盘图上「弹孔紧凑但偏离靶心」是哪种情况?
低方差、高偏差:预测彼此很接近,但平均起来离真值远(p.32)。
2. 同一批点重复抽样训练多次,直线和高阶多项式谁的方差大?
高阶多项式。几十条直线几乎重叠,方差小;高阶曲线四处乱飞,方差大(p.33)。
3. 误差—复杂度曲线的左半段和右半段,误差主要来自什么?
左半段主要来自偏差,右半段主要来自方差(p.34)。
4. 训练误差 0.5、测试误差 0.52,是偏差大还是方差大?该加数据还是加特征?
偏差大(欠拟合);加特征或换更复杂的模型,仅加数据通常不能解决模型表达力不足(p.34–35)。
5. 训练误差 0.01、测试误差 0.9,三种修法?
正则化、更多训练数据、简化模型(p.36)。
6. 为什么不能用测试集选多项式次数?5 折交叉验证怎么做?
用测试集选模型等于把它并入训练过程,分数虚高;把训练集切 5 份,轮流拿 1 份当验证集、其余 4 份训练,5 个验证误差取平均再选(p.37)。
7. public 测试集和 hidden 测试集有什么区别?
这是竞赛平台的设定:公开榜和隐藏榜,隐藏榜的标签你永远看不到(p.37)。
8. 线性模型四问是哪四问?
Assumption、Key step、Advantages、Limitations:假设、关键步骤、优点、局限,本课每个算法都要能这样回答(p.38)。
下一讲
L03a Logistic Regression:把线性模型的 wᵀx + b 套上一层 sigmoid 去做分类,损失从 MSE 换成交叉熵,训练还是梯度下降。这一页的验证集和偏差、方差诊断,到分类问题上照样适用。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。