L02a-2 梯度下降:没有公式时,顺着坡一步步走到谷底
从一维抛物线开始,一步一步跑梯度下降,再推广到 w、b 两个参数同时更新,最后讲学习率太大太小、碗形和多坑损失的区别。
一句话版
梯度下降从随便一组参数出发,看脚下的坡往哪边低,就往那边挪一小步,挪完再看,重复到损失不再明显下降。它只要求会求导,不需要解方程。
上一页 L02a 用闭式解一次算出了最优的 w、b,这一页换一条通用的路走到同一个点。求导和偏导数在上一页的「先补一块」里讲过。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 梯度 | gradient | 所有偏导数排成的一组数,指向损失升得最快的方向 |
| 梯度下降 | gradient descent | 每一步都往梯度的反方向挪 |
| η | 读「伊塔」,学习率 learning rate | 每一步迈多大,人事先定好 |
| ε | 读「艾普西隆」,阈值 | 损失小到多少就算够了 |
| 迭代 | iteration | 「算梯度、更新一次」叫一轮 |
| 凸函数 | convex function | 碗形的函数,只有一个碗底 |
| 局部极小 | local minimum | 某个小坑的坑底,未必是整条曲线最低 |
一个类比:雾里下山
你站在山坡上,大雾,只看得清脚下一小块。想走到谷底,最朴素的办法是:用脚试一试,哪边往下倾就往哪边迈一步,站稳了再试,再迈。
坡陡的地方,一步能下降很多。快到谷底时坡变缓,同样的力气迈出去,高度只降一点点。这就是梯度下降:脚下的倾斜程度是导数,迈步的力气是学习率。
类比在哪里失效:
- 下山的人迈步大小可以随时调整。基本的梯度下降里学习率 η 是固定的,步子变短完全是因为坡变缓了。
- 山可能有好几个山谷,雾里的人走进哪个算哪个。线性回归的损失只有一个碗底,没有这个问题;后面的神经网络才会遇到。
从零讲起
1. 一维的梯度下降:一步一步往坡下走
它解决什么问题
上一页的闭式解要靠「令导数为 0 再解方程」。方程解不出来时怎么办?后面的神经网络大多是这种情况。梯度下降只需要能算出某一点的导数,就能一步步靠近最低点。
从哪来(补充)
梯度下降一般归于法国数学家 Augustin-Louis Cauchy,他在 1847 年首次提出这个方法。Jacques Hadamard 在 1907 年独立提出了类似的方法。
出处:Wikipedia: Gradient descent
直觉
导数为负,说明往右走在下坡,那就把 w 调大;导数为正,说明往右走在上坡,那就把 w 调小。两种情况合起来就是一句话:往导数的反方向走。
走多远?用「学习率 × 导数」。坡陡时导数大,一步走得远;坡缓时导数小,一步走得近。
一步一步看
目标:用 (w − 3)² 从 w = 0 走三步,看学习率不变时步子为什么越走越短。
拿 L(w) = (w − 3)² 来走。它的导数是 L′(w) = 2(w − 3),最低点在 w = 3。从 w = 0 出发,学习率 η = 0.25。
-
第 0 步:w = 0,导数 L′(0) = −6,是负的,往右走。走的距离 = 0.25 × 6 = 1.5,所以 w 变成 1.5。
-
第 1 步:w = 1.5,导数 L′(1.5) = −3,还是往右。走 0.25 × 3 = 0.75,w 变成 2.25。
-
第 2 步:w = 2.25,导数 L′(2.25) = −1.5。走 0.375,w 变成 2.625。
-
三步走下来,每一步都比上一步短一半。η 一直是 0.25 没变,变短的原因是坡越来越缓。
-
再走下去,w 会无限靠近 3,但每次只走剩下距离的一半。所以要规定什么时候停。
怎么算
课件把算法写成四步:
- 随机初始化 w⁰。
- 算 L(w)。如果 L(w) < ε,就结束。
- 求导数 dL/dw。
- 更新
w¹ = w⁰ − η · dL/dw,回到第 2 步。
意思是:新的 w 等于旧的 w 减去「学习率乘坡度」。减号保证了方向永远和导数相反。
拿上面的例子验证第一步:w¹ = 0 − 0.25 × (−6) = 0 + 1.5 = 1.5。负负得正,w 往右走了。
为什么每步正好缩短一半?把更新式展开:
w − 3 的新值 = (w − 3) − 0.25 × 2(w − 3) = (1 − 0.5)(w − 3) = 0.5 × (w − 3)
意思是:每走一步,到谷底的距离乘 0.5。这只对这条抛物线成立,换了函数比例会变,但「越近步子越短」的规律不变。
第 2 步的判停条件在真实数据上很难触发。数据有噪声,最小的损失本身就可能比 ε 大。所以实际都会加一条:最多迭代多少轮。课件的 demo 设 2000 轮,大约 300 轮后损失就不再变化。
常见误解
以为更新量 −η·dL/dw 总是负的,w 只会越来越小
η 恒正,但导数有正有负。谷底右侧导数为正,w 减小;左侧导数为负,w 增大。不变的只有「方向与导数相反」。
以为步子变短是因为学习率在变小
基本的梯度下降里 η 是固定的。每步的位移是 η × |导数|,越靠近谷底导数越小,位移自动变小。
试一下
L(w) = (w − 3)²,从 w = 5 出发,η = 0.25,走两步。w 依次变成多少?方向对吗?
L′(5) = 2 × 2 = 4,w¹ = 5 − 0.25 × 4 = 4。L′(4) = 2,w² = 4 − 0.25 × 2 = 3.5。
起点在谷底右边,导数为正,w 往左减小,方向对。到谷底的距离从 2 变成 1 再变成 0.5,每步减半。
2. 两个参数:w 和 b 同时更新
它解决什么问题
线性回归有 w 和 b 两个参数,损失 L(w,b) 是一个二维的碗。一维的走法要推广到二维:每个参数各算各的偏导数,各自往自己的反方向挪。
直觉
站在二维的碗里,东西方向的坡度是 ∂L/∂w,南北方向的坡度是 ∂L/∂b。两个方向各迈一步,合起来就是往碗底斜着走了一步。
两个参数要用同一时刻的旧值来算偏导数,算完再一起更新。先更新 w、再用新 w 去算 b 的偏导,就不是标准的梯度下降了。
一步一步看
目标:用三个点让 w 和 b 同时走两步,看第一步冲过闭式解后,第二步怎样被拉回来。
三个点 (1,2)、(2,4)、(3,5),从 (w,b) = (0,0) 出发,η = 0.1。上一页算出的闭式解是 w = 1.5、b = 0.667。
-
起点 (0, 0):所有预测都是 0,损失 L = 15.000。两个偏导数分别是 ∂L/∂w = −16.667、∂L/∂b = −7.333,都是负的,w 和 b 都往大里调。
-
第 1 步:w = 0 + 0.1 × 16.667 = 1.667,b = 0 + 0.1 × 7.333 = 0.733。损失掉到 0.234。
-
注意 w 已经冲过了闭式解 1.5。第 1 步的坡太陡,一步迈过头了。
-
第 2 步:在 (1.667, 0.733) 处,两个偏导数变成 +1.822 和 +0.800,变成正的,于是往回拉。走到 (1.484, 0.653),损失 0.058,已经贴近闭式解的 0.0556。
怎么算
MSE 是 L(w,b) = (1/N) Σ (ȳⁿ − wxⁿ − b)²。分别对 w 和 b 求偏导。
对 w:把 b 当常数。括号里对 w 的导数是 −xⁿ,用链式法则,
∂L/∂w = (1/N) Σ 2(ȳⁿ − wxⁿ − b) · (−xⁿ) = −(2/N) Σ xⁿ(ȳⁿ − wxⁿ − b)
意思是:每个样本的残差乘上它自己的 x,加起来,再乘 −2/N。
对 b:把 w 当常数。括号里对 b 的导数是 −1,
∂L/∂b = −(2/N) Σ (ȳⁿ − wxⁿ − b)
意思是:所有残差加起来,乘 −2/N。残差总体为正(预测偏低),偏导为负,b 就往大里调。
同时更新:
w¹ = w⁰ − η · ∂L/∂w,b¹ = b⁰ − η · ∂L/∂b,两个偏导都在 (w⁰, b⁰) 处算。
拿起点验证。(0,0) 处残差就是 y 本身:2、4、5。
Σ xⁿ · 残差 = 1×2 + 2×4 + 3×5 = 25,∂L/∂w = −(2/3) × 25 = −16.667Σ 残差 = 2 + 4 + 5 = 11,∂L/∂b = −(2/3) × 11 = −7.333
和上面的数对上了。
线性回归加 MSE 的情况下,学习率合适、迭代够多,梯度下降会收敛到闭式解那一点。课件 demo 跑完 2000 轮得到的 w 与闭式解一致,换算回原始尺度是「房价 ≈ 107.1 × 面积 + 18569」。
常见误解
以为梯度下降和闭式解会得到不同的答案
对线性回归 + MSE,学习率合适、迭代够多,梯度下降就收敛到闭式解那一点。两者的区别只在怎么到达:一个解方程一次到位,一个一步步逼近。
算偏导时用了均值 ȳ
偏导数里的 ȳⁿ 是每个样本自己的真值。起点 (0,0) 处每个残差就是各自的 y,要逐个乘 xⁿ 再相加,不能拿均值代替。
试一下
两个点 (1,1)、(2,2),从 (w,b) = (0,0) 出发,η = 0.1。算两个偏导数,走一步。
起点残差就是 1、2。∂L/∂w = −(2/2)(1×1 + 2×2) = −5,∂L/∂b = −(2/2)(1 + 2) = −3。
w¹ = 0 − 0.1 × (−5) = 0.5,b¹ = 0 − 0.1 × (−3) = 0.3。
3. 学习率、碗形和多坑的损失
它解决什么问题
课件问:梯度下降每一步损失一定下降吗?答案取决于两件事:学习率选得合不合适,损失是不是只有一个坑。这一节讲怎么判断会不会出问题。
直觉
学习率太小,每步只挪一点点,走很久才到。学习率太大,一步跨过谷底落到对面更高的地方,下一步又跨回来,越跳越高。
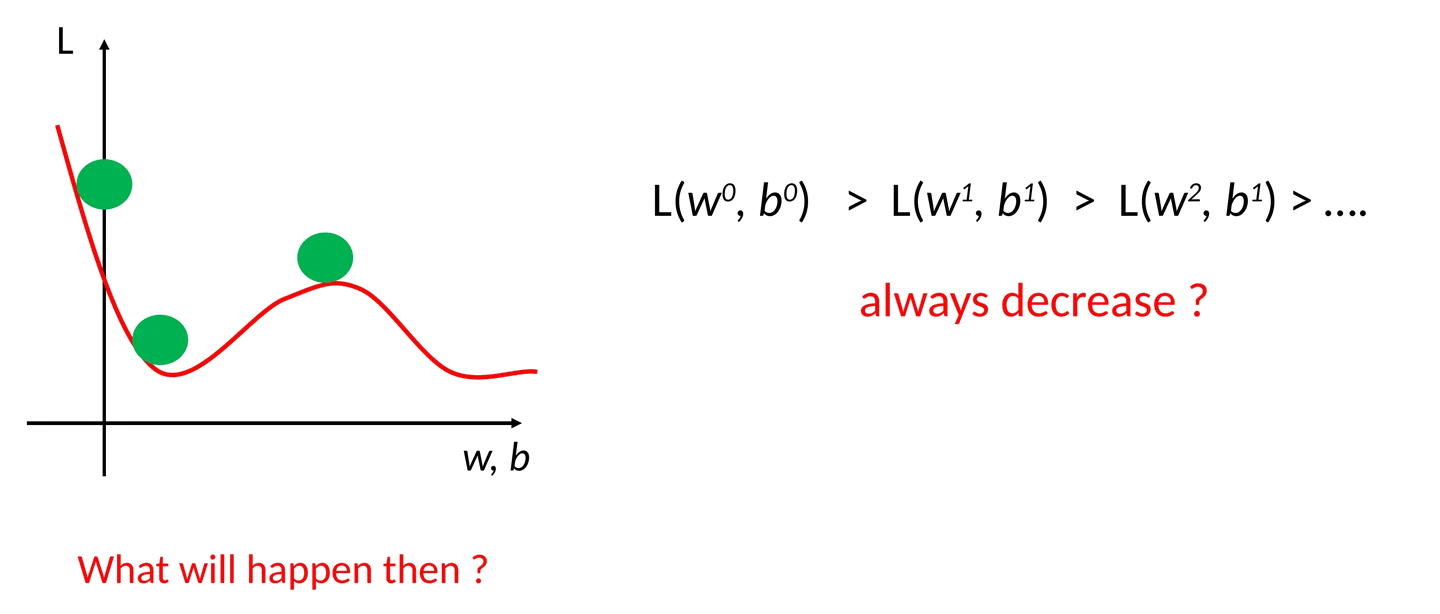
另一种情况是损失曲线有好几个坑。梯度下降只看脚下,走到哪个坑底,导数都是 0,它就停下了。这个坑未必是最深的。
一步一步看
目标:同一条抛物线换三个学习率各走三步,再换一条两个坑的曲线,看太慢、发散和停在浅坑三种结局。
还是 L(w) = (w − 3)²,都从 w = 0 出发,只换学习率。
-
η = 0.05:三步后 w 才到 0.81 左右,离谷底 3 还很远。方向对,就是太慢。
-
η = 0.25:三步后到 2.625,已经贴近谷底。
-
η = 1.1:第一步跳到 6.6,跨过了谷底;第二步跳到 −1.32,又跨回来,而且离谷底更远。损失越来越大,这叫发散。
-
换一条有两个坑的曲线。起点甲在左边,一路下坡掉进左边较浅的坑,停在那里;起点乙在右边,掉进右边更深的坑。
-
甲停下的地方导数也是 0,梯度下降分不出这是不是最深的坑。
怎么判断
学习率会不会太大,可以用 L(w) = (w − 3)² 算出来。更新式是 w − 3 的新值 = (1 − 2η)(w − 3)。
意思是:每走一步,到谷底的距离乘上 (1 − 2η)。
- 这个数的绝对值小于 1,距离越来越小,会收敛。也就是 0 < η < 1。
- η = 0.25 时乘 0.5,每步减半,走得稳。
- η = 1.1 时乘 −1.2,符号翻转表示跳到对面,绝对值大于 1 表示越跳越远,发散。
- η = 0.05 时乘 0.9,每步只缩一成,慢。
不同的函数,安全的学习率范围不一样。实际做法是先试几个值,看损失曲线:一路平稳下降就合适,上下乱跳或越来越大就是太大,降得极慢就是太小。
损失会不会把人困在浅坑里,看它是不是凸函数(碗形)。凸函数只有一个碗底,没有别的坑。线性回归配 MSE 的损失是关于 w、b 的二次函数,开口向上,是凸的,所以不存在「停在一个不是最低的坑里」的问题,学习率合适就到闭式解。后面讲的神经网络,损失通常不是凸的,那时才要担心局部极小。
常见误解
以为梯度下降每一步损失都一定下降
学习率太大时会跨过谷底,损失反而上升,甚至发散。课件写 L(w⁰,b⁰) > L(w¹,b¹) > … 再问 always decrease?,答案是不一定。
以为线性回归用梯度下降也会掉进局部极小
线性回归 + MSE 的损失是凸的碗,只有一个最低点。它的风险是学习率太大发散,或者太小收敛慢,没有局部极小的问题。
试一下
L(w) = (w − 3)²,η = 0.5,从 w = 0 出发走一步,会到哪?η = 1 呢?
η = 0.5 时乘数 1 − 2 × 0.5 = 0,w¹ = 0 − 0.5 × (−6) = 3,一步直接到谷底。
η = 1 时乘数 1 − 2 × 1 = −1,w¹ = 0 − 1 × (−6) = 6,跳到对面同样高的位置;再走一步又回到 0,永远在两边来回跳,不收敛也不发散。
把它们串起来
梯度下降的核心只有一行:新参数 = 旧参数 − 学习率 × 偏导数。一维时它沿着抛物线往下走,坡越缓步子越短。两个参数时每个参数各求偏导,用同一时刻的值一起更新。
它能不能走到最低点,看两件事。学习率要合适,太大会跳过谷底甚至发散,太小走得太慢。损失要是碗形,线性回归配 MSE 正好满足,所以梯度下降会走到和闭式解同一个点。
判停不能只靠「损失小于 ε」,要加最大迭代次数。下一页回到四个阶段的 Stage 3:训练好的直线怎么评估,贴不上数据时怎么办。
课件里的坑
- [课件有误] p.23 不等式链写成
L(w⁰,b⁰) > L(w¹,b¹) > L(w²,b¹),第三项的 b 下标按上下文应改为L(w²,b²)。 - [补充] p.21 的判停条件「损失小于 ε」在真实数据上很难触发。demo 的误差平方和量级是 10¹²、阈值 10⁻⁴,实际靠 2000 轮上限结束。
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先默写梯度下降四步和两个偏导数公式。然后把「完整例题」自己从头算一遍,再做「变式题」。最后回查两个最容易错的地方:偏导数前面的负号和 2/N 系数,以及两个参数要用旧值同时更新。
必背
- 梯度下降四步:随机初始化 → 算损失判停 → 求梯度 → w ← w − η·∂L/∂w;更新方向永远与梯度相反,每步实际位移 η·|梯度| 随梯度变小,η 本身不变,必须设最大迭代次数。
- 更新项 −η·dL/dw 不恒为负:谷底右侧导数为正、w 减小,左侧导数为负、w 增大,不变的只有「方向与导数相反」。
- 两个参数时各求偏导、用同一轮的旧值同时更新:∂L/∂w = −(2/N)Σxⁿ(ȳⁿ−wxⁿ−b),∂L/∂b = −(2/N)Σ(ȳⁿ−wxⁿ−b)。
- 学习率太大会跨过谷底甚至发散,太小收敛很慢;非凸损失有多个局部极小,梯度下降只保证停在某一个局部极小。
- 线性回归 + MSE 的损失是凸的碗,学习率合适、迭代够多时梯度下降收敛到闭式解。
课件例题
例 1(课件 p.21):梯度下降四步里的三个问题
题面:四步是随机初始化 w⁰;算 L(w),若 L(w) < ε 就结束;求 dL/dw;更新 w¹ = w⁰ − η·dL/dw,再回第二步。课件问:每一步的步子一样大吗?更新项总是负的吗?循环停不下来怎么办?
提示
每步位移等于 η 乘什么?导数在谷底两侧符号一样吗?数据有噪声时,最小的损失能小于任意给定的 ε 吗?
解答
- 步子不一样大。每步位移是 η 乘导数,越靠近谷底导数越小,步子自动变短。η 本身不变。
- 更新项 −η·dL/dw 不一定是负的。谷底右侧导数为正,w 减小;左侧导数为负,w 增大。方向永远与导数相反。
- L < ε 可能永远达不到,数据有噪声,最小 MSE 未必小于 ε。要加最大迭代次数,或改用「相邻两步 L 的变化小于 ε」判停。
例 2(课件 p.23):梯度下降一定下降吗
题面:课件写 L(w⁰,b⁰) > L(w¹,b¹) > …,问 always decrease? 下方画了一条非凸曲线,三个球分别在左侧陡坡上、左边低谷里和中间小山顶上,问 What will happen then?
提示
分两种情况想:学习率太大会怎样?曲线有好几个坑时,从不同地方出发会停在哪?
解答
- 学习率太大时不一定下降:步子跨过谷底跳到对面更高处,甚至发散。
- 非凸函数有多个局部极小,从不同初始点出发会停在不同的坑,只保证到某个局部极小。
- 线性回归加 MSE 的损失是凸的碗,学习率合适就收敛到闭式解;非凸问题出现在后面的神经网络。
完整例题
题面(按注解版自测题整理):训练点 (1,2)、(2,4)、(3,5),模型 y = wx + b,损失用 MSE。从 (w,b) = (0,0) 出发,η = 0.1,做两步梯度下降,每步写出损失、两个偏导数和更新后的参数,并和闭式解 w = 1.5、b = 0.667 比较。
第 0 步,在 (0, 0)。
- 预测全为 0,残差就是 y:2、4、5。
- 损失 L = (4 + 16 + 25)/3 = 45/3 = 15.000。
- ∂L/∂w = −(2/3)(1×2 + 2×4 + 3×5) = −(2/3)(25) = −16.667。
- ∂L/∂b = −(2/3)(2 + 4 + 5) = −(2/3)(11) = −7.333。
- 更新:w¹ = 0 − 0.1 × (−16.667) = 1.667,b¹ = 0 − 0.1 × (−7.333) = 0.733。
第 1 步,在 (1.667, 0.733)。
- 预测:1.667 + 0.733 = 2.400,3.333 + 0.733 = 4.067,5.000 + 0.733 = 5.733。
- 残差:2 − 2.400 = −0.400,4 − 4.067 = −0.067,5 − 5.733 = −0.733。
- 损失 L = (0.160 + 0.004 + 0.538)/3 ≈ 0.234。
- ∂L/∂w = −(2/3)(1×(−0.400) + 2×(−0.067) + 3×(−0.733)) = −(2/3)(−2.733) ≈ +1.822。
- ∂L/∂b = −(2/3)(−0.400 − 0.067 − 0.733) = −(2/3)(−1.200) = +0.800。
- 更新:w² = 1.667 − 0.1 × 1.822 ≈ 1.484,b² = 0.733 − 0.1 × 0.800 = 0.653。
第 2 步,在 (1.484, 0.653)。 回算损失 ≈ 0.058。
比较。 闭式解的 MSE ≈ 0.0556。第一步 w 从 0 冲到 1.667,越过了 1.5;第二步偏导数变号,w 被拉回 1.484。两步后损失已经很接近最优,但还没到。
答案:两步后 (w, b) ≈ (1.484, 0.653),损失从 15.000 降到 0.234 再到 0.058,最优是 0.0556。
变式题(先自己做)
自编情境。训练点 (1,2)、(2,3)、(3,7),这组点的最小二乘解是 w = 2.5、b = −1,最优 MSE = 0.5(上一页变式题)。从 (w,b) = (0,0) 出发、η = 0.1 做一步梯度下降,并比较这一步之后的损失和最优 MSE 差多少。
提示
起点处残差就是 y 本身。注意两件事:偏导数前面的负号,以及 2/N 里的 N 这里是 3。参数保留分数到最后再回算损失,避免中途舍入。
判分点与答案(非官方评分标准)
判分点:① 起点损失算对;② 两个偏导数的负号和 2/3 系数都在;③ 用精确参数回算损失;④ 最后说出「一步 ≠ 收敛」。
- 起点 (0,0):预测全为 0,误差就是 y 本身 2、3、7,L = (4 + 9 + 49)/3 ≈ 20.67。
∂L/∂w = −(2/3) Σ x(y − ŷ) = −(2/3)(1×2 + 2×3 + 3×7) = −(2/3)(29) ≈ −19.33;∂L/∂b = −(2/3)(2 + 3 + 7) = −8。- 更新:w = 29/15 ≈ 1.93333,b = 0.8。
- 用精确参数回算,L = 782/675 ≈ 1.15852,比最优 MSE = 0.5 高 889/1350 ≈ 0.65852。一步更新使损失下降,但不等于已经收敛。
闪卡自测
1. 梯度下降的四步是什么?
随机初始化 w⁰;算 L(w),小于 ε 就停;求 dL/dw;更新 w¹ = w⁰ − η·dL/dw,回到第二步(p.21)。
2. 梯度下降的更新量 −η·∂L/∂w 恒为负吗?
否。η 恒正,但导数有正有负,谷底右侧 w 减小、左侧 w 增大;不变的只有「方向与梯度相反」(p.21)。
3. η 不变,为什么越靠近谷底步子越短?
每步位移是 η × |导数|,越靠近谷底坡越缓、导数越小,位移跟着变小(p.21)。
4. 两个参数为什么要「同时」更新?
两个偏导数都应该在同一个点 (w⁰, b⁰) 处算。先更新 w 再用新 w 算 b 的偏导,就换成了另一种算法(p.22)。
5. 学习率太大会怎样?线性回归的梯度下降会掉进局部极小吗?
太大会跨过谷底跳到更高处甚至发散;线性回归 + MSE 的损失是二次函数、只有一个最低点,不会有局部极小问题(p.20, p.23)。
6. demo 里「误差平方和小于 10⁻⁴ 就停」为什么从没触发过?
这份数据的误差平方和量级是 10¹²,这个条件永远触发不了,实际靠 2000 轮上限结束(p.21, p.40)。
7. 梯度下降和闭式解在线性回归上会得到不同的 w 吗?
不会。学习率合适、迭代够多,梯度下降收敛到闭式解那一点;demo 跑完 2000 轮得到的 w 与闭式解一致(p.40)。
下一讲
L02b 评估模型与多项式基展开:训练好的直线拿到没见过的数据上表现如何,贴不上弯的数据时怎么给表格加一列 x²,加完为什么还是线性模型。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。