L08b 相关不是因果、分布偏移和类别不平衡:模型为什么学歪
从零讲清相关谬误怎样骗过人、训练和测试的分布不同为什么让模型失灵、类别不平衡时决策边界怎样被多数类推开、准确率 99.997% 为什么可能毫无用处,以及加权和重采样怎样让少数类追上来。
一句话版
模型会把数据里的巧合当规律、把训练时见过的世界当全部、把数量多的类别当答案;看穿巧合、检查分布、让少数类在训练里分量够,是这一页的三件事。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 相关谬误 | correlation fallacy | 把「一起变」当成「一个导致另一个」 |
| 相关系数 | r | 衡量两组数一起变的程度,取值 −1 到 1,越接近 ±1 越同步,接近 0 几乎不一起变 |
| 过度泛化 | overgeneralization | 拿一小撮不多样的数据下全局结论 |
| 分布偏移 | distribution shift | 用的时候遇到的数据和训练时的不一样 |
| 类别不平衡 | class imbalance | 某一类的样本远少于另一类 |
| 决策边界 | decision boundary | 模型心里把两类分开的那条线 |
| 加权 | weighting | 给数量少的类别每个样本更大的分量 |
| 重采样 | resampling | 让数量少的类别在训练时被多抽几次 |
一个类比:只看过晴天的新司机
一位新司机只在晴天的白天练车,练了一百次,九十九次路上没有行人。
他从中得出两条「规律」。一条是「开快不会出事」:晴天他开得快,晴天也从没出过事;其实是晴天同时让他敢开快、也让路况安全。另一条是路上基本没人,所以不用看人行道。
第一条把巧合当因果。第二条把练车时的路当成了所有的路。
真遇到雨夜和放学时的校门口,这两条规律都会出事。那唯一一次有行人的经历,在一百次里分量太轻,被他忘了。
类比在哪里失效:
- 司机能自己意识到「没在雨里开过」;模型不会,它只会照样输出一个很自信的答案。
- 司机可以多去练几次夜路;模型要靠人去补数据、改权重。
- 一次有行人的经历,人会记很久;模型里少数类的分量只取决于数量和权重。
从零讲起
1. 相关不是因果
它解决什么问题
做数据分析,最容易得到的结论是「两件事同涨同落」。下一步就很想说「一个导致另一个」。
课件把这一步叫相关谬误,归在「解读造成的偏见」里:数据本身没错,错在人怎么读。
从哪来(补充)
课件第一张图改自 Tyler Vigen 收集的巧合相关图表。原图是美国计算机科学博士授予数和街机厅收入,r = 0.985。出处:Spurious Correlations。
直觉
两件毫不相干的事,只要都随着年份往上走,画在一张图上就会贴得很紧。
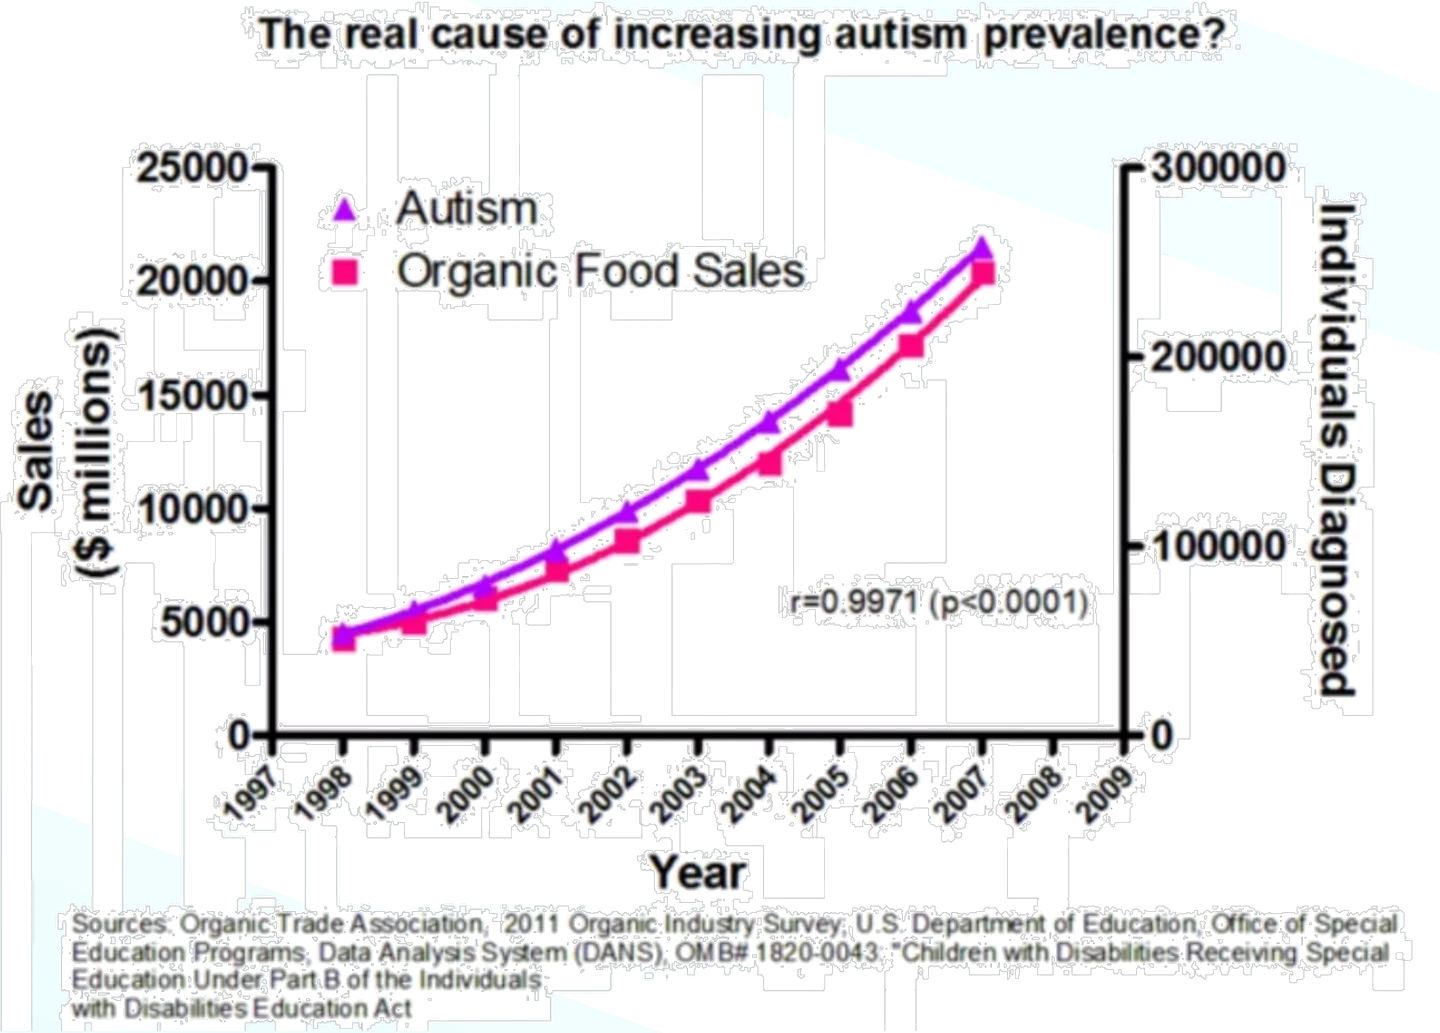
课件的第二张图更极端:有机食品销售额和自闭症诊断人数,十年间几乎重合,相关系数接近 1。
没有人会因此说吃有机食品导致自闭症。两者都在随时间增长,时间才是背后的那个变量。
一步一步看
目标:先读课件的有机食品图,再拿「冰淇淋与溺水」逐步判断,练习三问:相关吗、有第三个变量吗、结论站得住吗。
-
判断两件事是否相关。
-
找有没有第三个变量。
-
判断结论。
怎么判断
判断口诀:看到同涨同落,先找时间和第三个变量。
| 情况 | 能不能说因果 |
|---|---|
| 两条曲线都随年份上升 | 不能,可能只是共同的时间趋势 |
| 有一个变量同时推动两者 | 不能,那是混杂因素 |
| 做了对照实验,只改一个因素 | 才有条件谈因果 |
意思是:相关系数只说明「一起变」,说不出「谁导致谁」。
常见误解
误解:相关系数接近 1 就说明有因果
课件的有机食品图相关系数 0.9971,两件事仍然没有因果关系。r 只衡量同步程度。
误解:相关谬误是数据错了
数据可以完全准确。课件把它归在解读造成的偏见里,错在下结论的那一步。
试一下
模型发现「用某款手机的用户贷款违约率低」,于是给这款手机的用户提高额度。这样做有什么问题?
答案
手机型号和还款能力只是相关,背后可能是收入这个第三变量。把它当成因果来定额度,是相关谬误,还会让收入低的人更难借到钱。
2. 过度泛化和分布偏移
它解决什么问题
模型在测试集上表现很好,于是大家放心上线。上线后却频频出错。
原因常是测试集太窄:它和训练集长得一样,和真实世界不一样。拿这样的结果说「对所有情况都好」,就是过度泛化。
从哪来(补充)
课件的卫星图表格属于 WILDS 这类分布偏移基准。WILDS 由 Koh 等 2020 年发布,其中卫星图像任务的偏移来自时间和地区。出处:arXiv 2012.07421。
直觉
课件的杯子例子:数据集里的杯子都是正放着拍的;现实里的杯子会侧倒、会被俯拍、会只露半边。
模型只见过正放的杯子,遇到侧倒的就认不出。课件的结论:分布偏移会造成神经网络的偏见。
一步一步看
目标:读课件的卫星图表格,逐步找出训练和测试在哪两个方面不一样。
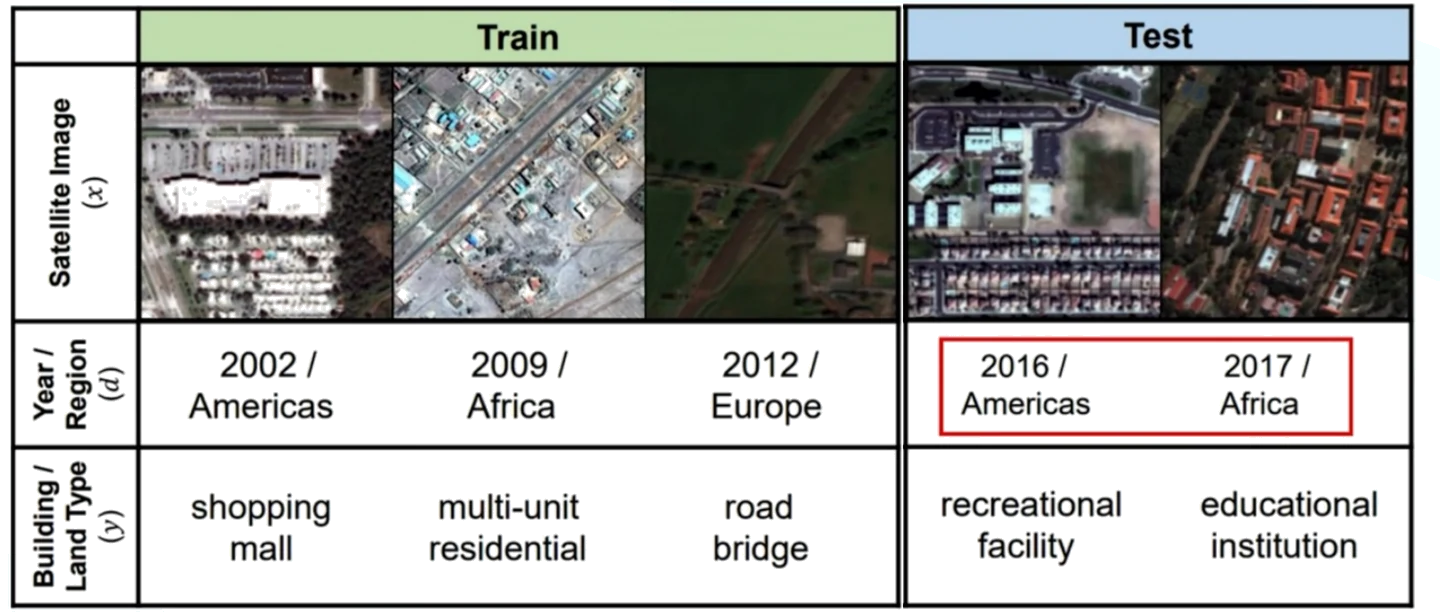
-
比较年份。
集合 年份 训练 2002、2009、2012 测试 2016、2017 -
比较地区和类别。
集合 地区 建筑或用地类型 训练 美洲、非洲、欧洲 购物中心、多户住宅、公路桥 测试 美洲、非洲 娱乐设施、教育机构 -
下结论:时间往后移了,地区和建筑样子也变了。训练时表现好,不代表在测试这几年、这几个地方也好。
怎么判断
判断口诀:问三句:测试数据从哪来、什么时候的、像不像真实使用的场景。
| 信号 | 风险 |
|---|---|
| 测试集和训练集来自同一批数据 | 看不出分布偏移 |
| 部署地区或年份和训练时不同 | 可能失灵 |
| 用一个测试集就宣称「对所有人都好」 | 过度泛化 |
意思是:测试集要尽量像真实使用的场景,宣传时只说测过的范围。
常见误解
误解:测试准确率高就说明模型泛化好
如果测试集和训练集来自同一个分布,准确率高只说明模型适应了这个分布,换个时间和地区可能就不行。
误解:分布偏移只是技术问题,和偏见无关
课件明说分布偏移会造成神经网络偏见:没被训练数据覆盖的人群和场景,表现就系统性地差。
试一下
一个只用城市道路照片训练的自动驾驶识别模型,要在乡村测试。这属于哪种问题?
答案
分布偏移:部署场景和训练数据的分布不同。如果只在城市测完就宣称处处可用,还是过度泛化。
3. 类别不平衡:模型为什么「全猜多数类」
它解决什么问题
现实中很多要找的东西本来就少:罕见病、诈骗交易、设备故障。
数据里这一类很少,模型就会偷懒:多数时候猜多数类,准确率照样很高。课件用一组决策边界的动画讲这件事。
直觉
训练时,模型每一步都在挪动决策边界,让判错的点变少。
如果 20 个点是多数类、1 个是少数类,每次挪动几乎都是为了照顾那 20 个点。
挪着挪着,边界就越过了那唯一的少数类点。模型整体只错了 1 个,看起来很好,可它要找的那一类全错了。
一步一步看
目标:跟着三帧图看边界怎样被多数类推开,再用课件的 GBM 数字算出那个「好看却没用」的准确率。
-
随机初始化一条边界。
-
每次更新都主要照顾多数类,边界被推向右边。
-
边界越过了唯一的少数类点。
-
换成课件的真实例子:用核磁共振图像检测胶质母细胞瘤。
项目 数字 美国发病率 3.19 / 100,000 数据集里健康 99.997% 数据集里患病 0.003% 永远回答「健康」的准确率 99.997% 这个模型找出的病人数 0
怎么判断
判断口诀:类别越不平衡,越不能只看整体准确率。
| 情况 | 该看什么 |
|---|---|
| 两类数量相近 | 整体准确率有参考价值 |
| 一类远少于另一类 | 分开看每一类的准确率,尤其是少数类 |
| 漏掉少数类代价很大(疾病、诈骗) | 少数类的召回最重要 |
意思是:不平衡时整体准确率主要反映多数类,要找的那一类表现得单独看。
常见误解
误解:准确率接近 100% 的模型一定好用
GBM 的例子里,什么都不学、永远答「健康」就有 99.997%,却一个病人都找不出来。
误解:数据集比例和现实一样才「真实」,所以最好
课件正是用这个问题提醒:照现实比例收数据,少数类在训练里几乎没有分量,模型学不会它。
试一下
一万笔交易里有 10 笔是诈骗。永远回答「正常」的模型准确率是多少?它有用吗?
答案
准确率 = 9990 ÷ 10000 = 99.9%,但一笔诈骗都抓不到,没有用。
4. 平衡数据:加权和重采样
它解决什么问题
知道少数类分量太轻,下一步就是把它的分量加回来。课件给了两种做法,都是改训练过程,不用去造新数据。
直觉
先看两类数量一样时会怎样:每次更新,两类说话一样大声,边界停在中间,把两类分开。
数量没法一样时,就从分量上补:
- 加权:数量少的类别,每个样本的权重大。频率 × 权重 = 相等的贡献
- 重采样:数量少的类别,每个样本被抽进训练批次的概率大
一步一步看
目标:用课件的 1:20 比例,一步步算出少数类要多大的权重才能和多数类贡献相等。
-
写出两类的数量。
类别 数量 多数类 20 少数类 1 -
要求贡献相等,算少数类的权重。
类别 频率 权重 贡献 多数类 20 1 20 少数类 1 20 20 -
换成重采样的说法:少数类那个点被抽中的概率要是多数类每个点的 20 倍。
怎么判断
判断口诀:权重和数量成反比,乘起来一样大。
| 做法 | 改的是什么 | 课件的图 |
|---|---|---|
| 加权 | 每个样本对误差的分量 | 频率 × 权重 = 贡献 |
| 重采样 | 每个样本被抽中的概率 | 点画得越大,越容易被抽中 |
意思是:两种做法目标一样,都是让少数类在训练里的总分量追上多数类。
常见误解
误解:加权就是把少数类样本复制很多份
复制是重采样的一种粗做法。加权不改数据,只改每个样本在误差里算多少。
误解:平衡了类别数量,偏见就消失了
类别之间平衡了,每一类内部还可能藏着不平衡,比如人脸类里某种发色很少。这一点下一页展开。
试一下
多数类 300 个、少数类 15 个,多数类权重 1,少数类权重应是多少?
答案
300 ÷ 15 = 20,少数类权重 20,两类贡献都是 300。
把它们串起来
模型学歪有三条常见的路。
第一条在人:把一起变当成谁导致谁。课件的两张图里,两件事走势几乎重合,背后只是时间。
第二条在数据的范围:训练和测试只覆盖了某些年份、地区、角度,模型在没见过的地方失灵,人却以为它处处好用。
第三条在数据的比例:少数类太少,边界被多数类推开,整体准确率很高,要找的那一类全错。
对付第三条,课件给了加权和重采样,让少数类的分量追上来。
类别之间平衡了,类别内部还有没有偏见,以及怎样系统地减轻偏见,见下一页 L08c。前面的定义和生命周期见 L08a。
课件里的坑
- [课件错误] p.16 两条曲线的名字被改了:原图(Tyler Vigen)是美国计算机科学博士授予数和街机厅收入,r = 0.985;课件写成数据科学博士和游戏中心收入。答题只说「两件无关的事走势重合,推不出因果」即可
- [读图提醒] p.29 的人形图标格子大约 1 个患病对 100 个健康,只是示意;按发病率 3.19 / 100,000 算,真实比例约 1 : 31,300,比图上悬殊得多
- [读图提醒] p.20–23 的柱状图都没有数值,只能说 A、B、C 的相对大小
- [概念提醒] p.23 问「结果无偏了,为什么还是问题」,课件没有直接写答案,接下来用类别不平衡展开;答题可以落到「整体准确率在不平衡时掩盖少数类」
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先默写相关谬误的三问、类别不平衡为什么让边界被推开、加权的公式;再对照课件 p.16–35 做课件例题和变式题;最后回查一个易错点:99.997% 的准确率可以一个病人都找不出。
必背
- 相关谬误:两件事走势重合(r 接近 1)也推不出因果,常有共同的时间趋势或第三个变量
- 过度泛化:用有限、不多样的测试数据得出宽泛结论;分布偏移会造成神经网络偏见
- 类别不平衡时,每次更新主要照顾多数类,决策边界被推开,少数类被判错
- GBM 数据 99.997% 健康、0.003% 患病:全答「健康」的模型准确率 99.997%,却一个病人都找不出
- 加权:频率 × 权重 = 相等的贡献;重采样:少数类被抽中的概率更大
课件例题
例 1(课件 p.16–17):两张相关图
题面:课件两张图里,一组是博士授予数和游戏中心收入,一组是有机食品销售额和自闭症诊断人数(r = 0.9971)。能否得出因果结论?为什么?
提示
两组数据都随什么在变?
解答
不能。两组数据都随年份增长,走势重合来自共同的时间趋势;相关系数只衡量同步程度,不说明谁导致谁。这是相关谬误,属于解读造成的偏见。
例 2(课件 p.18):杯子
题面:数据集里的杯子都是正放着拍的。模型上线后会遇到什么问题?这叫什么?
提示
现实里的杯子都是正放的吗?
解答
现实里的杯子有各种角度,模型只见过正放的,遇到侧倒、俯拍的就认不准。这是分布偏移;如果只用正放杯子测试就说模型好用,还是过度泛化。
例 3(课件 p.19):卫星图分布偏移
题面:训练集是 2002、2009、2012 年的美洲、非洲、欧洲卫星图,测试集是 2016、2017 年的美洲、非洲。偏移在哪两个方面?
提示
对比训练和测试两栏的 Year / Region 一行。
解答
时间和地理区域。测试年份都比训练晚,地区组合和建筑类型也不同。
例 4(课件 p.20–23):照数据集比例学的准确率
题面:现实中三类的频率是 A < B < C,数据集里 B 最少,模型在 B 上的准确率最低。课件说这不是我们想要的。为什么?想要的是什么?
提示
模型的表现跟着谁走?
解答
模型的准确率跟着数据集里的数量走,数据少的类就差,这和现实中谁重要无关。想要的是每一类准确率都一样高,不因为数据里少就被牺牲。
例 5(课件 p.24–28):1:20 的决策边界
题面:少数类和多数类 1:20,分类器随机初始化后逐步更新。说明边界最后为什么会把少数类判错。
提示
每次更新主要在减少谁的错误?
解答
每次更新都为了让判错的点变少,而绝大多数点是多数类,边界就被推着照顾多数类,一直推到越过少数类那一点。整体只错 1 个,少数类却全错。
例 6(课件 p.29):GBM
题面:GBM 美国发病率 3.19 / 100,000。如果数据集照现实比例收集(约 99.997% 健康、0.003% 患病),一个永远答「健康」的模型准确率是多少?会发生什么?
提示
一个什么都不学的模型能拿多少准确率?
解答
永远答「健康」的模型准确率就有 99.997%,却一个病人都找不出来。患病样本在训练里几乎没有分量,模型学不会它;整体准确率在这里毫无意义。
例 7(课件 p.30–35):平衡的两种做法
题面:说出课件让少数类追上来的两种做法及原理。
提示
一张图是乘法式子,一张图是点的大小。
解答
加权:频率 × 权重 = 相等的贡献,少数类每个样本权重大。重采样:点的大小代表训练时被抽中的概率,少数类被抽中的概率更大。两类平衡后,边界能把两类分开。
完整例题
题目:一家银行用过去一年的交易训练诈骗检测模型。10 万笔交易里有 100 笔诈骗。模型测试准确率 99.9%。分析师还发现:「周末交易越多的月份,诈骗也越多,所以应该限制周末交易。」请按本页内容分析。
① 准确率能不能信。永远答「正常」的模型准确率 = 99,900 ÷ 100,000 = 99.9%,和这个模型一样。必须单独看诈骗那一类抓到多少。
② 为什么会这样。诈骗和正常是 1:999,训练更新几乎都在照顾正常交易,边界被推开,诈骗容易被判成正常。
③ 怎么改。诈骗样本加权,权重约为正常样本的 999 倍,或在每个训练批次里多抽诈骗样本。
④ 周末那条结论。周末交易多的月份诈骗多,可能只是交易总量多(第三个变量),这是相关谬误,不能直接推出限制周末交易。
⑤ 上线前。还要检查测试数据是不是和上线后的交易分布一样,比如新的支付方式、新地区的用户,避免分布偏移。
变式题(先自己做)
自编情境:一个识别农作物病害的模型,训练图片全部是在实验室白色背景下、上午拍的叶片,健康叶片 2000 张,病害叶片 100 张。测试集也来自同一实验室,整体准确率 96%。团队准备把它发给农民在田里用手机拍照识别。请指出至少三个问题并给出改法。
提示
分开想:拍摄条件、类别比例、测试集来源、96% 是谁的准确率。
判分点与答案(非官方评分标准)
分布偏移:实验室白底、上午拍,田里背景杂、光线多变,训练和使用的分布不同。
过度泛化:测试集和训练集同源,96% 不能说明在田里也好用。
类别不平衡:健康和病害 20:1,永远答「健康」也有约 95% 准确率;要单独报告病害类的表现。
改法:补田间实拍图片;病害类加权(约 20 倍)或重采样;用田间数据单独测试并分类别报告。
判分点:三个问题各对应一个改法;指出 96% 可能主要来自健康类。
闪卡自测
1. 相关谬误属于哪一组偏见?
解读造成的偏见(p.15–17)。
2. 有机食品和自闭症那张图的相关系数?
r = 0.9971(p.17)。
3. 杯子例子说明什么?
分布偏移会造成神经网络偏见(p.18)。
4. 卫星图例子的偏移在哪两方面?
时间和地理区域(p.19)。
5. 1:20 时边界为什么被推开?
每次更新主要照顾多数类(p.24–28)。
6. GBM 数据里健康和患病的比例?
99.997% 和 0.003%(p.29)。
7. 加权的式子?
频率 × 权重 = 相等的贡献(p.34)。
8. 重采样图里点的大小代表什么?
训练时被抽中的概率(p.35)。
下一讲
下一页 L08c 讲类别内部藏着的偏见、公平的定义、分组和交叉评估,以及对抗训练和学习潜在结构这两种去偏方法。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。