L08a 什么是 AI 偏见:原型、人脸分类的差距和生命周期五站
从零讲清算法偏见的定义、原型和默认怎样变成偏见、怎样按群体读人脸分类表算最大差距、物体识别准确率为什么跟收入和地区有关,以及偏见从生命周期哪一站进来、六种常见偏见怎么分。
一句话版
AI 偏见指模型对不同人群系统性地好用或不好用;它常从人脑里的「默认样子」开始,经过数据、设计、训练、评估、解读任何一站进入系统,要按群体拆开看才看得见。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 算法偏见 | algorithmic bias | 模型对不同群体的预测或表现有系统性的、不想要的差异 |
| 原型 | prototype | 心里某类东西的「标准样子」 |
| 默认 | default | 不加说明时,人自动想到的那一种 |
| 子群体 | subgroup | 按肤色、性别、收入等切出来的一小群人 |
| 最大差距 | largest gap | 同一个模型在各组里最好和最差的准确率之差 |
| 整体指标 | bulk metrics | 把所有人混在一起算出的一个准确率 |
| 生命周期 | life cycle | 从收数据到上线、再到解读结果的全过程 |
一个类比:只按自己脚码进货的鞋店
一家鞋店的店主穿 42 码,进货时下意识按「普通人的脚」进,这个普通人的样子就是他自己。
结果货架上 40 到 44 码堆满,35 码和 47 码几乎没有。店里的「合脚率」看总数很漂亮,因为来的大多是中间码的客人。
小脚和大脚的客人进门试不到合适的鞋,下次就不来了。店主看报表,更加确信「大家都穿中间码」。
这家店没有讨厌谁,问题出在默认样子、进货、报表和解读一路叠起来。
类比在哪里失效:
- 鞋码是一个数字;人脸、肤色、收入这些差异有很多维度,还会交叉组合。
- 鞋店的后果是买不到鞋;AI 用在识别、健康、招聘上,后果可能是被误认、被拒绝。
- 店主能看到空货架;模型的偏见藏在一个整体准确率后面,不拆开看就看不见。
从零讲起
1. 偏见从「默认样子」开始
它解决什么问题
说到 AI 偏见,很多人以为是有人故意让模型歧视。课件先把定义讲清:只要模型对不同的人、情境或群体,系统性地出现不想要的差异,就是算法偏见。
这里关心的是现实影响:识别不出某些人,健康决策给错,语音系统听不懂某些口音,获取服务和机会的门槛不一样。
直觉
人的大脑靠标签省力:一看就归类,速度快。
可每个标签背后有一个原型。说「西瓜」,脑子里是红瓤的;黄瓤的就得叫「黄西瓜」。没人说「红西瓜」,因为红的被当成了理所当然。
课件的说法:原型悄悄顶替了全部合理的例子时,偏见就开始了。
「默认」也因人而异。说到度假,有人想到雪地小木屋,有人想到热闹的城市,有人想到海边的椅子,三个都合理。
标签的三步路:
- 捷径:标签让人反应快
- 标准:原型变成心里的基准线
- 陷阱:标签压过事实,刻板印象出现,选择被扭曲
一步一步看
目标:拿两张新娘照片的识别结果对比,看模型的「新娘原型」怎样让另一位新娘被认成别的东西。
案例:同一个图像分类模型,先后看两张新娘照片。
-
第一张:穿白色婚纱的新娘。
真实标签 模型给出的标签 新娘 新娘、礼服、仪式、女性、婚礼 -
第二张:穿红色礼服的印度新娘。
真实标签 模型给出的标签 新娘 服装、活动、戏服、红色、表演艺术 -
对比两张。
问题 回答 模型的「新娘」原型是什么样 训练数据里最多的白纱婚礼 不符合原型的会怎样 被认成「戏服」「表演」 这算偏见吗 算:对不同文化的新娘表现有系统差异
怎么判断
判断口诀:先问「谁被当成默认」,再问「不像默认的人被怎样对待」。
| 现象 | 有没有原型在起作用 |
|---|---|
| 某类人要被额外加说明,另一类不用 | 有 |
| 模型对少见的样子给出怪标签 | 有 |
| 各种样子的识别结果一样好 | 没明显迹象 |
意思是:偏见常常不显眼,它藏在「这个不用说明」的默认里。
常见误解
误解:没人故意歧视,就不算偏见
课件的定义只看结果:系统性的、不想要的差异。动机不在定义里。
误解:用标签思考本身就是错的
标签带来速度,这是它的好处。问题出在标签压过事实的时候。
试一下
为什么人们会说「黄西瓜」,却很少说「红西瓜」?
答案
红瓤被当成了西瓜的原型,原型不需要标签;只有与原型不同的才被额外加标签。
2. 读人脸分类表:按群体拆开算差距
它解决什么问题
一个人脸性别分类系统宣称准确率很高。可这个数字是所有人混在一起算的。
课件拿三家商用系统的结果,按肤色和性别拆成四组,差距一下就露出来了。
从哪来(补充)
这张表出自 Joy Buolamwini 和 Timnit Gebru 2018 年的 Gender Shades 研究,评估的正是 IBM、Microsoft、Face++ 三家商用性别分类系统。出处:Wikipedia: Joy Buolamwini。
课件同页右侧的误匹配率图,分组和 NIST 2019 年的人脸识别人口统计效应报告一致。那份报告测了 99 家开发者的 189 个算法,一对一比对中,亚裔和非裔的误匹配常是白人的 10 到 100 倍。出处:NIST 新闻稿。
直觉
同一个模型,在四组人身上分别算准确率。最好的一组减最差的一组,就是最大差距。
差距越大,说明这个模型越依赖「谁站在镜头前」。
课件还提醒两件事:
- 检测、识别、性别分类是不同任务,结果要分开评估
- 群体间表现不均是系统层面的问题,不是某个群体的属性
一步一步看
目标:用课件的表,一步步找出每家最差的一组,再算出最大差距。
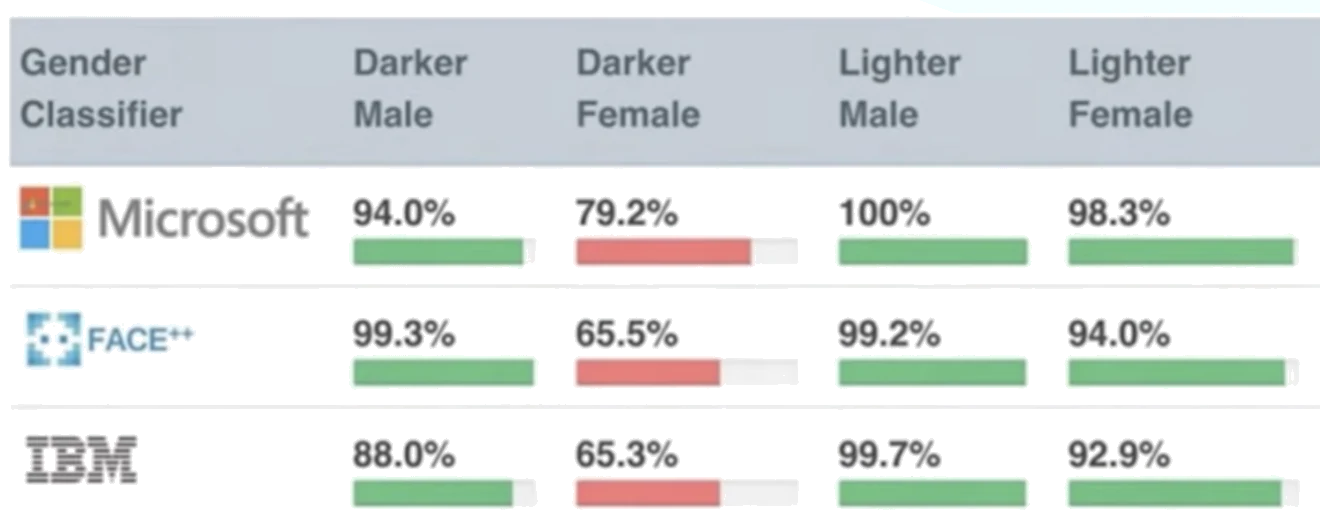
-
每行找最高和最低。
系统 最高 最低 Microsoft 浅肤色男 100% 深肤色女 79.2% Face++ 深肤色男 99.3% 深肤色女 65.5% IBM 浅肤色男 99.7% 深肤色女 65.3% -
相减得最大差距。
系统 算式 最大差距 Microsoft 100 − 79.2 20.8% Face++ 99.3 − 65.5 33.8% IBM 99.7 − 65.3 34.4% -
找规律:三家最差的都是深肤色女性,不管哪家公司做的。
怎么判断
判断口诀:拆组、找最低、算差距、看是不是每家都低在同一组。
| 看到的结果 | 说明什么 |
|---|---|
| 只有一个整体准确率 | 还看不出偏见,要拆组 |
| 某一组在多家系统里都最低 | 系统性差异,很可能来自共同的数据问题 |
| 差距只在某一家出现 | 可能是那家的模型问题 |
意思是:偏见要拆开才看得见,而且同一组在多家都最差,说明问题不在某一家的手艺。
常见误解
误解:深肤色女性的脸「更难认」
课件明说表现不均是系统层面的问题,不是群体的属性。数据和设计没照顾到这一组,才会差。
误解:人脸识别和性别分类的结论可以互相套用
两者是不同任务,课件要求分开评估,一项任务的结论不能直接搬到另一项。
试一下
如果 Microsoft 把深肤色女性的准确率提高到 95%,最大差距会变成多少?
答案
重新看四组:94.0%、95%、100%、98.3%。最低变成深肤色男性 94.0%,差距 = 100 − 94.0 = 6.0%。最大差距要在四组里重新找最高和最低。
3. 按收入和地区看:同一个模型,在穷人家里认得更差
它解决什么问题
偏见不只出现在人脸上。识别家里的日常物品,比如肥皂、炉子、牙刷,也会因为「谁家的东西」而不同。
从哪来(补充)
这张图出自 DeVries、Misra、Wang、van der Maaten 2019 年的论文 Does Object Recognition Work for Everyone?,发现公开的物体识别系统对低收入国家家用物品的识别准确率明显更低。出处:arXiv 1906.02659。
直觉
训练图片大多来自较富裕的地区。同一种物品,在不同收入的家庭里长得很不一样。模型没怎么见过低收入家庭里的「肥皂」和「炉子」,就认不准。
一步一步看
目标:读课件的收入曲线和两张地图,看准确率怎样随收入变化、又为什么。
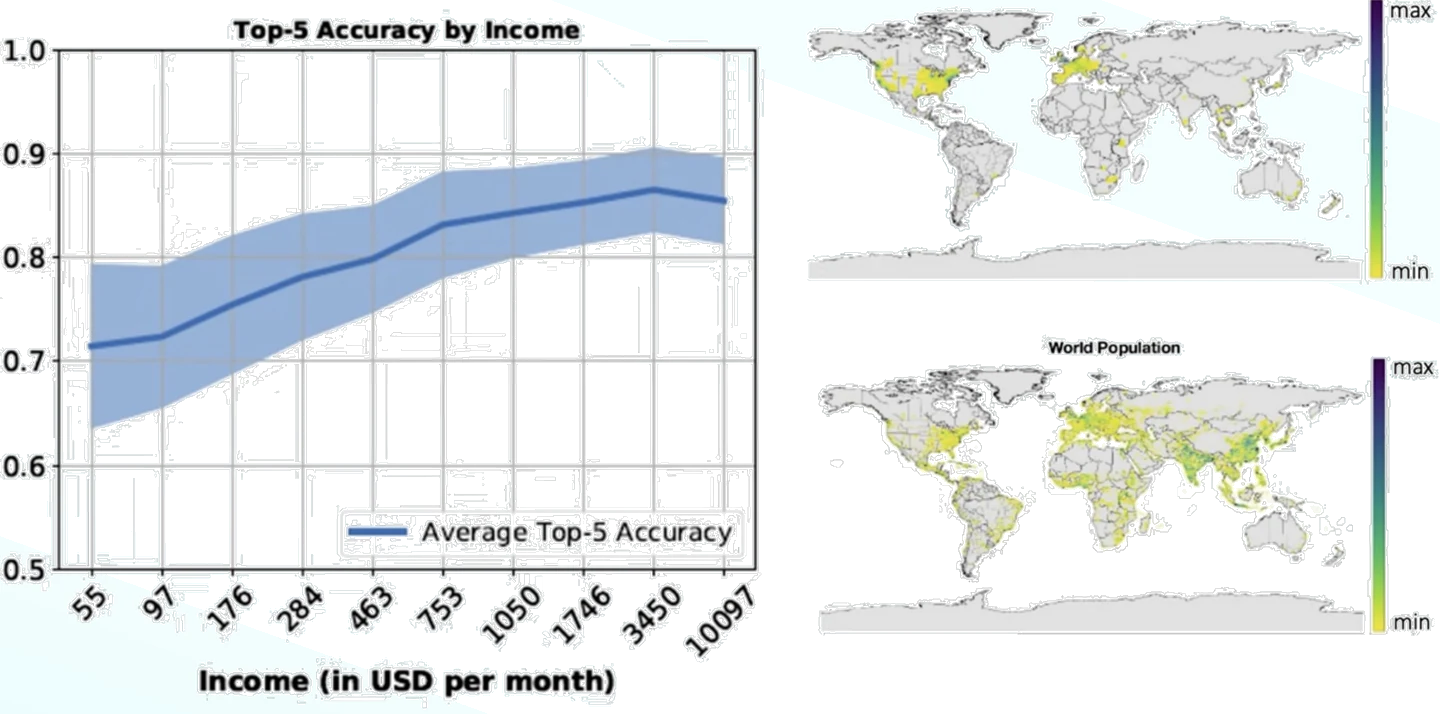
-
读左图的两端。
月收入(美元) 平均前五准确率(读图) 55 约 0.71 3450 约 0.86 10097 约 0.85 -
读右边两张地图。
地图 颜色集中在哪 上图(课件没标题) 北美和欧洲 下图 World Population 亚洲和非洲 -
连起来:数据集里的图片集中在少数富裕地区,人口却在别处,于是模型对多数人的家更陌生。
怎么判断
判断口诀:准确率跟着某个社会变量走,就去查数据从哪来。
| 信号 | 可能的原因 |
|---|---|
| 准确率随收入单调上升 | 训练数据偏向高收入家庭 |
| 某些地区的准确率普遍低 | 这些地区的图片太少 |
意思是:收入和地理本身不进模型,却通过「数据是谁拍的」影响结果。
常见误解
误解:最高收入那组准确率最高
读图看最高点在月收入 3450 美元处,最高收入 10097 美元那组略降。说「大体随收入上升」更准确。
误解:上面那张地图也是人口分布
上图课件没标题,只有下图写着 World Population。从来源论文看,上图是数据集图片的分布;答题要说明这是推断。
试一下
要让这个模型对低收入家庭也好用,最直接的一步是什么?
答案
补充低收入地区、不同样子的物品图片,让训练数据的地理和收入分布更接近实际使用的人群。
4. 偏见从哪一站进来:生命周期五站和六种偏见
它解决什么问题
知道有偏见之后,要找到它从哪来,才能对症处理。课件把 AI 系统的生命周期分成五站,每一站都可能引入偏见。
从哪来(补充)
六种偏见里的自动化偏见有专门研究:人倾向于偏信自动化系统给的建议,即使有相反的信息;常见的错有两类,照着错误建议去做,以及系统没提示就漏掉问题。出处:Wikipedia: Automation bias。
直觉
来源分三类:历史与代表性、测量与代理变量、采样与选择。课件说,找到来源是第一步。
应对也分三类:整理和扩充数据(可以用合成数据)、按子群体做算法审计、让人留在回路中。
常见偏见分两组:
| 组 | 偏见 | 一句人话 |
|---|---|---|
| 数据造成的 | 选择偏差 | 选出来的数据不随机,比如类别不平衡 |
| 数据造成的 | 报道偏差 | 被分享出来的不反映真实频率,比如新闻挑着报 |
| 数据造成的 | 采样偏差 | 某些样子比别的更常被收集,比如头发和肤色分布 |
| 解读造成的 | 相关谬误 | 把相关当成因果 |
| 解读造成的 | 过度泛化 | 拿有限、不多样的测试数据下宽泛结论 |
| 解读造成的 | 自动化偏见 | 不管 AI 对不对,都更信 AI |
一步一步看
目标:拿一个招聘模型的案例,逐步判断它是不是偏见、从哪站进来、属于哪一种。
-
先判断是不是算法偏见。
-
再找它从生命周期哪一站进来。
-
最后归到具体的偏见类型。
怎么判断
判断口诀:问题出在数据,归数据组;出在人怎么读结果,归解读组。
| 场景信号 | 偏见类型 |
|---|---|
| 训练数据某类明显少 | 选择偏差 |
| 数据来自「被报道出来的」事件 | 报道偏差 |
| 某种肤色、发色的样本收得特别多 | 采样偏差 |
| 两件事同涨同落就说一个导致另一个 | 相关谬误 |
| 在一种测试集上好就说「对所有人都好」 | 过度泛化 |
| 医生明知检查结果矛盾仍照 AI 建议走 | 自动化偏见 |
意思是:同一个系统可能同时中好几种,答题时先指出证据在哪一站。
常见误解
误解:数据收好了,后面就不会有偏见
五站每一站都能进偏见,部署后的反馈回路还会放大它。课件的说法是每一站都要主动缓解。
误解:修一次就公平了
课件明说公平要持续监测,不是一次修好;数据和使用的人群都会变。
试一下
整体准确率 95%,就能说明模型对每个群体都好用吗?属于生命周期哪一站的问题?
答案
不能。整体指标会掩盖子群体上的失败,这是评估一站的问题,要按子群体拆开看。
把它们串起来
偏见的起点常常在人自己:原型被当成默认,不像原型的被另加标签,甚至被认成别的东西。
模型把这种默认学了进去。人脸分类表一拆开,三家都是深肤色女性最差;物体识别按收入一排,准确率跟着收入走。
要找原因,就沿生命周期五站一站站查:数据收集、模型设计、训练与运维、评估、解读。
最常用的工具是按子群体拆开看,整体准确率会把这些差异平均掉。
后两页接着讲:数据不平衡和解读错误怎样造成偏见(L08b),以及怎样发现和减轻偏见(L08c)。
课件里的坑
- [读图提醒] p.12 右边两张地图只有下图标了 World Population,上图没有标题;从来源论文看上图是数据集图片的地理分布,课件没写,答题时说明是推断
- [读图提醒] p.12 的曲线在最高收入处略降,「收入越高越准」只在大体趋势上成立
- [出处缺失] p.9 的表和右侧误匹配率图都没有写来源;左表出自 Gender Shades 研究,右图分组与 NIST 2019 年的报告一致(见上方补充)
- [概念提醒] p.10 把性别分类和人脸识别的结论并列,同时提醒不要混为一谈;p.9 左表是性别分类,右图是人脸识别的误匹配率,两边不能直接比较
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先默写算法偏见的定义、生命周期五站和六种偏见;再对照课件 p.3–15 做课件例题和变式题;最后回查一个易错点:最大差距要在四组里找最高和最低,不是固定拿某两组相减。
必背
- 算法偏见:对不同的人、情境或群体,预测或性能出现系统性的、不想要的差异;关注的是现实影响
- 原型悄悄顶替全部合理的例子时,偏见就开始了;与原型不同的才被额外加标签
- 人脸性别分类三家商用系统都是深肤色女性最差,最大差距 20.8%、33.8%、34.4%
- 检测、识别、性别分类是不同任务,要分开评估;群体间表现不均是系统问题,不是群体的属性
- 生命周期五站:数据收集、模型设计、训练与运维、评估、解读;每一站都要主动缓解,公平要持续监测
- 数据造成的偏见:选择、报道、采样;解读造成的偏见:相关谬误、过度泛化、自动化偏见
课件例题
例 1(课件 p.4–5):红西瓜
题面:课件问「How about Red watermelon?」。为什么平时没人说「红西瓜」?这和偏见有什么关系?
提示
想想哪一种西瓜被当成了「普通」的。
解答
红瓤被当成西瓜的原型,原型不用加标签,只有黄瓤的要叫「黄西瓜」。课件的结论:原型悄悄顶替全部合理的例子时,偏见就开始了。
例 2(课件 p.6):你的默认是什么
题面:说到「度假」,三个人分别想到雪地小木屋、热闹的城市、海边的椅子。哪一个是对的?
提示
三种都是度假吗?
解答
都对。每个人的默认不同,没有哪一种是唯一正确的;把自己的默认当成所有人的标准,就是偏见的起点。
例 3(课件 p.7–8):两位新娘
题面:同一个分类模型,对白纱新娘给出「新娘、礼服、仪式、女性、婚礼」,对红色礼服的印度新娘给出「服装、活动、戏服、红色、表演艺术」。说明问题在哪。
提示
模型学到的「新娘」长什么样?
解答
模型的新娘原型来自训练数据里占多数的白纱婚礼,不符合原型的新娘被认成戏服、表演。这是对不同文化群体的系统性差异,属于算法偏见。
例 4(课件 p.9):算最大差距
题面:用上文「一步一步看」里的表(已去掉课件的 Largest Gap 列),算出三家的最大差距,并指出共同规律。
提示
每行在四组里找最高和最低再相减。
解答
Microsoft 100 − 79.2 = 20.8%;Face++ 99.3 − 65.5 = 33.8%;IBM 99.7 − 65.3 = 34.4%。三家最低的都是深肤色女性。
例 5(课件 p.10):别混任务
题面:有人说「这几家性别分类对深肤色女性差,所以它们的人脸识别也一定对深肤色女性差」。按课件评价。
提示
课件对任务的提醒是什么?
解答
推理不成立。检测、识别、性别分类是不同任务,要分开评估。人脸识别要用识别任务的数据另外评估,不能从性别分类的结果直接推。
例 6(课件 p.12):收入与地理
题面:读课件的收入曲线,说出准确率怎样随收入变化,并结合两张地图解释原因。
提示
看曲线两端,再比较两张地图颜色集中的地方。
解答
月收入 55 美元约 0.71,3450 美元约 0.86,最高收入处略降,大体随收入上升。数据集图片集中在北美和欧洲,世界人口集中在亚洲和非洲,模型对多数人的家中物品见得少。上图没有标题,这是按来源论文的推断。
例 7(课件 p.13–15):生命周期与六种偏见
题面:说出生命周期五站,以及数据造成和解读造成的各三种偏见。
提示
五站从收数据走到读结果;六种偏见分两组。
解答
五站:数据收集、模型设计、训练与运维、评估、解读。数据造成:选择偏差、报道偏差、采样偏差。解读造成:相关谬误、过度泛化、自动化偏见。
完整例题
题目:某医院的皮肤病识别模型整体准确率 92%。按肤色拆开后,浅肤色患者 96%,深肤色患者 74%。训练图片里深肤色患者只占一小部分。医生们说:「这个模型很准,以后照它的结果开药就行。」请按本页内容分析。
① 是不是偏见。对不同肤色的患者,性能有系统性的、不想要的差异,属于算法偏见。
② 算差距。最大差距 = 96 − 74 = 22 个百分点;整体 92% 把这个差距平均掉了。
③ 从哪站进来。数据收集:深肤色样本少,是选择或采样偏差。评估:只报整体准确率,掩盖了子群体失败。
④ 解读环节。「照它的结果开药就行」不管模型错没错都信 AI,是自动化偏见。
⑤ 怎么改。补充深肤色病例图片;评估时按肤色分组报告;医生保留最终判断,人留在回路中;上线后持续监测。
变式题(先自己做)
自编情境:一款语音助手在测试时用了 500 段录音,全部来自同一城市的年轻上班族,整体识别率 97%。公司宣布「我们的语音助手对所有用户都好用」。上线后,老人和带口音的用户投诉很多。请指出涉及哪几种偏见、出在生命周期哪几站,以及该怎样评估。
提示
测试数据是什么样的人?「对所有用户都好用」是从什么数据推出来的?
判分点与答案(非官方评分标准)
偏见类型:测试录音只来自一类人,是采样或选择偏差;拿这样的测试结果宣称对所有人都好,是过度泛化。
生命周期:数据收集(样本单一)、评估(只看整体指标)、解读(结论过宽)。
怎样评估:按年龄、口音、地区分组收集测试录音,分组报告识别率,算最大差距;上线后持续监测投诉和各组表现。
判分点:答出过度泛化,至少指出两站,并给出「按子群体分组评估」。
闪卡自测
1. 算法偏见的定义?
对不同的人、情境或群体,预测或性能出现系统性的、不想要的差异(p.3)。
2. 偏见从什么时候开始?
原型悄悄顶替全部合理的例子时(p.4–5)。
3. 标签的三步路?
捷径、标准、陷阱(p.11)。
4. 三家性别分类系统最差的是哪一组?
深肤色女性(p.9)。
5. IBM 的最大差距怎么算?
99.7 − 65.3 = 34.4%(p.9)。
6. 群体间表现不均是谁的问题?
系统层面的问题,不是群体的属性(p.10)。
7. 生命周期五站?
数据收集、模型设计、训练与运维、评估、解读(p.13)。
8. 哪一站会「用整体指标掩盖子群体失败」?
评估(p.13)。
9. 解读造成的三种偏见?
相关谬误、过度泛化、自动化偏见(p.15)。
下一讲
下一页 L08b 接着讲解读和数据造成的偏见:相关不等于因果、分布偏移,以及类别不平衡为什么会让模型「全猜多数类」。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。