T02 Tutorial 2:用 PyTorch 写 MLP 和 CNN 分类手写数字
一份 125 行的 PyTorch 脚本:数据怎么装进 batch,MLP 和 CNN 每一层的形状与参数量,训练循环的四步,以及测试函数里漏掉的 model.eval()。
一句话版
这份脚本用同一套数据和训练流程,先后搭一个全连接网络(MLP)和一个卷积网络(CNN),给 MNIST 手写数字分类。读懂它,就会写 PyTorch 训练代码的标准骨架:准备数据、定义模型、循环训练、测试准确率。
页面里所有张量形状和参数量都是按代码和公式推算的,没有实际运行过,也不写任何训练结果。
先认识这几个词
读之前最好先懂全连接层和反向传播(L04b、L04d),卷积和池化(L06a–L06c)。
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| tensor | 张量 | PyTorch 里的多维数组,相当于能放 GPU、能求梯度的 NumPy 数组 |
| nn.Module | 模块 | 所有模型的父类;在 __init__ 里建层,在 forward 里写数据怎么流 |
| DataLoader | 数据加载器 | 把数据集切成一个个 batch,每轮重新打乱 |
| batch / epoch | 批 / 轮 | 一次喂进去的那几十张图叫一个 batch;整个训练集过一遍叫一个 epoch |
| logits | logit 的复数 | 模型输出的原始分数,没有过 softmax,可正可负 |
| optimizer | 优化器 | 拿着梯度去改参数的对象,如 Adam、SGD |
| BatchNorm | Batch Normalization | 把每个通道的数值拉回均值 0、方差 1 附近,再乘可学习的缩放、加平移 |
| device | 设备 | 张量和模型放在 CPU 还是 GPU 上 |
题目地图
课件分两个案例,用的是同一份脚本 Tutorial2-MnistClassifier.py,两种模型只差一行。
| 段 | 讲什么 | 代码在哪 | 主要失分点 |
|---|---|---|---|
| 准备环境 | conda 建环境、装 PyTorch | 命令行 | 无,照抄命令 |
| Step 0 数据 | Dataset、DataLoader、ToTensor |
create_dataloader() |
说不清一个 batch 的形状 |
| Case 1 MLP | 一层隐藏层的全连接网络 | NeuralNet |
忘了先拉平;在输出层加 softmax |
| 训练与测试 | 四步训练循环、算准确率 | train()、test() |
四步顺序写错;漏 zero_grad |
| Case 2 CNN | 两层卷积 + BatchNorm + 池化 | ConvNet |
算错拉平后的长度 |
| GPU | device 与 .to() |
课件有,代码里没有 | 模型和数据不在同一设备 |
主程序默认跑 CNN。把 model = ConvNet() 换成被注释掉的 NeuralNet(),就是 MLP 版本。
概念卡
1. 张量形状:每一维代表什么
人话定义:读 PyTorch 代码最先要盯的是形状。图片 batch 的约定写法是 (B, C, H, W):一批几张、几个通道、多高、多宽。
例子:DataLoader 每次给出的 images 形状是 (64, 1, 28, 28),64 张灰度图,每张 28 × 28;labels 形状是 (64,),每张图一个 0 到 9 的类别编号。训练集 60,000 张,按 64 一批切成 938 批,最后一批只剩 32 张。
常见误解
以为 batch 大小永远是 64 → 最后一批常常不满。代码里凡是要用 batch 大小的地方,都应该写 out.size(0) 或 -1,不能把 64 写死。
回讲义:L05a Mini-batch 与动量:让梯度下降算得省、走得顺
2. 训练循环的四步
人话定义:每拿到一个 batch,就做四件事:前向算输出、算 loss、求梯度、更新参数。PyTorch 里分别对应 model(images)、criterion(...)、loss.backward()、optimizer.step()。
例子:backward() 之前要先 optimizer.zero_grad()。PyTorch 的梯度默认累加,不清零的话,这一步的梯度会叠在上一步的上面。backward() 本身就是反向传播:沿计算图用链式法则,把每个参数的梯度算出来。
常见误解
以为 loss.backward() 已经改了参数 → 它只把梯度存进每个参数的 .grad,真正改参数的是 optimizer.step()。
3. 输出层不加 softmax
人话定义:分类模型的最后一层直接输出 10 个原始分数(logits)。nn.CrossEntropyLoss 自己会先做 log-softmax,再取正确类别那一项的负值。
例子:NeuralNet 的 forward 最后一句是 out = self.fc2(x),后面什么都不接。测试时要知道预测哪一类,用 torch.max(outputs, 1) 取分数最大的下标即可,softmax 不改变谁最大。
常见误解
在模型末尾再加一层 softmax → 等于做了两次 softmax,代码能跑,但梯度变小、训练变慢。课件的网络图在输出层画了 σ,以代码为准。
回讲义:L03a-4 决策边界与 softmax:逻辑回归画的是一条直线
4. 卷积层的输出尺寸
人话定义:卷积核在图上滑,输出边长由输入边长、核大小、补边圈数和步长决定。补边就是在图四周补零,让核能滑到边缘。
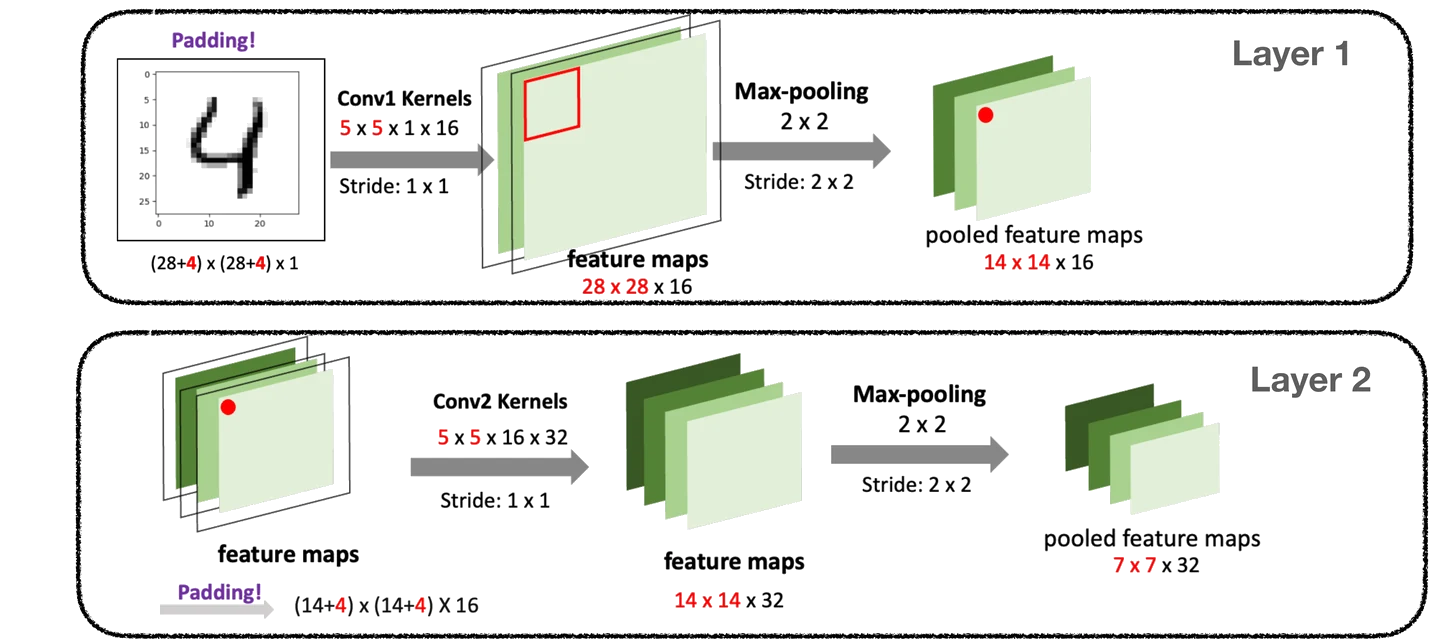
例子:nn.Conv2d(1, 16, kernel_size=5, stride=1, padding=2),输入边长 28,输出边长 (28 + 4 − 5) / 1 + 1 = 28。补 2 圈正好抵消 5 × 5 核吃掉的 4 格,所以尺寸不变。之后 MaxPool2d(2, 2) 把边长减半成 14。
常见误解
把「padding = kernel_size // 2」当成通用规则 → 它只在核是奇数、步长是 1 时让尺寸不变。核为 4 时 4 // 2 = 2,输出会比输入多 1。
回讲义:L06b 通道、参数量与补边:卷积层怎么一层层叠起来
5. 训练模式和评估模式
人话定义:有些层在训练和测试时行为不同。BatchNorm 训练时用当前 batch 的均值方差,评估时用训练中攒下的滑动平均。用 model.train() 和 model.eval() 切换。
例子:这份脚本的 ConvNet 每层都有 BatchNorm2d,但 test() 只写了 torch.no_grad()。no_grad 只是不记录梯度,模型仍在训练模式,测试时会用测试 batch 自己的统计量,还会改写滑动平均。
常见误解
以为 no_grad 和 eval 是一回事 → 前者管「要不要算梯度」,后者管「层按哪种模式工作」。测试时两个都要写。
回讲义:L05c 正则化:L2、L1、早停和 dropout 怎么防过拟合
逐题拆解
Step 0:把 MNIST 装进 DataLoader
torchvision.datasets.MNIST 第一次运行时会下载到 root='data'。transforms.ToTensor() 把每张图变成 (1, 28, 28) 的浮点张量,像素值缩到 0 到 1 之间。
train_dataset = torchvision.datasets.MNIST(root='data', train=True,
                                           download=True, transform=transforms.ToTensor())
test_dataset = torchvision.datasets.MNIST(root='data', train=False,
                                          download=True, transform=transforms.ToTensor())
train_loader = torch.utils.data.DataLoader(dataset=train_dataset, batch_size=64, shuffle=True)
test_loader = torch.utils.data.DataLoader(dataset=test_dataset, batch_size=64, shuffle=False)
训练集打乱,测试集不打乱。测试只算准确率,顺序无所谓,不打乱便于复现。
Case 1:一层隐藏层的 MLP
class NeuralNet(nn.Module):
    def __init__(self):
        super(NeuralNet, self).__init__()
        self.fc1 = nn.Linear(784, 500)
        self.relu = nn.ReLU()
        self.fc2 = nn.Linear(500, 10)
        self.type = 'MLP'

    def forward(self, x):
        x = self.fc1(x)
        x = self.relu(x)
        out = self.fc2(x)
        return out
nn.Linear 只吃最后一维,所以图片进模型前要拉平。代码把这一步放在 train() 和 test() 里:if model.type == 'MLP': images = images.reshape(-1, 28 * 28)。self.type 就是给这个判断用的标签。
一步一步看
目标:跟着一个 batch 走完 MLP,看清每一层之后形状变成什么、参数主要堆在哪一层。
每帧多露出一层,青绿色是这一步新算出的形状。
-
拉平:
(64, 1, 28, 28)变成(64, 784),数字总数不变,空间位置信息丢了。
-
fc1加 ReLU:每张图变成 500 个数。这一层有 784 × 500 + 500 = 392,500 个参数。
-
fc2:输出(64, 10),每张图 10 个 logits,不加激活。
train() 与 test():四步循环和准确率
for epoch in range(num_epochs):
    for step, (images, labels) in enumerate(train_loader):
        if model.type == 'MLP':
            images = images.reshape(-1, 28 * 28)
        outputs = model(images)              # (1) 前向
        loss = criterion(outputs, labels)    # (2) 算 loss
        optimizer.zero_grad()                # 清掉上一步的梯度
        loss.backward()                      # (3) 求梯度
        optimizer.step()                     # (4) 更新参数
每 100 步打印一次 loss。一个 epoch 有 938 步,所以每轮打印 9 次;主程序跑 5 轮,一共 45 行输出、4690 次参数更新。
test() 在 torch.no_grad() 里跑完测试集,torch.max(outputs.data, 1) 返回每行的最大值和下标,下标就是预测类别。预测对的个数除以 10,000 就是准确率。
Case 2:两层卷积的 CNN
class ConvNet(nn.Module):
    def __init__(self, num_classes=10):
        super(ConvNet, self).__init__()
        self.layer1 = nn.Sequential(
            nn.Conv2d(1, 16, kernel_size=5, stride=1, padding=2),
            nn.BatchNorm2d(16),
            nn.ReLU(),
            nn.MaxPool2d(kernel_size=2, stride=2))
        self.layer2 = nn.Sequential(
            nn.Conv2d(16, 32, kernel_size=5, stride=1, padding=2),
            nn.BatchNorm2d(32),
            nn.ReLU(),
            nn.MaxPool2d(kernel_size=2, stride=2))
        self.fc = nn.Linear(7 * 7 * 32, num_classes)
        self.type = 'CNN'

    def forward(self, x):
        out = self.layer1(x)
        out = self.layer2(out)
        out = out.reshape(out.size(0), -1)
        out = self.fc(out)
        return out
每个 layer 是同样的四件套:卷积、BatchNorm、ReLU、池化。nn.Sequential 把它们串成一个整体,forward 里调用一次就依次走完。课件用下面这张图画出两层的尺寸。
一步一步看
目标:跟着一个 batch 走完 CNN,看清边长怎样从 28 变成 7,以及拉平后为什么是 1568。
每帧多露出一层,青绿色是这一步新算出的形状。
-
conv1:16 个 5 × 5 的核,补 2 圈,输出(64, 16, 28, 28)。BN 和 ReLU 不改形状。
-
池化:边长减半,
(64, 16, 14, 14)。
-
layer2:32 个 5 × 5 × 16 的核,边长保持 14,池化后(64, 32, 7, 7)。
-
拉平:
out.reshape(out.size(0), -1)得(64, 1568),7 × 7 × 32 = 1568。
-
fc:Linear(1568, 10)输出(64, 10)。
两种模型的参数量
按公式数出来(未实跑):Linear(a, b) 有 a·b + b 个参数;Conv2d 有 输入通道 × 输出通道 × 核面积 + 输出通道 个;BatchNorm2d(C) 有 2C 个可学习参数。
MLP 的参数几乎全在 fc1,约占 98.7%。CNN 只有 MLP 的约 7.3%,因为卷积核在整张图上共用。CNN 里最大的一块反倒是最后的全连接层。BN 另有 96 个滑动平均数(均值和方差),它们是缓冲区,不参与训练。
补全后的完整脚本
课件给的脚本本身完整,但有两处要补:测试前切 model.eval(),以及按课件后半讲的方法把模型和数据搬到 GPU。下面是补好的版本,改动处标了 # [改]。本页没有运行过它。
import torch
import torch.nn as nn
import torchvision
import torchvision.transforms as transforms

device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')   # [改]


class NeuralNet(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc1 = nn.Linear(784, 500)
        self.relu = nn.ReLU()
        self.fc2 = nn.Linear(500, 10)
        self.type = 'MLP'

    def forward(self, x):
        return self.fc2(self.relu(self.fc1(x)))


class ConvNet(nn.Module):
    def __init__(self, num_classes=10):
        super().__init__()
        self.layer1 = nn.Sequential(
            nn.Conv2d(1, 16, kernel_size=5, stride=1, padding=2),
            nn.BatchNorm2d(16), nn.ReLU(),
            nn.MaxPool2d(kernel_size=2, stride=2))
        self.layer2 = nn.Sequential(
            nn.Conv2d(16, 32, kernel_size=5, stride=1, padding=2),
            nn.BatchNorm2d(32), nn.ReLU(),
            nn.MaxPool2d(kernel_size=2, stride=2))
        self.fc = nn.Linear(7 * 7 * 32, num_classes)
        self.type = 'CNN'

    def forward(self, x):
        out = self.layer2(self.layer1(x))
        out = out.reshape(out.size(0), -1)
        return self.fc(out)


def create_dataloader():
    tf = transforms.ToTensor()
    train_dataset = torchvision.datasets.MNIST(root='data', train=True, download=True, transform=tf)
    test_dataset = torchvision.datasets.MNIST(root='data', train=False, download=True, transform=tf)
    train_loader = torch.utils.data.DataLoader(train_dataset, batch_size=64, shuffle=True)
    test_loader = torch.utils.data.DataLoader(test_dataset, batch_size=64, shuffle=False)
    return train_loader, test_loader


def train(train_loader, model, criterion, optimizer, num_epochs):
    model.train()                                                        # [改]
    total_step = len(train_loader)
    for epoch in range(num_epochs):
        for step, (images, labels) in enumerate(train_loader):
            images, labels = images.to(device), labels.to(device)        # [改]
            if model.type == 'MLP':
                images = images.reshape(-1, 28 * 28)
            outputs = model(images)
            loss = criterion(outputs, labels)
            optimizer.zero_grad()
            loss.backward()
            optimizer.step()
            if (step + 1) % 100 == 0:
                print('Epoch [{}/{}], Step [{}/{}], Loss: {:.4f}'
                      .format(epoch + 1, num_epochs, step + 1, total_step, loss.item()))


def test(test_loader, model):
    model.eval()                                                         # [改]
    correct, total = 0, 0
    with torch.no_grad():
        for images, labels in test_loader:
            images, labels = images.to(device), labels.to(device)        # [改]
            if model.type == 'MLP':
                images = images.reshape(-1, 28 * 28)
            outputs = model(images)
            _, predicted = torch.max(outputs, 1)                         # [改] 去掉 .data
            total += labels.size(0)
            correct += (predicted == labels).sum().item()
    print('Accuracy of the network on the 10000 test images: {} %'.format(100 * correct / total))


if __name__ == '__main__':
    train_loader, test_loader = create_dataloader()
    model = ConvNet().to(device)                                         # [改] 换 NeuralNet() 即 MLP
    criterion = nn.CrossEntropyLoss()
    optimizer = torch.optim.Adam(model.parameters(), lr=0.001)
    train(train_loader, model, criterion, optimizer, num_epochs=5)
    test(test_loader, model)
model.to(device) 必须在建 optimizer 之前做,这样优化器拿到的就是已经搬上设备的参数。
课件里的坑
- [课件有误]
test()没有调用model.eval()。ConvNet含 BatchNorm2d,测试时仍处于训练模式:每个测试 batch 用自己的均值方差归一化,还会改写训练攒下的滑动平均。torch.no_grad()只关梯度,不切模式。对应地,训练开始前要model.train()。PyTorch 文档对 BatchNorm 的说明:训练时用 batch 统计量,评估模式才用滑动平均(BatchNorm2d 文档)。 - [前后不一致] p.11 的网络图在输出层画了 σ,p.12 又说输出层不做激活。以代码为准,输出是 logits。
- [前后不一致] p.27–29 讲了 GPU 的三步用法,但脚本里一行
.to(device)也没有,照跑只会用 CPU。补法见上面的完整脚本。 - [小错] p.24 的
nn.MaxPool2d(kernel_size=2, stride=2))多一个右括号(从Sequential里截出来的);p.14 把 target 拼成 “trarget”;p.5 的 Reference 链接复制了 p.4 的 conda 环境页;p.25 输出节点标成 x 而不是 y。 - [课件留白] p.22 写 “Padding = kernel_size // 2”,没有说只在奇数核、步长 1 时才保持尺寸。
- [课件留白] p.23 只说 BatchNorm 归一化成均值 0、方差 1,没提后面还有可学习的缩放 γ 和平移 β,每个通道各一个。所以
BatchNorm2d(16)有 32 个可训练参数。 - [补充]
outputs.data是旧写法,在no_grad里直接用outputs即可。
课后 10 分钟:考点复习
这 10 分钟怎么用:先遮住必背清单默写七条;再做完整例题,重点是每一层的形状和参数量;最后做两道变式题,先写公式再代数字。
必背
- 训练循环每一步四件事:前向算输出、算 loss、zero_grad 后 backward 求梯度、optimizer.step() 更新参数
- 模型最后一层不加 softmax,输出 logits 直接交给 CrossEntropyLoss,它内部等于 LogSoftmax + NLLLoss
- MLP 先把 (B, 1, 28, 28) 拉平成 (B, 784);CNN 保留二维,直到全连接层前才拉平成 (B, 1568)
- 卷积输出边长 = (输入 + 2·padding − kernel) / stride + 1;5×5 核、padding 2、stride 1 时尺寸不变
- MaxPool2d(2, 2) 让高和宽各减半,通道数不变:28 → 14 → 7
- 参数量:MLP 397,510,CNN 29,034;Linear(a, b) 有 a·b + b 个,Conv2d 有 输入通道·输出通道·k² + 输出通道 个
- 含 BatchNorm 或 Dropout 的模型,测试前要 model.eval();torch.no_grad() 只关梯度,不切模式
完整例题
把 ConvNet 的 layer1 改成 nn.Conv2d(1, 8, kernel_size=3, stride=1, padding=1)、BatchNorm2d(8)、ReLU、MaxPool2d(2, 2),layer2 改成 nn.Conv2d(8, 16, kernel_size=3, stride=1, padding=1)、BatchNorm2d(16)、ReLU、MaxPool2d(2, 2)。batch 为 64。求:(a)每一层后的形状;(b)self.fc 该写成什么;(c)全部可训练参数量。
第一步,layer1 的形状。 卷积输出边长 (28 + 2 − 3) / 1 + 1 = 28,形状 (64, 8, 28, 28);池化后 (64, 8, 14, 14)。
第二步,layer2 的形状。 (14 + 2 − 3) / 1 + 1 = 14,形状 (64, 16, 14, 14);池化后 (64, 16, 7, 7)。
第三步,拉平与 fc。 7 × 7 × 16 = 784,所以 self.fc = nn.Linear(7 * 7 * 16, 10),输出 (64, 10)。
第四步,数参数。 conv1:1 × 8 × 9 + 8 = 80。bn1:2 × 8 = 16。conv2:8 × 16 × 9 + 16 = 1168。bn2:2 × 16 = 32。fc:784 × 10 + 10 = 7850。合计 80 + 16 + 1168 + 32 + 7850 = 9146。
3 × 3 的核配 padding 1,和 5 × 5 配 padding 2 一样能保持尺寸。参数最多的仍是全连接层。
变式题(先自己做)
变式 1 把原脚本 layer1 的卷积改成 nn.Conv2d(1, 16, kernel_size=5, stride=1, padding=0),其余不变。(a)layer1 输出形状?(b)layer2 输出形状?(c)self.fc 原来的 7 * 7 * 32 还对吗?不改会怎样?
提示
每层都用同一个公式:(输入 + 2·padding − kernel) / stride + 1。池化时 kernel 和 stride 都是 2、padding 是 0,除不尽向下取整。
参考答案与自检(非官方评分标准)
(a)卷积 (28 − 5) / 1 + 1 = 24,形状 (64, 16, 24, 24);池化 (24 − 2) / 2 + 1 = 12,得 (64, 16, 12, 12)。
(b)layer2 仍补 2 圈,卷积后边长 12,池化后 6,得 (64, 32, 6, 6)。
(c)不对。拉平后长度是 6 × 6 × 32 = 1152,要改成 nn.Linear(6 * 6 * 32, 10)。不改的话第一次前向就报矩阵形状不匹配的错。
自检:每一层都先写公式再代数字,算对。只改了第一层没往后推的,回到概念卡 4。
变式 2 下面的测试函数用在原脚本的 ConvNet 上,指出问题并说明后果:
def test(test_loader, model):
    for images, labels in test_loader:
        outputs = model(images)
        _, predicted = torch.max(outputs, 1)
提示
分两件事想:要不要记录梯度;BatchNorm 处在哪种模式。
参考答案与自检(非官方评分标准)
两处都缺。没有 torch.no_grad():每次前向都在建计算图,白白占内存,但结果数值不受影响。没有 model.eval():BatchNorm 用测试 batch 自己的均值方差归一化,预测会受同一 batch 里其他图片影响,而且会改写训练攒下的滑动平均。正确写法是先 model.eval(),再在 with torch.no_grad(): 里循环。
自检:说出「no_grad 管梯度、eval 管模式」两层意思才算对。
闪卡自测
DataLoader 给出的 images 和 labels 各是什么形状?
batch 为 64 时,images 是 (64, 1, 28, 28),labels 是 (64,)。训练集最后一批只有 32 张。
为什么 backward 之前要 zero_grad?
PyTorch 的梯度默认累加。不清零,这一步的梯度会叠在上一步上面。
loss.backward() 会改参数吗?
不会。它只算梯度存进 .grad,改参数的是 optimizer.step()。
CrossEntropyLoss 的输入要先过 softmax 吗?
不要。它内部就是 LogSoftmax 加 NLLLoss,输入是 logits,目标是类别编号。
MLP 版本为什么要 reshape(-1, 28 * 28)?
nn.Linear 只作用在最后一维,要先把每张图拉成 784 个数。-1 让 PyTorch 自己算出 batch 大小。
CNN 拉平后为什么是 1568?
两次池化把边长从 28 减到 7,通道数是 32,7 × 7 × 32 = 1568。
Conv2d(16, 32, kernel_size=5) 有多少参数?
16 × 32 × 25 + 32 = 12,832。每个核是 5 × 5 × 16,共 32 个,每个核一个偏置。
torch.max(outputs, 1) 返回什么?
两个东西:每行的最大值和它的下标。分类只要下标,所以写 _, predicted = ...。
torch.no_grad() 和 model.eval() 有什么区别?
前者不记录梯度,省内存;后者把 BatchNorm、Dropout 切到评估行为。测试时两个都要。
模型放 GPU 上要做哪两件事?
model.to(device),以及每个 batch 的 images、labels 也 .to(device)。两边不在同一设备会直接报错。
下一步
- 不看代码,把
train()的四步和zero_grad的位置默写一遍。 - 遮住上面的形状链,自己算一遍 CNN 每层形状和 1568,再算 29,034 个参数。
- 有 GPU 环境的话,跑一遍补全后的脚本,再把
model.eval()删掉跑一次,对比测试准确率。 - 接下来的 Tutorial 3 沿用同一套数据和训练循环,只把模型换成 Transformer,见 T03a。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。