L04d 反向传播:把误差从输出一层层送回每个权重
从损失出发往回走,一帧一帧算出示例网络 10 个权重的梯度;再到不全连接的网络里找路径;最后把反向传播放回梯度下降,看一次训练迭代完整长什么样。
一句话版
反向传播(BP)就是按一个聪明的顺序用链式法则:从损失出发往回走,每到一个加权和就算出「损失对它的导数」(累积误差),再往前传时乘一个权重、乘一个 σ′。任一权重的梯度,等于它下游那个累积误差乘它上游的激活。
上一页 L04c 准备好了链式法则和全部局部导数。这一页把它们拼起来。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 反向传播 | backpropagation,缩写 BP | 从输出往回逐层求梯度的计算顺序 |
| 原始误差 | 2(y − ȳ) | 损失对输出 y 的导数,所有梯度都从它开始 |
| 累积误差 | 本页记作 δ,读「德尔塔」 | 损失对某个加权和 s 的导数 |
| 上游 / 下游 | upstream / downstream | 靠近输入的一侧叫上游,靠近损失的一侧叫下游 |
| 路径 | path | 从一个权重顺着箭头走到损失的一条路线 |
| 全连接 | fully connected | 相邻两层每一对神经元之间都有连线 |
| 迭代 | iteration | 前向、反向、更新各做一次,算一轮 |
一个类比:流水线上追查旋钮
一条三道工序的流水线,最后出来的成品尺寸偏了。每台机器上都有旋钮,你想知道每个旋钮该往哪拧、拧多少。
做法是从成品往回查。先量出成品偏了多少。最后一道工序把偏差放大了几倍,倒数第二道又放大了几倍,一路乘回去,就知道最前面那个旋钮对成品的影响。
如果某台机器的半成品同时送到两条下游线,两条线的影响要加在一起。
聪明的地方在于:查到倒数第二道时算出的那个「偏差 × 放大倍数」,查更前面的旋钮时直接接着用,不用从成品重新算起。
类比在哪里失效:
- 工厂每道工序的放大倍数大致固定。网络里每一步的放大倍数(σ′)随输入变化,换一个样本就要重算。
- 工厂里通常一次只拧一个旋钮。网络是先用同一份旧参数算出全部方向,再一起拧。
从零讲起
1. 从损失往回,逐个权重求梯度
它解决什么问题
示例网络有 10 个权重,每个都要一个梯度。如果每个权重都从损失开始,沿链式法则独立推一遍,前面几段乘积会被重复算很多次。BP 规定一个顺序:从后往前,每个中间结果只算一次,往前传时接着用。
直觉
站在损失那头往回看。损失对 y 的导数是 2(y − ȳ),这是起点。
往回走一层,到 s₃:损失对 s₃ 的导数 = 2(y − ȳ) × w₉ × σ′(s₃)。这个数叫 s₃ 处的累积误差,记作 δ₃。它已经把「从 s₃ 到损失」这一整段都包进去了。
所以 w₅ 的梯度不用从头算:w₅ 只影响 s₃,dℓ/dw₅ = δ₃ × h₁。下游的累积误差,乘上游的激活,就是梯度。
再往回走到 s₁ 时,h₁ 同时连到 s₃ 和 s₄,两条路要加起来。
一步一步看
目标:从原始误差出发一层层往回算,看每个权重的梯度怎样由累积误差乘上它的输入得到。
沿用上一页的数值:x = (1, 0.5),ȳ = 1,前向得 y = −0.1756、ℓ = 1.382。每一帧青绿色标的是这一步新算出来的量。
-
起点:原始误差 2(y − ȳ) = 2 × (−0.1756 − 1) = −2.3512。
-
输出层的两个权重只有一条路,原始误差乘各自的输入。dℓ/dw₉ = −2.3512 × 0.4735 = −1.1133。dℓ/dw₁₀ = −2.3512 × 0.6491 = −1.5262。
-
往回一层,算 s₃、s₄ 处的累积误差。δ₃ = −2.3512 × 1.0 × 0.2493 = −0.5862。δ₄ = −2.3512 × (−1.0) × 0.2278 = 0.5355。
-
第二层四个权重,各用 δ₃ 或 δ₄ 乘 h₁ 或 h₂。dℓ/dw₅ = −0.5862 × 0.5622 = −0.3295。dℓ/dw₆ = −0.5862 × 0.6682 = −0.3917。dℓ/dw₇ = 0.5355 × 0.5622 = 0.3011。dℓ/dw₈ = 0.5355 × 0.6682 = 0.3578。
-
再往回到 s₁:h₁ 经 w₅ 连 s₃、经 w₇ 连 s₄,两条路相加再乘 σ′(s₁)。δ₁ = (−0.5862 × 1.0 + 0.5355 × 0.5) × 0.2461 = −0.0784。dℓ/dw₁ = δ₁ × x₁ = −0.0784。
-
s₂ 同理:δ₂ = (−0.5862 × (−1.0) + 0.5355 × 0.5) × 0.2217 = 0.1893。第一层剩下三个:dℓ/dw₂ = δ₁ × x₂ = −0.0392。dℓ/dw₃ = δ₂ × x₁ = 0.1893。dℓ/dw₄ = δ₂ × x₂ = 0.0947。
怎么算
三条公式就够了:
- 原始误差:dℓ/dy = 2(y − ȳ)
- 累积误差往回传:δ_上游 = (Σ δ_下游 × 连线权重) × σ′(s_上游)
- 权重的梯度:dℓ/dw = δ_下游 × 上游激活
意思是:先从损失拿到起点。每往回一层,把下游各个累积误差乘上连线权重加起来,再乘本节点的 σ′。要哪个权重的梯度,就拿它指向的那个节点的累积误差,乘它出发的那个节点的值。
把 w₁ 写成完整的链式法则,可以看到两条路径:
dℓ/dw₁ = 2(y−ȳ) · w₉ · σ′(s₃) · w₅ · σ′(s₁) · x₁
       + 2(y−ȳ) · w₁₀ · σ′(s₄) · w₇ · σ′(s₁) · x₁
意思是:前一项是经 h₃ 的路,后一项是经 h₄ 的路。两项的开头 2(y−ȳ)·w₉·σ′(s₃) 和 2(y−ȳ)·w₁₀·σ′(s₄) 就是 δ₃ 和 δ₄,第二层时已经算好,这里直接用。
全部 10 个梯度里,2(y − ȳ) 都出现了。w₉ 是 3 个因子相乘,w₅ 是 5 个,w₁ 是两条各 7 个因子的路径相加。越靠前链越长,但前半段都复用。
这 10 个值和对每个权重做数值差分(把权重挪一点点看损失变多少)的结果逐个一致。
常见误解
以为第一层权重只有一条路径
h₁ 同时连向 s₃ 和 s₄,dℓ/dw₁ 必须是两条路径之和。漏一条就错一半。第二层的权重(如 w₅)只连一个下游,才是一条路。
以为每个导数都和网络里所有节点有关
dℓ/dw₉ 只牵涉 y、ȳ、h₃,和 h₄、w₁₀ 无关。一个权重的梯度只取决于它下游路径上的节点和它自己的输入。
算累积误差时忘了乘 σ′
每穿过一个 sigmoid 节点都要乘一次它的 σ′。示例网络的输出层没有激活,所以第一步不乘;隐藏层每个节点都要乘。
试一下
用上面的数值,验算 dℓ/dw₆ 和 dℓ/dw₄。
dℓ/dw₆ = δ₃ × h₂ = −0.5862 × 0.6682 ≈ −0.3917。dℓ/dw₄ = δ₂ × x₂ = 0.1893 × 0.5 ≈ 0.0947。
2. 不全连接的网络:只沿真实连线找路径
它解决什么问题
示例网络是全连接的,每个节点都连到下一层所有节点。真实网络和考试题经常不是这样:有的线没有,有的线跨了层,还可能有好几个输出。这时要先把路径找清楚,再套上面的规则。
直觉
一个权重的梯度,就是它能影响到损失的所有路线之和。路线只能顺着图里真实存在的箭头走。
所以先从这个权重指向的节点出发,顺着箭头往后走到每一个输出,把能走通的路列出来。走不到的输出,这个权重对它的损失就没有影响,梯度是 0。
一步一步看
目标:在不全连接的练习网络里给 w₂₄ 和 w₁₃ 找路径,看梯度只沿真实连线累加,到不了的输出贡献为 0。
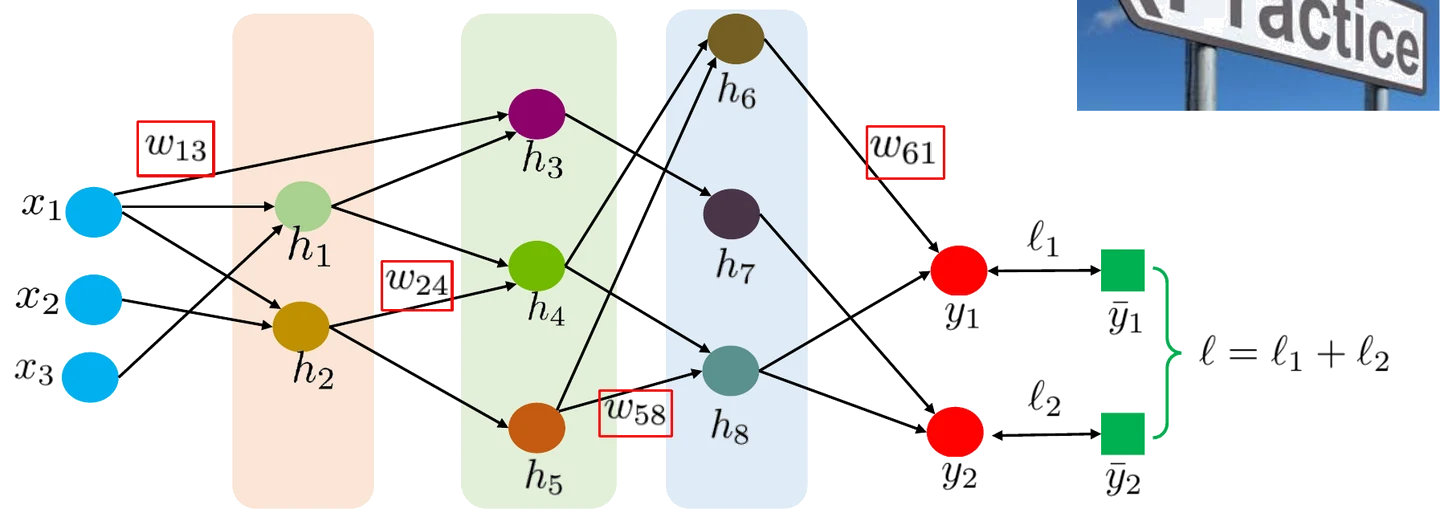
课件的练习网络:3 个输入、三个隐藏层、2 个输出,不是全连接,还有一条跨层线 x₁→h₃。总损失 ℓ = ℓ₁ + ℓ₂。
-
先找 w₂₄ 这条线:它从 h₂ 指向 h₄。w₂₄ 一变,先动的是 h₄。
-
从 h₄ 顺箭头往后走:h₄ 连 h₆ 和 h₈;h₆ 只连 y₁,h₈ 连 y₁ 和 y₂。一共三条路:h₄→h₆→y₁、h₄→h₈→y₁、h₄→h₈→y₂。
-
换 w₁₃(x₁→h₃):h₃ 只连 h₇,h₇ 只连 y₂。只有一条路,到不了 y₁。
-
结论:dℓ/dw₂₄ 是三条路之和;dℓ/dw₁₃ 只有一条路;dℓ₁/dw₁₃ = 0。
怎么算
w₂₄ 的三条路各自相乘,再相加:
dℓ/dw₂₄ = [ dℓ₁/dy₁ · dy₁/dh₆ · dh₆/dh₄
          + dℓ₁/dy₁ · dy₁/dh₈ · dh₈/dh₄
          + dℓ₂/dy₂ · dy₂/dh₈ · dh₈/dh₄ ] · dh₄/dw₂₄
w₁₃ 只有一条:
dℓ/dw₁₃ = dℓ₂/dy₂ · dy₂/dh₇ · dh₇/dh₃ · dh₃/dw₁₃
意思是:方括号里每一项是一条路,从损失一路乘回到 h₄;最后统一乘 dh₄/dw₂₄,也就是 h₄ 的 σ′ 乘输入 h₂。w₁₃ 只经过 y₂,所以只和 ℓ₂ 有关。
这里每个「dA/dB」表示 B 经一条真实连线影响 A,节点若带激活,激活导数已含在这一步里。
常见误解
按全连接的习惯,把所有输出都算进去
w₁₃ 走不到 y₁,ℓ₁ 对它的导数就是 0。照全连接的样子硬写一条到 y₁ 的路,是凭空多出一项。
两个输出时只算一个损失
总损失 ℓ = ℓ₁ + ℓ₂。一个权重能同时走到 y₁ 和 y₂ 时,两边的路都要算进 dℓ/dw。题目只问 dℓ₁/dw 时,才只看通往 y₁ 的路。
试一下
在练习网络里,h₅→h₈ 这条线(w₅₈)对总损失有几条路径?
两条:h₈→y₁ 和 h₈→y₂。dℓ/dw₅₈ = (dℓ₁/dy₁ · dy₁/dh₈ + dℓ₂/dy₂ · dy₂/dh₈) · dh₈/dw₅₈。
3. 把 BP 放回梯度下降
它解决什么问题
有了全部梯度,还要知道 BP 在训练里站在哪个位置、做到哪里为止。这关系到一个常考的概念题:BP 到底是不是一种训练算法。
从哪来(补充)
1970 年,Seppo Linnainmaa 在赫尔辛基大学的硕士论文里发表了自动微分的反向模式,这是反向传播的数学形式。1986 年,Rumelhart、Hinton 和 Williams 在 Nature 上发表论文 “Learning representations by back-propagating errors”。这篇论文让这套方法在神经网络里普及开来。课件历史表里 1986 年那一行说的就是这件事。
直觉
梯度下降四步里,第 3 步「求每个参数的导数」就是 BP。BP 交出梯度就结束了,拿梯度去改权重是第 4 步的事。
一次训练迭代像一来一回:前向从输入走到损失,把路上的值都存下;反向从损失走回输入,用存下的值算出所有梯度;最后一起更新。
一步一步看
目标:把前向、反向、更新、再前向放进一次迭代,看示例网络的损失怎样从 1.382 降到 1.0023。
-
一次迭代的四个动作,以示例网络为例:
动作 做什么 示例网络里 前向 算出并存下所有 s、h、y、ℓ y = −0.1756,ℓ = 1.382 反向 从 2(y − ȳ) 出发算累积误差和梯度 10 个梯度,如 dℓ/dw₉ = −1.1133 更新 每个权重 w ← w − η · dℓ/dw η = 0.1 回到前向 用新权重再算一遍损失 损失降到 1.0023 -
前向用矩阵乘法加速:一层的所有 s 可以写成一个权重矩阵乘一个向量,一次算完。
-
反向复用中间值:前向存下的 h、σ(s),以及从后往前算出的累积误差,都直接拿来用。
-
四个动作循环,直到损失足够小。
怎么算
更新一步,拿 w₉ 举例:
w₉ 新 = w₉ − η · dℓ/dw₉ = 1.0 − 0.1 × (−1.1133) = 1.1113
意思是:dℓ/dw₉ 为负,说明 w₉ 变大损失会变小,所以 w₉ 被调大。10 个权重都这样各改一次,再走一遍前向,同一样本的损失从 1.382 降到 1.0023。
常见误解
以为 BP 是一种更新参数的算法
BP 只负责高效地求出梯度,更新由梯度下降第 4 步 w ← w − η·dL/dw 完成。两者是配合关系,不是同一件事。
以为 BP 和链式法则完全是一回事
数学内容就是链式法则。BP 多出来的是计算顺序:从后往前,每个累积误差只算一次,被前面所有层复用。直接对每个权重套链式法则也能算对,只是重复计算多。
试一下
用 η = 0.1 更新 w₁ 和 w₁₀,新值各是多少?
w₁ 新 = 0.5 − 0.1 × (−0.0784) = 0.50784。w₁₀ 新 = −1.0 − 0.1 × (−1.5262) = −0.84738。两个梯度都为负,所以两个权重都被调大。
把它们串起来
反向传播没有新的数学,用的就是上一页的链式法则和局部导数表。它的贡献是顺序。
从损失出发,先拿到原始误差 2(y − ȳ)。每往回一层,把下游累积误差乘上连线权重,多个下游就相加,再乘本节点的 σ′,得到这一层的累积误差。任一权重的梯度,就是它指向的那个累积误差乘它出发的那个激活。
网络不是全连接时,规则不变,只是先顺着真实的箭头把路找清楚。走不到的输出,梯度是 0。
BP 交出梯度就结束了,改权重是梯度下降的事。前向、反向、更新,一来一回算一次迭代。
这套流程有它的毛病:σ′ 最大只有 0.25,层一多,前面层的梯度会被乘得很小;每次用一个样本还是全部样本求梯度,各有代价;网络大了还会过拟合。下一讲处理这些问题。
课件里的坑
- [缺字母] p.39 左边式子的分母写成 w₆₁,缺了 d,应为 dℓ₁/dw₆₁(p.39)
- [读图提醒] p.39 公开的 dℓ₁/dw₅₈ = dℓ₁/dy₁ · dy₁/dh₈ · h₅ 省略了 h₈ 的激活导数。若 h₈ 带 sigmoid,完整写法要在中间乘 σ(s₈)(1−σ(s₈));考试按题目给的节点定义补全(p.39)
- [答案被遮] p.40 的答案框整块被遮住,本页 w₂₄、w₁₃ 的路径是按 p.39 的连线表推出来的,没有原答案可对照(p.40)
- [没给数值] p.26–35 只推符号式,没有代数值。本页的数值是自设的一组,用来核对每一步;考试多半只要求写出表达式(p.35)
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先默写三条公式:原始误差、累积误差往回传、梯度等于下游累积误差乘上游激活;再在示例网络上写出 dℓ/dw₉、dℓ/dw₅、dℓ/dw₁ 三个符号式,注意 w₁ 是两条路;然后在练习网络上数 w₂₄ 和 w₁₃ 各有几条路;最后回答一句话:BP 和梯度下降是什么关系。
必背
- 任一权重的梯度 = 下游累积误差 × 上游激活。
- 累积误差往回传一层:乘连线上的权重,再乘该节点的 σ′;一个节点连向几个下游,就把几条路加起来。
- 越靠前的权重求导链越长、路径越多,但前半段的累积误差可以复用。
- 非全连接网络只沿真实存在的连线找路径;碰不到某个输出,对那个输出的梯度就是 0。
- BP 负责计算梯度,参数更新由梯度下降完成。
- 一次训练迭代:前向算出并存下所有值,反向算累积误差和梯度,再更新全部权重。
课件例题
例 1(课件 p.26–35):示例网络逐个求 10 个权重的梯度
见下方完整例题。
例 2(课件 p.39):非全连接、双输出网络的梯度
题面:3 个输入、三个隐藏层、2 个输出,不是全连接。连线是:x₁ 连 h₁、h₂,还有一条跨层线 x₁→h₃(权重 w₁₃);x₂ 连 h₂;x₃ 连 h₁;h₁ 连 h₃、h₄;h₂ 连 h₄(w₂₄)、h₅;h₃ 连 h₇;h₄ 连 h₆、h₈;h₅ 连 h₆、h₈(w₅₈);h₆ 连 y₁(w₆₁);h₇ 连 y₂;h₈ 连 y₁、y₂。总损失 ℓ = ℓ₁ + ℓ₂。求 dℓ₁/dw₆₁ 和 dℓ/dw₅₈。
提示
先看每个权重指向哪个节点,再从那个节点顺着箭头走到输出,数清有几条路。w₆₁ 直接连输出;w₅₈ 指向 h₈,h₈ 连两个输出。
解答
- w₆₁ 直接连到 y₁,只影响 ℓ₁:dℓ₁/dw₆₁ = dℓ₁/dy₁ · dy₁/dw₆₁,后一项就是输入 h₆。y₁ 若带激活还要乘它的导数。
- w₅₈ 影响 h₈,h₈ 同时通向 y₁ 和 y₂,有两条路径:dℓ/dw₅₈ = (dℓ₁/dy₁ · dy₁/dh₈ + dℓ₂/dy₂ · dy₂/dh₈) · dh₈/dw₅₈。
- 课件公开的 dℓ₁/dw₅₈ = dℓ₁/dy₁ · dy₁/dh₈ · h₅ 只是第一条。h₈ 若是 σ(s₈),中间还要乘 σ(s₈)(1−σ(s₈))。
例 3(课件 p.40):同一网络求 dℓ/dw₂₄ 和 dℓ/dw₁₃
题面:沿用例 2 的网络,课件答案框被遮住。
提示
w₂₄ 指向 h₄,从 h₄ 往后数路;w₁₃ 指向 h₃,h₃ 后面只有一条线。
解答
- w₂₄ 影响 h₄;h₄ 连 h₆、h₈;h₆ 只连 y₁,h₈ 连 y₁ 和 y₂,共三条路径。
- dℓ/dw₂₄ = [dℓ₁/dy₁ · dy₁/dh₆ · dh₆/dh₄ + dℓ₁/dy₁ · dy₁/dh₈ · dh₈/dh₄ + dℓ₂/dy₂ · dy₂/dh₈ · dh₈/dh₄] · dh₄/dw₂₄。
- w₁₃ 是 x₁→h₃;h₃ 只连 h₇,h₇ 只连 y₂,只有一条路径:dℓ/dw₁₃ = dℓ₂/dy₂ · dy₂/dh₇ · dh₇/dh₃ · dh₃/dw₁₃。
- dℓ₁/dw₁₃ = 0,w₁₃ 影响不到 y₁。梯度只和真实存在的下游路径有关。答案框被遮,以上按连线自行推出。
例 4(课件 p.41):Back Propagation = Chain Rule?
题面:课堂讨论题,BP 和链式法则是不是一回事?
提示
分开看两件事:用到的数学是什么,计算的顺序有什么讲究。再想想 BP 做到哪一步为止。
解答
- 数学内容就是链式法则:一条路上乘,多条路相加。
- BP 多出来的是计算顺序:从输出往回算,每个累积误差只算一次,被前面所有层复用。
- BP 只负责算梯度,更新参数靠梯度下降。
完整例题
题面(课件 p.26–35):p.26 的网络是 2 输入,两个各 2 单元的 sigmoid 隐藏层,线性输出,无偏置,ℓ = (y − ȳ)²。第一层 s₁ = w₁x₁ + w₂x₂、s₂ = w₃x₁ + w₄x₂,第二层 s₃ = w₅h₁ + w₆h₂、s₄ = w₇h₁ + w₈h₂,输出 y = w₉h₃ + w₁₀h₄,每个 h 是对应 s 的 σ。课件逐页推出全部 10 个权重的梯度。写出 dℓ/dw₉、dℓ/dw₅、dℓ/dw₁ 的公式,再代入数值。
约定:课件没给数值,以下代入自设数值:x = (1, 0.5),ȳ = 1,w₁…w₁₀ = 0.5, −0.5, 0.3, 0.8, 1.0, −1.0, 0.5, 0.5, 1.0, −1.0。σ′ 用 h(1 − h),保留四位小数。
解法:
- 符号式:dℓ/dw₉ = 2(y − ȳ) · h₃。
- 符号式:dℓ/dw₅ = 2(y − ȳ) · w₉ · σ(s₃)(1−σ(s₃)) · h₁。
- 符号式:dℓ/dw₁ 有两条路径相加:2(y−ȳ) · w₉ · σ(s₃)(1−σ(s₃)) · w₅ · σ(s₁)(1−σ(s₁)) · x₁ + 2(y−ȳ) · w₁₀ · σ(s₄)(1−σ(s₄)) · w₇ · σ(s₁)(1−σ(s₁)) · x₁。
- 其余 7 个照替换规则写:w₁₀ 把 h₃ 换 h₄;w₆ 把 h₁ 换 h₂;w₇、w₈ 走 s₄ 一侧,用 w₁₀ 和 σ(s₄);w₂、w₄ 末尾乘 x₂;w₃、w₄ 走 h₂ 一侧,用 w₆、w₈ 和 σ(s₂)。
- 前向:s₁ = 0.25,s₂ = 0.7,h₁ = 0.5622,h₂ = 0.6682;s₃ = −0.106,s₄ = 0.6152,h₃ = 0.4735,h₄ = 0.6491;y = −0.1756,ℓ = (−1.1756)² = 1.382。
- 输出层:原始误差 2(y − ȳ) = −2.3512,dℓ/dw₉ = −2.3512 × 0.4735 = −1.1133。
- 第二层:δ₃ = −2.3512 × 1.0 × 0.2493 = −0.5862;dℓ/dw₅ = −0.5862 × 0.5622 = −0.3295。
- 第一层:δ₄ = −2.3512 × (−1.0) × 0.2278 = 0.5355。h₁ 两条路径:δ₁ = (−0.5862 × 1.0 + 0.5355 × 0.5) × 0.2461 = −0.0784,再乘 x₁ = 1,dℓ/dw₁ = −0.0784。
要点:答案 y = −0.1756,ℓ = 1.382,dℓ/dw₉ = −1.1133,dℓ/dw₅ = −0.3295,dℓ/dw₁ = −0.0784。三个公式的开头都是 2(y − ȳ);dℓ/dw₅ 的前半段就是 δ₃,dℓ/dw₁ 的两项开头就是 δ₃ 和 δ₄。
答题格式:先写符号式,标清每一项是哪个局部导数;再按「前向 → 原始误差 → 各层累积误差 → 梯度」的顺序代数。
变式题(先自己做)
改编自课件 p.26–35。同一网络、同一组权重,换成 x = (0.5, 1),ȳ = 0。求 y、ℓ,以及 dℓ/dw₁₀、dℓ/dw₇、dℓ/dw₃。
提示
w₁₀ 只有一条路径,乘 h₄;w₇ 走 s₄ 那一侧,用 w₁₀ 和 σ′(s₄);w₃ 进 s₂,h₂ 经 w₆ 和 w₈ 两条路,末尾乘 x₁ = 0.5。sigmoid 导数用 h(1 − h) 直接算。
判分点与答案(非官方)
判分点:① 前向四个 s、h 正确;② 原始误差符号正确(y < ȳ 时为负,这里 ȳ = 0 而 y 为负);③ dℓ/dw₃ 写出两条路径并相加;④ 末尾乘的是 x₁ 而不是 x₂。
- s₁ = 0.25 − 0.5 = −0.25,s₂ = 0.15 + 0.8 = 0.95;h₁ ≈ 0.4378,h₂ ≈ 0.7211。
- s₃ ≈ −0.2833,s₄ ≈ 0.5795;h₃ ≈ 0.4296,h₄ ≈ 0.6409。
- y ≈ 0.4296 − 0.6409 = −0.2113,ℓ ≈ 0.0446,原始误差 2(y − ȳ) ≈ −0.4226。
- dℓ/dw₁₀ ≈ −0.4226 × 0.6409 ≈ −0.2709。
- s₄ 处累积误差 ≈ −0.4226 × (−1.0) × 0.2301 ≈ 0.0973;dℓ/dw₇ ≈ 0.0973 × 0.4378 ≈ 0.0426。
- s₃ 处累积误差 ≈ −0.4226 × 1.0 × 0.2451 ≈ −0.1036;s₂ 处 ≈ (−0.1036 × (−1.0) + 0.0973 × 0.5) × 0.2011 ≈ 0.0306;dℓ/dw₃ ≈ 0.0306 × 0.5 ≈ 0.0153。
闪卡自测
1. 所有梯度从哪个数开始?
原始误差 2(y − ȳ),它出现在全部 10 个梯度里(p.35)。
2. 写出 dℓ/dw₆。
2(y − ȳ) · 1 · w₉ · σ(s₃)(1−σ(s₃)) · h₂,和 dℓ/dw₅ 只差最后的 h₁ 换成 h₂(p.35)。
3. dℓ/dw₄ 为什么有两项?
w₄ 进入 s₂,h₂ 同时连向 s₃(经 w₆)和 s₄(经 w₈),两条路径按并联规则相加(p.34)。
4. p.35 说的「可以复用中间值」具体复用了什么?
2(y − ȳ) 出现在全部 10 个梯度里;s₃、s₄ 处的累积误差被第二层和第一层的梯度共用(p.35)。
5. w₉、w₅、w₁ 的梯度各由几个因子组成?
w₉ 是 3 个,w₅ 是 5 个,w₁ 是两条各 7 个因子的路径相加(p.35)。
6. 练习网络里 dℓ₁/dw₁₃ 等于多少?
0。w₁₃ 唯一的下游路径是 h₃→h₇→y₂,影响不到 y₁(p.40)。
7. 练习网络里 w₂₄ 有几条路径?
三条:h₄→h₆→y₁、h₄→h₈→y₁、h₄→h₈→y₂(p.40)。
8. 判断:反向传播会更新参数。
错。BP 计算梯度,更新由梯度下降完成(p.36)。
9. p.36 说前向和反向各靠什么提高效率?
前向用矩阵乘法一次算完一层,反向复用前向存下的值和已算好的累积误差(p.36)。
10. p.39 左边式子哪里写错了?
分母缺了 d,应为 dℓ₁/dw₆₁(p.39)。
下一讲
下一讲接着处理训练这套网络时的问题:用 mini-batch 和动量改进优化,用 ReLU 缓解梯度消失,用正则化防过拟合:L05a。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。