L04c 链式法则:把多层网络的导数拆成一段一段
梯度下降要每个权重的导数,可多层网络是函数套函数。先补上梯度下降四步,再讲链式法则的串联和并联两条规则,最后在示例网络上把前向传播和每一个局部导数都算出来。
一句话版
训练网络靠梯度下降,梯度下降要损失对每个权重的导数。多层网络是函数套函数,直接求很乱,链式法则把它拆开:每一步只求相邻两个量之间的导数(局部导数),沿路径乘起来,有几条路就加几次。
前两页 L04a、L04b 搭好了网络。这一页准备求导要用的全部零件,下一页把它们拼成反向传播。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 梯度 | gradient | 损失对所有参数的导数排成的一列 |
| η | 读「伊塔」,learning rate,学习率 | 每次沿梯度走多远 |
| 链式法则 | chain rule | 函数套函数时,总导数等于每一层的导数相乘 |
| 局部导数 | local derivative | 只牵涉相邻两个量的那一小段导数 |
| 前向传播 | forward propagation | 从输入往输出,一层层把值算出来 |
| s 和 h | 加权和 / 激活值 | s 是过激活之前的数,h 是过激活之后的数 |
| ℓ、ȳ | 读「小 l」「y bar」 | ℓ 是单个样本的损失,ȳ 是真实标签 |
| σ′ | 读「西格玛一撇」 | sigmoid 的导数 |
一个类比:换汇链
你手上有人民币,先换成港币,再换成美元,最后换成欧元。想知道「多 1 块人民币,最后多几欧元」,不用重新算整条链,把每一段的汇率乘起来就行:人民币到港币乘一个数,港币到美元乘一个数,美元到欧元再乘一个数。
每一段汇率就是一个局部导数,全程汇率就是链式法则的乘积。
如果你的钱分成两份,一份走港币那条线,一份走日元那条线,最后都换成欧元,那「多 1 块人民币多几欧元」就是两条线各自的全程汇率加起来。这是多条路径相加。
类比在哪里失效:
- 汇率在一天里大致不变。网络里每一段的「汇率」随输入变化,σ′ 这一段尤其明显,换一个样本就要重算。
- 换汇是真的把钱换过去。求导只是在问「这里动一点,那里跟着动多少」,网络里的值本身不变。
从零讲起
1. 先补一块:梯度下降要什么(补充)
它解决什么问题
网络搭好以后,权重要靠训练找。梯度下降是前几讲用过的找法。这里把它的四步重新摆出来,看清楚多层网络卡在哪一步。
直觉
站在山坡上,蒙着眼要走到谷底。你能做的是用脚试一下:哪个方向往下,就往那边迈一步。迈完再试,再迈。
「哪个方向往下」就是导数告诉你的。每个权重都要知道自己的导数,才知道该往大调还是往小调。
线性回归时,导数有现成公式。到了多层网络,损失是权重的多重复合函数,第 3 步「求导数」变成了难题。
一步一步看
目标:把梯度下降四步放到多层网络里逐步检查,看出只有第 3 步求导数卡住了。
-
梯度下降四步,和线性回归那时一样:
步 做什么 1 随机选初值 w₁⁰、w₂⁰、… 2 算损失 L;足够小就停,否则继续 3 求每个参数在当前位置的导数 dL/dw₁、dL/dw₂、… 4 更新 w ← w − η · dL/dw,回到第 2 步 -
第 1、2、4 步在多层网络里照样能做:初值随便选,损失照样能算,更新只是减法。
-
卡住的是第 3 步。课件把所有导数排成一列(梯度),旁边画了一个问号。
-
这一页和下一页就是回答这个问号。
怎么算
更新公式:
w¹ = w⁰ − η · dL/dw
意思是:新的权重 = 旧的权重 − 学习率 × 导数。导数为正,说明这个权重变大损失会变大,就把它调小;导数为负则调大。η 控制每次调多少。
常见误解
以为梯度下降一次就把所有权重调到最好
一次只走一小步。梯度只说明当前位置哪边往下,走出去以后坡度变了,要重新求导数再走。
试一下
w⁰ = 0.5,dL/dw = −1.1133,η = 0.1。更新后 w 是多少?往哪边调了?
w¹ = 0.5 − 0.1 × (−1.1133) = 0.5 + 0.11133 = 0.61133。导数为负,所以权重被调大了。
2. 链式法则:路径上相乘,多条路相加
它解决什么问题
网络的输出是函数套函数:输入算出 s,s 过激活得 h,h 再算下一层的 s……损失对最前面一个权重的导数,要穿过好几层。链式法则把这条长导数拆成一段段好求的短导数。
从哪来(补充)
链式法则最早出现在 Leibniz 1676 年的一份手稿里,那份推导里还有一个符号错误。
直觉
x 稍微动一点,m = h(x) 跟着动 h′(x) 倍;m 动了,n = g(m) 跟着动 g′(m) 倍;n 动了,y 跟着动 f′(n) 倍。三个倍数接力,乘起来就是 y 跟着 x 动多少倍。
如果 x 同时经两条路影响 y,两条路带来的变化会叠加。每条路自己乘出一个倍数,再加起来。
一步一步看
目标:分别看串联和并联两种结构,看链式法则怎样沿一条路相乘、把多条路的结果相加。
-
串联:y = f(g(h(x)))。从 x 到 y 只有一条路,经过 m 和 n 两个中间量。每段箭头下面写它的局部导数,三个乘起来。
-
并联:y = a·[g(x) + h(x)]。x 分成两条路:一条经 m = g(x),一条经 n = h(x),最后都汇到 y。
-
每条路各自相乘:上路 a · g′(x),下路 a · h′(x)。
-
两条路的结果相加,就是 dy/dx。
怎么算
串联:
dy/dx = (dy/dn) · (dn/dm) · (dm/dx) = f′(n) · g′(m) · h′(x)
并联:
dy/dx = (dy/dm) · (dm/dx) + (dy/dn) · (dn/dx) = a · g′(x) + a · h′(x)
意思是:串联时沿唯一一条路,把每段的局部导数乘起来;并联时每条路各乘各的,最后把各条路的结果加起来。
代数验算:取 a = 3、g(x) = x²、h(x) = sin x,在 x = 1 处
dy/dx = 3 · 2x + 3 · cos x = 3 × 2 + 3 × cos 1 ≈ 7.621
用数值差分(让 x 挪一点点看 y 变多少)也得 7.621。
反向传播的全部规则就是这两条:一条路上乘,多条路相加。
常见误解
以为并联时也把两条路乘起来
两条路是两份独立的影响,叠加起来用加法。只有同一条路上前后接力的几段才相乘。
只写了一条路径
网络里一个中间量经常连到下一层的好几个神经元。漏掉一条路,导数就少一块。动笔前先数清楚从这个量到输出一共有几条路。
试一下
y = (3x + 1)²,用链式法则求 x = 1 处的 dy/dx。
令 m = 3x + 1,y = m²。dy/dm = 2m,dm/dx = 3。x = 1 时 m = 4,dy/dx = 2 × 4 × 3 = 24。
3. 局部导数:示例网络上的每一小段
它解决什么问题
链式法则要的零件是局部导数。这一节在课件的示例网络上,先把前向的值算出来,再把每一个局部导数列成表。下一页拼反向传播时,只需要从表里取零件相乘。
直觉
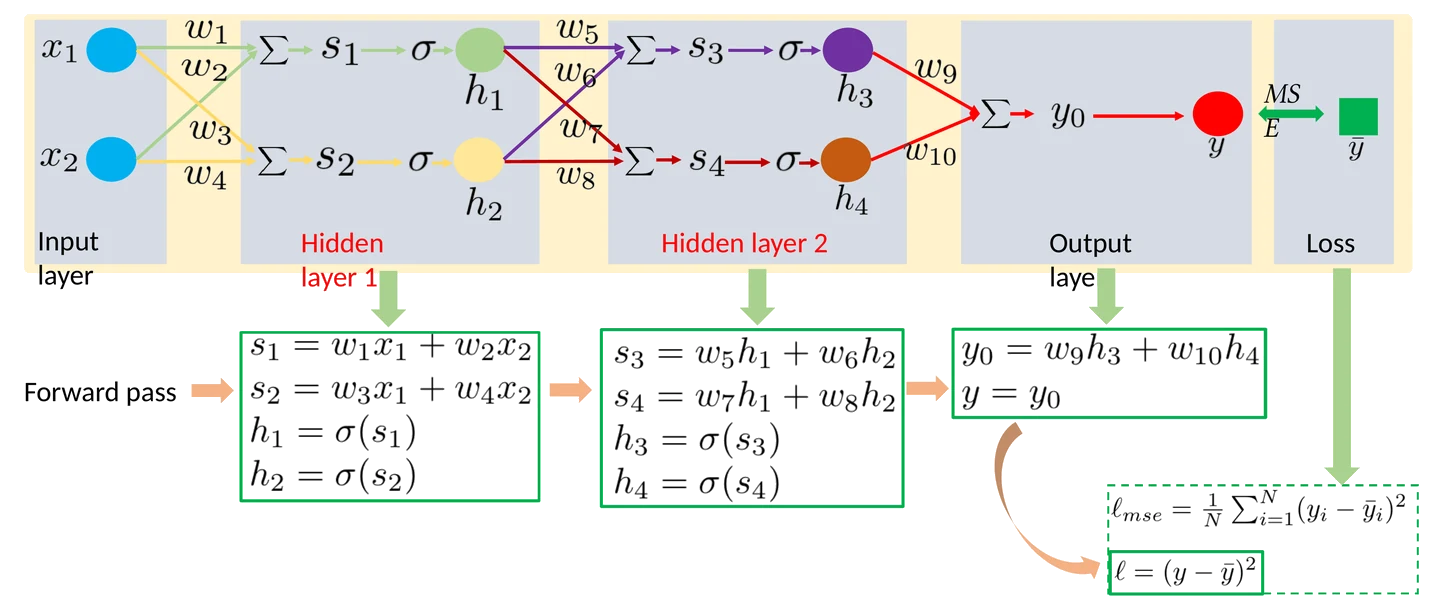
示例网络有 2 个输入、两个隐藏层各 2 个 sigmoid 神经元、1 个输出,不带偏置,共 10 个权重。输出层不加激活,损失是 ℓ = (y − ȳ)²。
前向传播的每一个式子都很短:要么是加权和,要么是过 sigmoid。对短式子求导很容易,所以局部导数只有三种样子:
- 加权和对权重求导,得到这个权重乘的那个输入
- 加权和对上一层输出求导,得到对应的权重
- 激活值对加权和求导,得到 σ′(s) = σ(s)(1 − σ(s))
一步一步看
目标:用一组数值把示例网络的前向逐层算完,顺手备好四个 sigmoid 导数,留给反向传播用。
用一组数值把前向走一遍:x = (1, 0.5),ȳ = 1,w₁…w₁₀ = 0.5, −0.5, 0.3, 0.8, 1.0, −1.0, 0.5, 0.5, 1.0, −1.0。青绿色标的是这一步新算出来的值。
-
第一层:s₁ = 0.5×1 − 0.5×0.5 = 0.25,s₂ = 0.3×1 + 0.8×0.5 = 0.7。过 sigmoid 得 h₁ = 0.5622,h₂ = 0.6682。
-
第二层:拿 h₁、h₂ 当输入。s₃ = 1.0×0.5622 − 1.0×0.6682 = −0.106,s₄ = 0.5×0.5622 + 0.5×0.6682 = 0.6152。过 sigmoid 得 h₃ = 0.4735,h₄ = 0.6491。
-
输出层不加激活:y = 1.0×0.4735 − 1.0×0.6491 = −0.1756。损失 ℓ = (−0.1756 − 1)² = 1.382。
-
把四个 sigmoid 的导数也顺手算好,下一页要用:σ′(s₁) = 0.5622 × 0.4378 = 0.2461,σ′(s₂) = 0.6682 × 0.3318 = 0.2217,σ′(s₃) = 0.4735 × 0.5265 = 0.2493,σ′(s₄) = 0.6491 × 0.3509 = 0.2278。
怎么算
把前向的每个式子单独求导,得到全部局部导数:
| 位置 | 局部导数 |
|---|---|
| 第一层 | ds₁/dw₁ = x₁,ds₁/dw₂ = x₂,ds₂/dw₃ = x₁,ds₂/dw₄ = x₂ |
| 第一层激活 | dh₁/ds₁ = σ(s₁)(1−σ(s₁)),dh₂/ds₂ = σ(s₂)(1−σ(s₂)) |
| 第二层(对权重) | ds₃/dw₅ = h₁,ds₃/dw₆ = h₂,ds₄/dw₇ = h₁,ds₄/dw₈ = h₂ |
| 第二层(对上一层输出) | ds₃/dh₁ = w₅,ds₃/dh₂ = w₆,ds₄/dh₁ = w₇,ds₄/dh₂ = w₈ |
| 第二层激活 | dh₃/ds₃ = σ(s₃)(1−σ(s₃)),dh₄/ds₄ = σ(s₄)(1−σ(s₄)) |
| 输出层 | dy/dw₉ = h₃,dy/dw₁₀ = h₄,dy/dh₃ = w₉,dy/dh₄ = w₁₀ |
| 损失 | dℓ/dy = 2(y − ȳ) |
意思是:表里每一格都只牵涉相邻两个量。加权和对权重的导数就是它乘的输入,对上一层输出的导数就是那个权重,激活对加权和的导数是 σ′。
sigmoid 的导数为什么是 σ(1 − σ):
σ(s) = 1 / (1 + e⁻ˢ),σ′(s) = e⁻ˢ / (1 + e⁻ˢ)² = σ(s) · [1 − σ(s)]
意思是:只要前向时存下了 σ(s),导数就是「它乘以 1 减它」,不用再算一次指数。
σ(s) 是 0 到 1 之间的数,两个加起来是 1 的数相乘,最大是 0.5 × 0.5 = 0.25,出现在 s = 0。s 往两边走,σ′ 很快贴近 0。
常见误解
把 s 和 h 混用
s 是激活之前的加权和,h 是激活之后的值。dh/ds 是 σ′,ds/dh 是权重,方向写反了就全错。写局部导数时先看清分子分母各是 s 还是 h。
以为 σ′ 要重新算一次指数
σ′(s) = σ(s)(1 − σ(s)),σ(s) 前向时已经算好存着(就是 h),直接拿 h(1 − h) 就行。这是反向传播能复用中间值的一个来源。
试一下
输出层改成 y = σ(w₉h₃ + w₁₀h₄),表里哪一行要改?
输出层要多一个局部导数:dy/dy₀ = σ(y₀)(1 − σ(y₀)),其中 y₀ = w₉h₃ + w₁₀h₄。原来不加激活时这一项是 1,所以可以省掉。
把它们串起来
梯度下降的四步里,只有「求每个权重的导数」在多层网络里变难了,因为损失是权重的多重复合函数。
链式法则把这件难事拆小。它只有两条规则:同一条路上的局部导数相乘,不同的路相加。
拆完以后要的零件就是局部导数,而局部导数只有三种样子:加权和对权重给输入,对上一层输出给权重,激活对加权和给 σ′。σ′ 用前向存好的 h 就能算,最大只有 0.25。
所以动手求导之前,先走一遍前向,把每个 s、h、y、ℓ 和 σ′ 都算好存下。下一页从损失出发往回走,把这些零件按路径拼起来,就是反向传播。
课件里的坑
- [记号] p.26 的输出先写成 y₀ = w₉h₃ + w₁₀h₄,再写 y = y₀。输出层不加激活,所以 dy/dy₀ = 1,课件的梯度式里会多出一个「· 1」,它就是这一项(p.26、p.28)
- [损失写法] p.26 的 MSE 写成 (1/N)Σ(yᵢ − ȳᵢ)²,后面推导只看一个样本,简化成 ℓ = (y − ȳ)²,求导得 2(y − ȳ)。考试时看清题目要的是单样本还是整批(p.26)
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先默写梯度下降四步,圈出多层网络卡住的那一步;再画出串联和并联两张小图,写出各自的 dy/dx;然后把示例网络的局部导数表默写一遍;最后用 x = (1, 0.5) 走一遍前向,核对 y = −0.1756。
必背
- 梯度下降四步:随机初值、算损失、求每个参数的导数、沿负梯度更新;多层网络难在第 3 步。
- 链式法则:一条路径上局部导数相乘,多条路径相加。
- 加权和对权重的导数是它所乘的输入,对上一层输出的导数是对应的权重。
- sigmoid 导数 σ(s)(1−σ(s)),只用前向已算好的 σ(s),最大 0.25(s = 0 时)。
- 前向传播先算出并存下每个 s、h、y 和 ℓ,反向时直接拿来用。
- s 是激活之前的加权和,h 是激活之后的值,两者别混。
课件例题
例 1(课件 p.25):链式法则的串联和并联
题面:(a) y = f(g(h(x))),求 dy/dx。(b) y = a·[g(x) + h(x)],求 dy/dx。
提示
(a) 引入中间量 m = h(x)、n = g(m),沿唯一一条路相乘。(b) x 有两条路到 y,各自相乘再相加。
解答
- (a) 令 m = h(x)、n = g(m),dy/dx = f′(n)·g′(m)·h′(x),一条路径上逐步相乘。
- (b) x 经 g、h 两条路影响 y,dy/dx = a·g′(x) + a·h′(x),每条路径各自相乘再相加。
- 代数验算:a = 3、g = x²、h = sin x,在 x = 1 处 dy/dx = 3·2 + 3·cos 1 ≈ 7.621。
例 2(课件 p.26–27):写出示例网络的全部局部导数
题面:p.26 的网络 2 输入、两个各 2 单元的 sigmoid 隐藏层、线性输出、无偏置,ℓ = (y − ȳ)²。把前向的每个式子单独求导,列出全部局部导数。
提示
按层走:先写四个加权和对权重的导数,再写激活的导数,再写加权和对上一层输出的导数,最后是输出层和损失。
解答
- 第一层:ds₁/dw₁ = x₁,ds₁/dw₂ = x₂,ds₂/dw₃ = x₁,ds₂/dw₄ = x₂;dh₁/ds₁ = σ(s₁)(1−σ(s₁)),dh₂/ds₂ 同理。
- 第二层:ds₃/dw₅ = h₁,ds₃/dw₆ = h₂,ds₄/dw₇ = h₁,ds₄/dw₈ = h₂;ds₃/dh₁ = w₅,ds₃/dh₂ = w₆,ds₄/dh₁ = w₇,ds₄/dh₂ = w₈;dh₃/ds₃、dh₄/ds₄ 是对应的 σ′。
- 输出层:dy/dw₉ = h₃,dy/dw₁₀ = h₄,dy/dh₃ = w₉,dy/dh₄ = w₁₀。
- 损失:dℓ/dy = 2(y − ȳ)。
完整例题
题面(课件 p.26–27 的网络,数值自设):x = (1, 0.5),ȳ = 1,w₁…w₁₀ = 0.5, −0.5, 0.3, 0.8, 1.0, −1.0, 0.5, 0.5, 1.0, −1.0(网络见上图)。走一遍前向传播,求 y 和 ℓ,并算出四个 sigmoid 的导数值。
约定:σ(z) = 1 / (1 + e⁻ᶻ),保留四位小数,输出层不加激活。
解法:
- s₁ = w₁x₁ + w₂x₂ = 0.5 × 1 + (−0.5) × 0.5 = 0.25。
- s₂ = w₃x₁ + w₄x₂ = 0.3 × 1 + 0.8 × 0.5 = 0.7。
- h₁ = σ(0.25) = 0.5622,h₂ = σ(0.7) = 0.6682。
- s₃ = w₅h₁ + w₆h₂ = 1.0 × 0.5622 − 1.0 × 0.6682 = −0.106。
- s₄ = w₇h₁ + w₈h₂ = 0.5 × 0.5622 + 0.5 × 0.6682 = 0.6152。
- h₃ = σ(−0.106) = 0.4735,h₄ = σ(0.6152) = 0.6491。
- y = w₉h₃ + w₁₀h₄ = 0.4735 − 0.6491 = −0.1756。
- ℓ = (y − ȳ)² = (−1.1756)² = 1.382。
- σ′ 用 h(1 − h):σ′(s₁) = 0.2461,σ′(s₂) = 0.2217,σ′(s₃) = 0.2493,σ′(s₄) = 0.2278。
要点:四个 σ′ 都比 0.25 小一点,因为四个 s 都离 0 不远。后面每往回乘一个 σ′,数值就缩到四分之一以下。
答题格式:按层列「s → h」,每一行写式子再写结果;最后单独一行写四个 σ′。
变式题(先自己做)
改编自课件 p.26–27。同一网络、同一组权重,换成 x = (0.5, 1),ȳ = 0。求 s₁…s₄、h₁…h₄、y、ℓ,以及四个 σ′。另外用链式法则求 y = 2·[x³ + eˣ] 在 x = 1 处的 dy/dx。
提示
照完整例题一层层算,只是 x₁、x₂ 对调了。第二问是并联:两条路分别是 3x² 和 eˣ,各乘 2 再相加。
判分点与答案(非官方)
判分点:① 第一层 s₁、s₂ 代入正确;② h 和 s 不混;③ ℓ 用 ȳ = 0;④ σ′ 用 h(1 − h);⑤ 第二问两条路相加。
- s₁ = 0.25 − 0.5 = −0.25,s₂ = 0.15 + 0.8 = 0.95;h₁ ≈ 0.4378,h₂ ≈ 0.7211。
- s₃ ≈ −0.2833,s₄ ≈ 0.5795;h₃ ≈ 0.4296,h₄ ≈ 0.6409。
- y ≈ 0.4296 − 0.6409 = −0.2113,ℓ = (−0.2113 − 0)² ≈ 0.0446。
- σ′(s₁) ≈ 0.2461,σ′(s₂) ≈ 0.2011,σ′(s₃) ≈ 0.2451,σ′(s₄) ≈ 0.2301。
- dy/dx = 2 · 3x² + 2 · eˣ,x = 1 时 = 6 + 2e ≈ 11.437。
闪卡自测
1. 梯度下降四步里,多层网络卡在哪一步?
第 3 步:求每个参数的导数(p.24)。
2. 链式法则的两条规则是什么?
一条路径上局部导数相乘,多条路径相加(p.25)。
3. ds₃/dw₅ 等于什么?ds₃/dh₁ 呢?
ds₃/dw₅ = h₁,ds₃/dh₁ = w₅(p.27)。
4. sigmoid 的导数是什么?最大值多少?
σ(s)(1−σ(s)),s = 0 时最大,等于 0.25(p.27)。
5. 示例网络一共几个权重?有没有偏置?
10 个权重,没有偏置(p.26)。
6. 示例网络的输出层有激活吗?
没有,y = w₉h₃ + w₁₀h₄,是回归输出(p.26)。
7. dℓ/dy 是多少?
ℓ = (y − ȳ)²,所以 dℓ/dy = 2(y − ȳ)(p.27)。
8. 为什么说 σ′ 能复用前向的结果?
σ′(s) = h(1 − h),h 前向时已经算好存着,不用再算指数(p.27)。
9. y = a·[g(x) + h(x)] 的 dy/dx 是什么?
a·g′(x) + a·h′(x)(p.25)。
下一讲
本讲下一页从损失出发往回走,把局部导数按路径拼成全部 10 个梯度,这就是反向传播:L04d。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。