L08d 隐式反馈与 BPR:没有评分,就改学顺序
隐式数据为什么没有负例;逐点预测和成对比较差在哪里;BPR 怎样为每个用户配出正负物品对;sigmoid 从零讲起;BPR 损失怎么算,代码里的 softplus 为什么和公式一模一样。
一句话版
现实里多数数据只有点击和购买,没有评分,也没有「不喜欢」。于是推荐不再猜分数,改成学顺序:同一个用户交互过的物品,得分要高于他没交互过的物品。这就是 BPR。
上一页 L08c 的矩阵分解默认有评分,这一页换成只有行为记录的情况。用户向量、物品向量、内积这些东西照用,变的是训练目标。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 隐式反馈 | implicit feedback | 点击、购买、收藏这类顺手留下的行为 |
| 逐点 / 成对 | pointwise / pairwise | 一次看一个格子,还是一次比较两个物品 |
| 排序学习 | learning to rank | 只学谁该排在前面,不学具体分数 |
| BPR | Bayesian Personalized Ranking,贝叶斯个性化排序 | 让交互过的物品得分高于没交互过的 |
| σ | sigmoid,读「西格玛」 | 把任意数压到 0 到 1 之间 |
| softplus | 读「soft plus」 | ln(1 + eˣ),代码里用它写 BPR 损失 |
一个类比:只有购物小票的店长
有评分的数据像顾客填的满意度问卷,几分就是几分。隐式数据像一沓购物小票。小票上只有买过什么,没有「我讨厌这个」。顾客没买某件商品,可能是不喜欢,也可能根本没看到货架。
聪明的店长不去猜每件商品的满意度分数。他只确认一件事:顾客买过的东西,应该摆在他没买过的东西前面。两件都没买过的,谁前谁后不下结论。
类比在哪里失效:
- 真实 BPR 对每个用户单独比较,比较靠的是分数差和 sigmoid 算出的概率。
- 店长会看小票上买了几次,BPR 的基本版只看有没有交互,不看次数。
从零讲起
1. 隐式数据的三个特征
它解决什么问题
打分要用户主动去做,很少有人做。点击、购买、收藏、浏览、分享、评论是顺手留下的,数量多得多。课件说隐式反馈更容易获得(more readily available)。问题是这种数据和评分长得不一样,直接套上一页的做法会出错。
直觉
评分表里的格子有三种状态:高分、低分、问号。隐式数据的格子只有两种:有交互,问号。「低分」这一档没了。
问号里混着两种人:看过不喜欢的,和根本没见过的。数据分不出来。
一步一步看
目标:把隐式反馈表的 + 记 1、? 记 0,看这些 0 为什么分不清是不喜欢还是没见过。
-
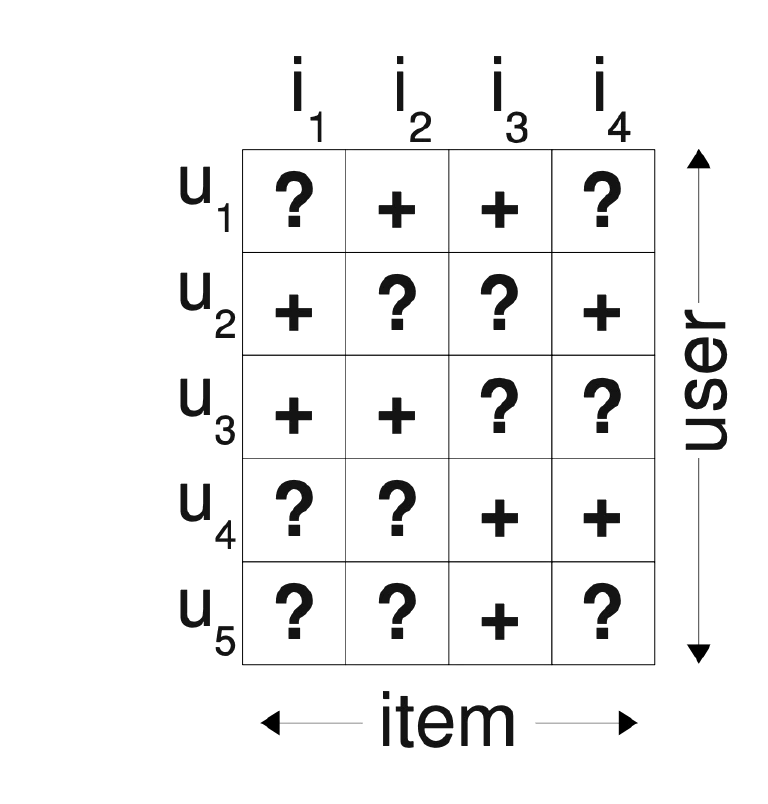
课件的例子:5 个用户 u₁–u₅ × 4 个物品 i₁–i₄,「+」是有交互,「?」是没观测到。
-
常见处理是 + 记 1、? 记 0。u₁ 是 ? + + ?,变成 0 1 1 0。
-
问题在第 2 步:这些 0 有的是不喜欢,有的是没见过,被一律当成了「不喜欢」。
课件列的三个特征,名字要会写:
| 特征 | 英文 | 一句话 |
|---|---|---|
| 没有负反馈 | No Negative feedback | 缺失的数据分不清是不喜欢,还是不知道这个物品 |
| 天然有噪声 | Inherently noisy | 误点、替别人买;但数据量大,能弥补 |
| 偏好 vs 置信度 | Preference vs confidence | 数值通常是频次,不一定反映喜欢的程度 |
怎么判断
拿到一条数据,问两个问题。用户是主动表态的吗?是就是显式,否则是隐式。数值代表喜欢程度还是次数?代表次数的,只能当置信度用。
意思是:同样一个数字 5,在评分里是「很喜欢」,在播放次数里只是「看了 5 遍」,后者需要另外推断一个置信度。
常见误解
以为没交互就等于负例
这正是第一条特征要提醒的。把所有没交互的格子记成 0 再去拟合,模型会学成「没见过就不推荐」,新东西永远推不出去。
以为隐式数据有噪声,所以不如显式数据好用
课件说数据量大能弥补噪声,有助于建立稳健的推荐系统。现实里隐式数据才是主力。
试一下
一个用户把某部剧看了 5 遍,能直接说他的喜爱程度是 5 吗?
不能。隐式数据的数值是频次,反映的更多是置信度,不等于偏好强弱。
2. 逐点与成对:推荐其实是排序
它解决什么问题
上一页的评分预测一次只看一个格子,要把分数猜准。可用户看到的只是一个排好的列表,分数准不准他看不见,顺序对不对他看得见。既然最终只要顺序,训练时就可以只学顺序。
直觉
逐点(pointwise)像给每道菜单独打分。成对(pairwise)像每次端两道菜问「你更想吃哪个」。后者不需要知道这道菜具体值几分,只需要知道谁比谁好。
一步一步看
目标:对比逐点和成对两种问法的输入与答案,看成对排序为什么能当二分类来做。
-
逐点:输入一个 (u, i) 格子,问「分数是几」,目标是把分数猜准。评分预测就是这一类。
-
成对:输入一个三元组 (u, i, j),问「对用户 u,i 是否该排在 j 前面」。答案只有是或否。
-
只有是与否,所以成对排序可以当成标准的二分类问题来做。
怎么判断
课件给了排序学习的四条特征:
- 任务是把最相关的物品排得尽量靠前
- 不预测评分,只预测偏好的顺序
- 训练数据是偏序或二元判断(相关 / 不相关)
- 可以当作标准的监督分类问题处理
意思是:一个方法的训练样本如果是「一个格子 + 一个分数」,它是逐点的;如果是「两个物品 + 谁更好」,它是成对的。
常见误解
以为成对方法就不输出分数了
模型照样给每个物品算分 ŷᵤᵢ,排序时也按分数排。区别在训练:只要求分数的大小关系对,不要求分数等于某个目标值。
以为排序学习是回归问题
课件说它可以当作标准的监督分类问题,因为每个样本的答案只有「排前」或「不排前」。
试一下
训练样本长这样:「用户 7,物品 A 比物品 B 更该排前面」。这是逐点还是成对?
成对。样本是一个三元组和一个二元判断。
3. BPR:怎样配出正负物品对
它解决什么问题
成对训练需要「i 比 j 好」这种样本,可隐式数据里没有人说过谁比谁好。BPR 给了一条规则,从 + 和 ? 里自动造出这些样本,而且不把 ? 当成「不喜欢」。
从哪来(补充)
BPR 出自论文《BPR: Bayesian Personalized Ranking from Implicit Feedback》,作者 Steffen Rendle、Christoph Freudenthaler、Zeno Gantner、Lars Schmidt-Thieme,发表在 UAI 2009。
直觉
规则只有一条:有交互的物品优于没交互的物品。两个都有交互,或两个都没交互,就是「?」,不比较。
BPR 为每个用户单独做一张表,记作 i >ᵤ j。行是 j、列是 i,「+」表示用户更喜欢 i,「−」表示更喜欢 j。
一步一步看
目标:以 u₁ 为例配出正负物品对,再数全部用户的三元组,看 19 条训练数据是怎么来的。
以 u₁ 为例,他交互过 i₂、i₃,没交互过 i₁、i₄。
-
先标出正样本:u₁ 那一行里的两个 +,就是 i₂ 和 i₃。
-
i 取正样本、j 取负样本的格子填「+」,共 2 × 2 = 4 格。这 4 格就是 u₁ 的 4 个训练三元组。
-
反过来的 4 格是「−」。i₂ 与 i₃ 之间、i₁ 与 i₄ 之间填「?」,不比较。
-
每个用户都这样做。u₁–u₄ 都交互过 2 个,各 2 × 2 = 4 个三元组;u₅ 只交互过 1 个,1 × 3 = 3 个。合计 4 × 4 + 3 = 19 个。
怎么算
每个用户的三元组数 = 交互物品数 × 未交互物品数。
训练集写成 O = {(u, i, j) | (u, i) ∈ R⁺, (u, j) ∈ R⁻}。
意思是:O 里每条样本是一个用户 u、一个他交互过的物品 i(来自已观测交互 R⁺)、一个他没交互过的物品 j(来自未观测交互 R⁻)。课件标题把这一步叫负采样(Negative Sampling)。
常见误解
以为 BPR 把没交互的物品当作负例
它只说这些物品应排在交互过的后面。两个都没交互的物品之间不比较,保留了「不知道」的余地。
以为两个都交互过的物品也要比出高低
不比。它们都是 +,数据里没有信息说明哪个更好,表里填「?」。
试一下
一个用户在 5 个物品里交互过 2 个,能配出几个三元组?
2 × 3 = 6 个:每个交互过的物品配每个没交互过的物品。
4. sigmoid:把分数差变成概率(补充)
它解决什么问题
BPR 要回答「i 排在 j 前面的概率是多少」。两个分数相减得到的差可以是任何实数,概率却必须在 0 到 1 之间。需要一个函数把任意实数压进这个区间,这就是 sigmoid。
从哪来(补充)
σ(x) = 1/(1 + e⁻ˣ)。它的「平滑版 ReLU」亲戚叫 softplus,softplus(x) = ln(1 + eˣ),softplus 的导数正好是 sigmoid。
直觉
sigmoid 是一条 S 形曲线。输入是 0 时输出 0.5,两边一样不确定。输入越大,输出越接近 1;输入越小,越接近 0。
BPR 把分数差 ŷᵤᵢ − ŷᵤⱼ 放进去。差越大,「i 排前」的概率越接近 1。
一步一步看
目标:代入几个分数差算 sigmoid 和 −ln,看分数差越大,单对损失越小。
-
分数差 0:σ(0) = 1/(1 + 1) = 0.5,两个物品不分高下。
-
分数差 2:σ(2) 约等于 0.88,i 多半排前。
-
取 −ln:概率越接近 1,−ln 越接近 0。所以差 2 时损失小,差 0 时损失 ln 2,差 −2 时损失大。
怎么算
σ(x) = 1/(1 + e⁻ˣ),所以 −ln σ(x) = ln(1 + e⁻ˣ)。
意思是:sigmoid 把分数差变成「排对的概率」,前面加 −ln,把「概率越大越好」翻成「损失越小越好」。三个关键值要会:差 2 时 0.1269,差 0 时 0.6931,差 −2 时 2.1269。
这个函数在逻辑回归里出现过,那里也是用它输出二分类的概率。
常见误解
以为 σ(0) = 0
σ(0) = 0.5。sigmoid 在 0 处正好居中,输出永远在 0 和 1 之间,碰不到两端。
以为 −ln σ(x) 可以是负数
σ(x) 小于 1,ln 一个小于 1 的数是负的,再加负号就是正的。损失永远大于 0,只会越来越接近 0。
试一下
σ(x) 和 σ(−x) 加起来是多少?
1。sigmoid 关于点 (0, 0.5) 对称,所以「i 排前」和「j 排前」的概率加起来是 1。
5. BPR 损失与代码里的 softplus
它解决什么问题
有了三元组和 sigmoid,还要写出整体的训练目标,课件还给了一段 PyTorch 代码。代码里的写法和公式看着不一样,考试常问两者为什么等价。
直觉
每个三元组贡献一份 −ln σ(差)。排对了、差距拉得大,这份就小;排反了,这份就大。所有三元组加起来,再加一项正则,就是 BPR 损失。
损失只关心两个分数的差,不关心分数本身是多少。这就是「不预测评分,只预测顺序」。
一步一步看
目标:在 u₁ 的 4 个三元组上逐条算损失,看分数差为 0 的那条损失最大,训练会先推它。
沿用 u₁ 的 4 个三元组,设模型当前打分为 ŷ(u₁,i₁) = 0、ŷ(u₁,i₂) = 2、ŷ(u₁,i₃) = 1、ŷ(u₁,i₄) = 1。
-
(u₁, i₂, i₁):差 2,损失 0.1269。
-
(u₁, i₂, i₄):差 1,损失 0.3133。
-
(u₁, i₃, i₁):差 1,损失 0.3133。
-
(u₁, i₃, i₄):差 0,损失 0.6931,最大。合计 1.4466。
训练会推着模型把 i₃ 的分数抬高、把 i₄ 的分数压低,让第 4 条的损失先降下来。
怎么算
Loss = Σ₍ᵤ,ᵢ,ⱼ₎∈O −ln σ(ŷᵤᵢ − ŷᵤⱼ) + λ‖Θ‖₂²
意思是:对每个三元组,看「交互过的 i」比「没交互过的 j」高出多少,高得越多损失越小;所有三元组求和,再加上全部参数 Θ 的 L2 正则。σ 是 sigmoid,Θ 是所有可训练参数。
代码写的是 loss = mean(softplus(neg_scores − pos_scores))。pos_scores 是用户向量和正样本物品向量的内积 ŷᵤᵢ,neg_scores 同理是 ŷᵤⱼ。代入 softplus(x) = ln(1 + eˣ):
softplus(ŷᵤⱼ − ŷᵤᵢ) = ln(1 + e^(−(ŷᵤᵢ − ŷᵤⱼ))) = −ln σ(ŷᵤᵢ − ŷᵤⱼ)
两者完全相等。代码用 mean、公式用 Σ,只差一个常数倍,不影响最优解。代码里的 reg_loss 对应公式里的 λ‖Θ‖² 那一项。
常见误解
以为代码里是 softplus(pos − neg)
是 softplus(neg − pos),负样本分数减正样本分数。写反了就等于鼓励把没交互的物品排前面。
以为 BPR 要求 ŷᵤᵢ 等于 1、ŷᵤⱼ 等于 0
只要求差大。两个分数同时加 100,差不变,损失也不变。
试一下
上面第 4 个三元组,如果训练后 ŷ(u₁,i₃) 变成 3,这一条的损失变成多少?
差变成 3 − 1 = 2,损失 −ln σ(2) ≈ 0.1269。
把它们串起来
上一页的矩阵分解默认有评分。现实里评分少,点击和购买多,可这些隐式数据没有负例、还带噪声,数值是次数而非喜好。直接把没交互的格子当 0,会把「没见过」误当「不喜欢」。
出路是换目标。推荐最终交付的是一份排好序的列表,那就不逐点猜分数,改成成对比较。成对比较的答案只有是或否,可以当二分类做。
BPR 给每个用户配出三元组 (u, i, j):i 交互过,j 没交互过,同类之间不比。每个三元组的损失是 −ln σ(ŷᵤᵢ − ŷᵤⱼ),分数差越大损失越小。代码里的 softplus(neg − pos) 和它完全相等。
学会了排顺序,还得知道排得好不好。评分预测用 MAE、RMSE,排序要换一套指标,下一页讲 NDCG。
课件里的坑
- [适用条件] 代码里 loss = mean(softplus(neg − pos)),看着和公式不像。softplus(x) = ln(1 + eˣ),代入后正好等于 −ln σ(pos − neg),两者等价;mean 和 Σ 只差常数倍(p.42)。
- [课件用词] p.40 标题写的是 Negative Sampling(负采样),但 BPR 并不认定 j 是「不喜欢」,只认定它该排在 i 后面。「负样本」在这里指没交互,不指讨厌(p.40)。
- [读图提醒] BPR 的偏好表行是 j、列是 i,读的时候按列找 i、按行找 j,不要按习惯先行后列读成「行比列好」(p.40)。
- [页码提醒] 课件右下角页脚数字比 PDF 页序小 1,本页的 p.N 都按 PDF 页序。
课后 10 分钟:考点复习
这 10 分钟怎么用:先用英文默写隐式数据三个特征;再读必背 5 条;然后做 3 道课件例题,亲手为 u₁ 画一遍 i >ᵤ j 表;最后做完整例题和变式题,把 −ln σ 算熟。
必背
- 隐式数据三特征:没有负反馈(缺失分不清是不喜欢还是没见过)、天然有噪声、数值是频次而非偏好强弱
- 评分预测是 pointwise;推荐本质是排序,BPR 是 pairwise:交互过的物品应比没交互过的得分高
- BPR 不把「?」当负例:只比较一个交互过、一个没交互过的物品,同类之间不比较
- BPR 损失 Σ −ln σ(ŷᵤᵢ − ŷᵤⱼ) + λ‖Θ‖²,i 来自 R⁺、j 来自 R⁻
- 代码写成 softplus(neg − pos),和 −ln σ(pos − neg) 完全相等;mean 和 Σ 只差常数倍
课件例题
例 1(课件 p.39):把隐式反馈矩阵转成 0/1 矩阵,问题在哪?
题面:5 个用户 × 4 个物品,「+」是有交互,「?」是没观测。u₁ 为 ? + + ?,u₅ 为 ? ? + ?。
提示
想想「?」被记成 0 意味着什么。
解答
- 记 1、? 记 0,u₁ 变成 0 1 1 0,u₅ 变成 0 0 1 0。问题是把「?」当成不喜欢,可它也可能只是没见过。直接拟合这张表,模型会给所有没见过的物品打低分。
例 2(课件 p.40):按 BPR 为 u₁ 构造 i >ᵤ j 表,哪些格子是「+」?
题面:u₁ 交互过 i₂、i₃,没交互过 i₁、i₄。「+」表示更喜欢 i,「−」表示更喜欢 j,「?」表示无法判断。
提示
只有「一个交互过、一个没交互过」的组合才有方向。
解答
i 取 i₂ 或 i₃、j 取 j₁ 或 j₄ 时是「+」,共 4 格;反过来的 4 格是「−」。i₂ 与 i₃ 之间、i₁ 与 i₄ 之间是「?」,对角线灰格。u₁ 贡献 4 个训练三元组,5 个用户合计 19 个。
例 3(课件 p.41–42):BPR 损失怎么写?代码里的 softplus 为什么对得上?
题面:O = {(u, i, j) | (u, i) ∈ R⁺, (u, j) ∈ R⁻};代码 loss = mean(softplus(neg_scores − pos_scores))。
提示
把 softplus(x) = ln(1 + eˣ) 和 −ln σ(x) 都展开。
解答
Loss = Σ₍ᵤ,ᵢ,ⱼ₎∈O −ln σ(ŷᵤᵢ − ŷᵤⱼ) + λ‖Θ‖²。−ln σ(x) = ln(1 + e⁻ˣ),所以 −ln σ(pos − neg) = ln(1 + e^(neg − pos)) = softplus(neg − pos)。代码的 pos_scores、neg_scores 都是用户向量与物品向量的内积。
完整例题
题面(自编情境):某用户的一对物品,ŷᵤᵢ = 2、ŷᵤⱼ = 0。(a) 求单个三元组的 BPR 损失(不计正则)。(b) 两者对调,损失变成多少?(c) 两者相等呢?(d) 用 softplus 写出 (a) 的代码形式。
解法:
- 排对时:差 2,−ln σ(2) = ln(1 + e⁻²) ≈ 0.1269。
- 排反时:差 −2,−ln σ(−2) = ln(1 + e²) ≈ 2.1269,损失大了很多。
- 相等时:差 0,−ln σ(0) = ln 2 ≈ 0.6931。
- 代码形式:softplus(neg − pos) = softplus(0 − 2) = softplus(−2) = ln(1 + e⁻²) ≈ 0.1269,和第 1 步一样。
要点:BPR 只看分数差,差越大损失越接近 0。排对和排反的损失差了一个 2,正好是分数差:ln(1 + e²) − ln(1 + e⁻²) = 2。
答题格式:先写 −ln σ(ŷᵤᵢ − ŷᵤⱼ),再代入差值,最后写成 ln(1 + e^(−差)) 算出数值。
变式题(先自己做)
自编情境:
(a) ŷᵤᵢ = 1、ŷᵤⱼ = 0,求单个三元组的 BPR 损失(不计正则)。 (b) 某用户在 4 个物品里交互过 i₁、i₄,列出 BPR 三元组。 (c) 一共 3 个用户、5 个物品,三人分别交互过 1、2、3 个物品,总共有多少个三元组?
提示
(a) −ln σ(x) = ln(1 + e⁻ˣ)。(b) 交互过的配没交互过的。(c) 每人「交互数 × 未交互数」再相加。
判分点与答案(非官方评分标准)
判分点:① BPR 用分数差;② 三元组不含两个同类物品的组合;③ 计数逐人相乘再相加。
(a) −ln σ(1) = ln(1 + e⁻¹) ≈ 0.3133。
(b) (u, i₁, i₂)、(u, i₁, i₃)、(u, i₄, i₂)、(u, i₄, i₃),共 4 个。
(c) 1 × 4 + 2 × 3 + 3 × 2 = 4 + 6 + 6 = 16 个。
闪卡自测
1. 隐式数据的三个特征是什么?
没有负反馈、天然有噪声、偏好 vs 置信度(数值是频次)(p.36)。
2. 评分预测和 BPR 分别属于哪类方法?
评分预测是 pointwise,BPR 是 pairwise 的排序学习(p.37)。
3. 排序学习为什么可以当成分类问题?
训练数据是偏序或二元判断,每个样本问「i 是否应排在 j 前面」,答案只有是与否(p.38)。
4. BPR 的直觉是什么?
已观测的交互更能反映偏好,应比未观测的得到更高的预测值(p.37、p.41)。
5. 课件 5 用户 × 4 物品的例子能配出几个三元组?
19 个:u₁–u₄ 各 4 个,u₅ 3 个(p.40)。
6. BPR 损失公式里 O、σ、Θ 各是什么?
O 是 (u, i, j) 三元组集合,i 来自已观测交互 R⁺,j 来自未观测 R⁻;σ 是 sigmoid;Θ 是全部可训练参数(p.41)。
7. 代码里的 softplus 和公式怎样对上?
softplus(neg − pos) = ln(1 + e^(neg − pos)) = −ln σ(pos − neg);mean 和 Σ 只差常数倍(p.42)。
下一讲
下一页 L08e 讲怎样评一份排好的列表:NDCG@K。排在前面的高分物品贡献大,越往后打折越多,最后和理想排序比一比,得到 0 到 1 之间的分数。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。