L08c 矩阵分解:把满是问号的评分表拆成两张小表
从向量内积讲起:矩阵分解怎样给每个用户、每部电影各学一个短向量,用内积填评分表里的问号;为什么损失只在已观测格子上算;偏置和正则项各管什么;MAE 和 RMSE 怎么算、差在哪里。
一句话版
评分表里大多数格子是问号。矩阵分解给每个用户、每部电影各学一个很短的数字向量,用户向量和电影向量做内积,得到的数就填进那个问号。
训练时只拿已经有评分的格子对答案。再给每个人、每部电影各加一个偏置,最后用 MAE 和 RMSE 检查填得准不准。上一页 L08b 讲了评分表从哪来,这一页讲怎么填。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 向量 | vector | 一串排好顺序的数,例如 (1, 2) |
| 内积 | inner product / dot product | 两个向量对应位置相乘,再全部加起来 |
| 矩阵分解 | matrix factorization,MF | 把一张大表近似成两张小表相乘 |
| 隐因子 | latent factor | 向量里的每一维,可以想成一种说不出名字的口味 |
| 偏置 | bias | 每个用户、每个物品各自带的一个加减常数 |
| 正则化 | regularization | 在损失里加一项,罚参数太大,防过拟合 |
| MAE / RMSE | 平均绝对误差 / 均方根误差 | 两种「预测分和真实分差多少」的量法 |
一个类比:给人和电影各贴几张标签
假设每个人的口味只用两个数描述:多喜欢动作片、多喜欢爱情片。每部电影也用两个数描述:动作成分多少、爱情成分多少。
一个人对一部电影会打几分?把「爱动作 × 动作成分」和「爱爱情 × 爱情成分」加起来就行。口味对得上的维度多,分数就高。这就是内积。
矩阵分解做的事,是从已有的评分里反推出每个人、每部电影的这几个数。推出来之后,没看过的电影也能算出一个分。
类比在哪里失效:
- 类比里的维度有名字。矩阵分解学出来的维度通常没有名字,它只是让分数对得上的几个数。
- 类比里标签是人先定好的。矩阵分解里两组数都是从评分里一起学出来的,事先谁也不知道。
从零讲起
1. 向量内积(补充)
它解决什么问题
矩阵分解的每个预测分都是一次内积。内积没算熟,后面的公式都看不懂,所以先单独练一下。
直觉
内积量的是两个向量「方向对不对得上」。两边在同一维上都大,乘出来就大;一边大一边是 0,这一维就不贡献分数。
一步一步看
目标:拿两个二维向量对位相乘再相加,看内积怎样算出一个预测分。
-
写出两个等长的向量:用户 p = (1, 2),物品 q = (2, 0.5)。
-
对应位置相乘:第 1 维 1 × 2 = 2,第 2 维 2 × 0.5 = 1。
-
把乘积全部加起来:2 + 1 = 3。
怎么算
公式写成 pᵀq = Σₖ pₖ qₖ,k 从 1 到 d。
意思是:两个向量各有 d 个数,第 k 个和第 k 个相乘,d 个乘积加起来,结果是一个数。
两个向量长度必须一样,不然有的位置找不到配对。
常见误解
以为内积的结果还是一个向量
逐位相乘那一步得到的是向量,但内积还要把它们加起来,最后只剩一个数。预测分就是这个数。
以为 pᵀq 和 pqᵀ 是一回事
pᵀq 是行乘列,得一个数。pqᵀ 是列乘行,得一张 d × d 的表。课件的预测式都是前者。
试一下
p = (3, 1),q = (1, 4),内积是多少?
3 × 1 + 1 × 4 = 3 + 4 = 7。
2. 矩阵分解:R ≈ P × Qᵀ
它解决什么问题
评分矩阵 R 有 n 个用户、m 个物品,大多数格子是问号。逐格去猜太散,也没法利用格子之间的联系。矩阵分解把整张表压成两张小表,问号就能从小表里算出来。
从哪来(补充)
这类方法在 Netflix Prize 期间广为人知。Simon Funk 在 2006 年写了一篇博客,报告了把评分矩阵分解成两个低维矩阵相乘的效果,这种做法后来叫 Funk MF。课件的例子出自 Koren、Bell、Volinsky 2009 年的论文《Matrix factorization techniques for recommender systems》。
出处:Wikipedia: Matrix factorization (recommender systems)
直觉
每个用户一行,是一个 d 维向量;每个物品一列,也是一个 d 维向量。用户 i 对物品 j 的预测分,就是第 i 行和第 j 列的内积。
d 要很小。小了才逼着模型去找少数几条共同规律,而不是一格一格死记。
一步一步看
目标:把评分表拆成 P 乘 Qᵀ,看每个问号怎样由用户那一行和电影那一列的内积填上。
下面的数是自拟的,为了好算都取整数。
-
起点是一张 3 个用户 × 4 部电影的评分表,有 3 格是问号。
-
把 R 拆成 P(3 行 2 列)乘 Qᵀ(2 行 4 列),中间那一维 d = 2。
-
填 A 对电影4:取 P 的 A 行 (2, 1),取 Qᵀ 的电影4 列 (1, 2),内积 2 × 1 + 1 × 2 = 4。
-
每个问号都这样算,表就补全了。B 对电影1 是 2,C 对电影3 是 3。
这个例子里 P 和 Q 正好把已知格子一个不差地还原了。真实训练出来的 P、Q 只能让已知格子尽量接近,数也不会这么整。
怎么算
课件的写法:
- 用户表示 P ∈ ℝ^(n×d),第 i 行记作 pᵢᵀ
- 物品表示 Qᵀ ∈ ℝ^(d×m),第 j 列记作 qⱼ
- R ≈ R̂ = P × Qᵀ
- r̂ᵢⱼ = pᵢᵀqⱼ = Σₖ₌₁ᵈ pᵢₖ qⱼₖ
- 要求 d ≪ min(n, m)
意思是:预测表 R̂ 里第 i 行第 j 列那一格,等于用户 i 的向量和物品 j 的向量做内积。d 是隐因子的个数,远小于用户数和物品数。
d 小有两个好处。第一是省参数:设 n = 1000、m = 500、d = 10,R 有 500,000 格,P 和 Q 合计只有 1000 × 10 + 500 × 10 = 15,000 个参数。第二是逼模型找共同规律,比如「动作片偏好」这类口味维度。学出来的维度未必有名字。
注意 Q 本身的形状是 m × d,转置之后 Qᵀ 才是 d × m。
常见误解
以为 d 越大越好
d 越大,P 和 Q 越能把已知格子拟合得严丝合缝,但也越容易死记,失去推广能力。课件要求 d 远小于 n 和 m。
以为学出来的维度一定对应「动作」「爱情」这类类型
这只是帮助理解的解释。模型只管让分数对得上,学出来的维度可能是好几种因素混在一起。
试一下
沿用上面的 P 和 Qᵀ,B 对电影3 的预测分是多少?和表里已知的 4 对得上吗?
B 行 (1, 2),电影3 列 (2, 1)。1 × 2 + 2 × 1 = 4,和已知的 4 一样。
3. 训练目标:只在已观测格子上算误差
它解决什么问题
P 和 Q 里的数要学出来。学就要有一个「错了多少」的量,再去把它压小。问题是表里大多数格子没有答案,该拿什么对答案?
直觉
只拿有答案的格子对答案。这些格子构成集合 S。问号格子是「不知道」,不是「不喜欢」,不能当 0 分去拟合。
如果把问号当 0,模型会学成「没看过就打 0 分」,那所有没看过的电影都会排到最后,推荐也就失去了意义。
一步一步看
目标:只在有评分的格子上算误差平方再加总,看问号格子为什么不进损失。
-
把表里有评分的格子圈出来,它们就是 S。上一节的例子里 S 有 9 格,问号有 3 格。
-
对 S 里的每一格,用当前的 P、Q 算出预测分 r̂ᵢⱼ。
-
算这一格的误差平方:真实 5、预测 3,贡献 (5 − 3)² = 4。
-
把 S 里所有格子的贡献加起来,这就是要最小化的损失。问号格子不加。
怎么算
min over P, Q:Σ₍ᵢ,ⱼ₎∈S (rᵢⱼ − pᵢᵀqⱼ)²
意思是:在所有有评分的格子上,把「真实分减预测分」的平方加起来,调整 P 和 Q 让这个和最小。rᵢⱼ 是观测到的真实评分,r̂ᵢⱼ = pᵢᵀqⱼ 是预测评分。
这和线性回归的平方损失是同一个形式。区别在于这里两个因子 P、Q 都是要学的参数。
课件还提到 SVD(奇异值分解):任意矩阵 M 可以写成 U × Σ × Vᵀ,只保留最大的几个奇异值就能近似原矩阵。但经典 SVD 要求每个格子都有值,评分矩阵大多是问号,所以推荐里实际用的是上面这种只在 S 上拟合的做法。
常见误解
以为损失要对整张表 n × m 个格子求和
只对 S 求和。课件里黄色格子就是 S,问号格子不进损失。
以为推荐里的矩阵分解就是线性代数课上的 SVD
形状关系一样,都是把大表拆成小表相乘。但经典 SVD 要求表是满的,评分表做不到,所以要换成只拟合已观测格的版本。
试一下
S 里有两格:真实 4、预测 3;真实 2、预测 4。损失是多少?
(4 − 3)² + (2 − 4)² = 1 + 4 = 5。
4. 偏置与正则化
它解决什么问题
有的人什么电影都打高分,有的电影因为质量差谁都打低分。只用内积描述「口味对不对得上」,描述不了这种整体偏高偏低。另外参数一多就容易过拟合。偏置管前一个问题,正则管后一个。
直觉
偏置是加在内积后面的常数。一个人爱打高分,他的偏置就是正的,所有预测分都往上推一点。一部电影口碑差,它的偏置就是负的,所有人对它的预测分都往下拉一点。
正则项是在损失里多罚一笔:参数越大罚得越多。模型想把某个数调得很大去硬凑一两个格子,就得付出代价。
一步一步看
目标:在内积 3 上依次加用户偏置和物品偏置,看预测分怎样被调到 3.2。
-
先算内积:沿用 p = (1, 2)、q = (2, 0.5),内积是 3。
-
加用户偏置:这个人爱打高分,bᵢᵖ = 0.5,变成 3.5。
-
加物品偏置:这部电影口碑偏低,bⱼᵠ = −0.3,变成 3.2。
怎么算
带偏置的预测式(正确写法):
r̂ᵢⱼ = pᵢᵀqⱼ + bᵢᵖ + bⱼᵠ
加正则的目标函数:
Σ₍ᵢ,ⱼ₎∈S (rᵢⱼ − r̂ᵢⱼ)² + λ Σᵢ Σⱼ ( ‖pᵢ‖² + ‖qⱼ‖² + ‖bᵢᵖ‖² + ‖bⱼᵠ‖² )
意思是:预测分等于内积加两个偏置。损失由两部分组成,前面是已观测格子上的误差平方和,后面是所有参数的平方和乘上 λ。λ 是正则化系数,越大越罚参数大。
偏置也是要学的参数,所以 min 下面应写 P、Q、bᵖ、bᵠ 四组。
常见误解
以为偏置要和向量相乘
偏置是直接加在内积上的常数,不参与相乘。
以为课件的等式链 r̂ᵢⱼ = pᵢᵀqⱼ = Σ pᵢₖqⱼₖ + bᵢᵖ + bⱼᵠ 是对的
中间那个等号不成立。pᵢᵀqⱼ 只等于那个求和,加了偏置后就不等了。答题写 r̂ᵢⱼ = pᵢᵀqⱼ + bᵢᵖ + bⱼᵠ。
试一下
内积 4,用户偏置 −0.5,物品偏置 0.8,预测分是多少?
4 − 0.5 + 0.8 = 4.3。
5. 评估:MAE 与 RMSE
它解决什么问题
模型训练完,要拿没见过的测试数据检查它填得准不准。需要一个数来概括「预测分和真实分平均差多少」。课件给了两个:MAE 和 RMSE。
从哪来(补充)
Netflix Prize 就按 RMSE 评判。Netflix 自己的 Cinematch 算法在测试集上 RMSE 是 0.9525,拿大奖要再提升 10%,做到 0.8572。获胜队伍的成绩是 0.8567。
直觉
MAE 是误差的平均大小,每条误差一视同仁。RMSE 先把误差平方,大误差会被放大,再平均、开根号。一条错得离谱的预测,对 RMSE 的拖累比对 MAE 大得多。
一步一步看
目标:用同样三条测试记录分别算 MAE 和 RMSE,看先取绝对值和先平方两种算法结果差在哪。
-
三条测试记录,真实评分 (5, 3, 4),预测 (4, 3, 2)。
-
误差绝对值:1、0、2。
-
MAE:三个绝对值的平均,(1 + 0 + 2)/3 = 1。
-
RMSE:先平方得 1、0、4,平均 5/3,再开根号 √(5/3) ≈ 1.291。
怎么算
都在测试集 D_test 上算,每条记录是三元组 (u, i, r),r 是真实评分:
- MAE = (1/|D_test|) Σ |r − r̂ᵤ,ᵢ|
- RMSE = √[ (1/|D_test|) Σ (r − r̂ᵤ,ᵢ)² ]
意思是:MAE 把每条误差取绝对值再平均;RMSE 把每条误差平方再平均,最后对整个平均开根号。根号盖住整个平均,不是每条单独开根号。
RMSE ≥ MAE 恒成立。只有每条误差的绝对值都一样时,两者才相等。两个指标都是越小越好。
常见误解
以为 RMSE 可能比 MAE 小
不会。RMSE 永远不小于 MAE,误差绝对值全相同时才相等。
以为 RMSE 的根号是对每条误差分别开
根号盖住整个平均。每条分别开根号再平均,就退化回 MAE 了。
试一下
两条记录,误差绝对值都是 2。MAE 和 RMSE 各是多少?
MAE = (2 + 2)/2 = 2;RMSE = √((4 + 4)/2) = √4 = 2。误差全相同,两者相等。
把它们串起来
评分表大多数格子是问号。矩阵分解给每个用户、每个物品各学一个 d 维向量,用户和物品的内积就是预测分,d 远小于用户数和物品数。
学这些向量时,只拿有评分的格子对答案,损失是这些格子上误差平方的和。问号不当 0 分。
只靠内积,描述不了「有人爱打高分」「有片口碑差」,于是给每个用户、每个物品各加一个偏置。参数多了容易过拟合,于是在损失里加 λ 乘参数平方和。
训练完在测试集上算 MAE 和 RMSE。RMSE 对大误差更敏感,Netflix Prize 就按它排名。
这一整套都建立在「有评分」上。现实里多数数据只有点击和购买,下一页就讲这种情况怎么办。
课件里的坑
- ⚠️ 课件有误:带偏置的预测式印成 r̂ᵢⱼ = pᵢᵀqⱼ = Σ pᵢₖqⱼₖ + bᵢᵖ + bⱼᵠ。pᵢᵀqⱼ 本身只等于那个求和,加偏置后中间的等号不成立,应写 r̂ᵢⱼ = pᵢᵀqⱼ + bᵢᵖ + bⱼᵠ(p.35)。
- ⚠️ 课件有误:同页目标函数写成「min Σ(r − r̂)² = Σ(r − r̂)² + λ(…)」,左边没有正则项、右边有,不可能相等。意思是目标函数改成右边整式,而且 min 下面也应包括两组偏置(p.35)。
- [适用条件] 正则项写成 Σᵢ Σⱼ 对全部 n × m 组合求和时,每个 ‖pᵢ‖² 会被重复加 m 次,等于把正则系数放大了若干倍,不影响「惩罚过大参数」的作用。答题照课件写即可(p.35)。
- [记号提醒] p.31 写的是 Qᵀ ∈ ℝ^(d×m),p.32 写的是 Q ∈ ℝ^(m×d),两页说的是同一个东西,一个转置了一个没转。
- [课件留白] SVD 页说「例子中保留前两列」,但课件没给这个例子的数值。经典 SVD 要求矩阵没有空格,评分矩阵大多是问号,实际用的是只拟合已观测格的矩阵分解(p.33)。
- [页码提醒] 课件右下角页脚数字比 PDF 页序小 1,本页的 p.N 都按 PDF 页序。
课后 10 分钟:考点复习
这 10 分钟怎么用:先默写 r̂ᵢⱼ = pᵢᵀqⱼ + bᵢᵖ + bⱼᵠ 和 MAE、RMSE 两个公式;再读必背 5 条;然后做 4 道课件例题;最后做完整例题和变式题,把内积、偏置、MAE、RMSE 各算一遍。
必背
- 矩阵分解 R ≈ P × Qᵀ,r̂ᵢⱼ = pᵢᵀqⱼ,d ≪ min(n, m)
- 损失只在已观测集合 S 上求平方误差,问号格子不是 0 分
- 偏置项 bᵢᵖ、bⱼᵠ 刻画用户打分习惯和物品整体口碑;正确写法 r̂ᵢⱼ = pᵢᵀqⱼ + bᵢᵖ + bⱼᵠ
- λ 是正则化系数,惩罚过大的参数,防止过拟合
- MAE 是误差绝对值的平均,RMSE 是平方误差平均再开根号,对大误差罚得更重;RMSE ≥ MAE,两者都越小越好
课件例题
例 1(课件 p.31–32):David 对 Toy Story 的预测分怎么算?训练时损失怎么写?
题面:R ≈ P × Qᵀ,P ∈ ℝ^(n×d),Q ∈ ℝ^(m×d),黄色格子构成集合 S。
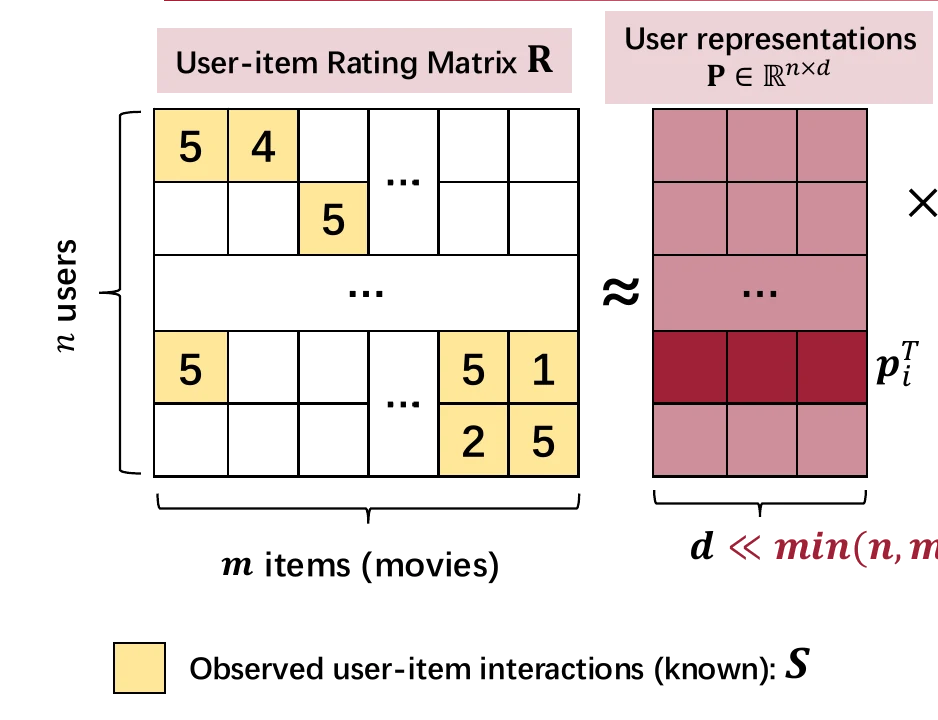
提示
取 P 里 David 那一行、Q 里 Toy Story 那一行。
解答
r̂ = p_Davidᵀ q_ToyStory = Σₖ p_David,k q_ToyStory,k,共 d 项相乘再相加。损失是 Σ₍ᵢ,ⱼ₎∈S (rᵢⱼ − pᵢᵀqⱼ)²,只对已观测的黄色格子求和,问号格子不进损失。
例 2(课件 p.33):评分矩阵为什么不能直接用经典 SVD?
题面:SVD 把任意矩阵 M 分解成 U × Σ × Vᵀ,保留最大的几个奇异值来近似。
提示
想想经典 SVD 对矩阵有什么要求。
解答
经典 SVD 要求每个格子都有值,评分矩阵大部分是问号。所以推荐里用的是只在已观测格子上拟合的矩阵分解。这层区分是补充说明,课件没明说。
例 3(课件 p.34):MAE 和 RMSE 的公式分别是什么?
题面:在测试集 D_test 上,每条记录是 (u, i, r)。
提示
RMSE 的根号盖住整个平均。
解答
MAE = (1/|D_test|) Σ |r − r̂ᵤ,ᵢ|;RMSE = √[(1/|D_test|) Σ (r − r̂ᵤ,ᵢ)²]。两者都越小越好,RMSE 先平方,对大误差更敏感。
例 4(课件 p.35):为什么要加偏置项和正则项?
题面:有的用户总打高分,有的物品总被打低分;λ 是正则化系数。
提示
内积只描述「口味对不对得上」,描述不了打分习惯。
解答
用户偏置 bᵢᵖ 吸收某人整体偏高或偏低的打分习惯,物品偏置 bⱼᵠ 吸收某物品整体口碑。正则项 λ(‖pᵢ‖² + ‖qⱼ‖² + ‖bᵢᵖ‖² + ‖bⱼᵠ‖²) 惩罚过大的参数,防止过拟合。正确的预测式是 r̂ᵢⱼ = pᵢᵀqⱼ + bᵢᵖ + bⱼᵠ。
完整例题
题面(自编情境):d = 2,某用户向量 (1, 2),某电影向量 (2, 0.5)。(a) 求不带偏置的预测分。(b) 用户偏置 0.5、电影偏置 −0.3,求带偏置的预测分。(c) 另一组测试,真实评分 (5, 3, 4),预测 (4, 3, 2),求 MAE 和 RMSE。
解法:
- 内积:1 × 2 + 2 × 0.5 = 2 + 1 = 3。
- 加偏置:3 + 0.5 − 0.3 = 3.2。
- 误差:|5 − 4| = 1,|3 − 3| = 0,|4 − 2| = 2。
- MAE = (1 + 0 + 2)/3 = 1。
- RMSE = √[(1 + 0 + 4)/3] = √(5/3) ≈ 1.291。
要点:偏置是直接加在内积上的常数,不参与向量相乘。RMSE 比 MAE 大,是那条误差 2 被平方放大了。
答题格式:写出公式、代入式、结果三步;RMSE 先写根号内的平均,再开根号。
变式题(先自己做)
自编情境:
(a) d = 3,用户向量 (1, 0, 2),物品向量 (3, 1, 0.5),求预测分;再加用户偏置 0.2、物品偏置 −0.5。 (b) 测试集真实评分 (4, 2, 5, 3),预测 (4.5, 3, 4.5, 1),求 MAE 和 RMSE。
提示
(a) 三项逐位相乘再相加。(b) 先列四个误差绝对值,RMSE 用它们的平方。
判分点与答案(非官方评分标准)
判分点:① 内积逐位相乘;② 偏置直接相加;③ RMSE 是平均之后再开根号。
(a) 1 × 3 + 0 × 1 + 2 × 0.5 = 4;加偏置 4 + 0.2 − 0.5 = 3.7。
(b) 误差绝对值 (0.5, 1, 0.5, 2)。MAE = 4/4 = 1;RMSE = √[(0.25 + 1 + 0.25 + 4)/4] = √1.375 ≈ 1.173。
闪卡自测
1. 矩阵分解的预测式和维度要求是什么?
r̂ᵢⱼ = pᵢᵀqⱼ = Σ pᵢₖqⱼₖ,d ≪ min(n, m)(p.31)。
2. d 远小于 n 和 m 有什么意义?
一是压缩参数;二是逼模型找出少数几个共同的口味规律,而不是逐格死记(p.31)。
3. MF 的训练目标在哪些格子上求和?
只在已观测集合 S 上,问号格子不进损失(p.32)。
4. 经典 SVD 为什么不能直接用在评分矩阵上?
经典 SVD 要求每个格子都有值,评分矩阵大部分是问号(p.33)。
5. MAE 和 RMSE 哪个对大误差更敏感?
RMSE,它先平方再平均(p.34)。
6. 偏置项解决什么问题?λ 起什么作用?
偏置刻画用户打分习惯和物品整体口碑;λ 是正则化系数,防止过拟合(p.35)。
下一讲
下一页 L08d 讲隐式反馈:多数数据只有点击和购买,没有评分,也没有「不喜欢」。推荐于是从「预测分数」改成「排对顺序」,这就是 BPR。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。