L04b-1 假设函数与代价函数:先学会给一条直线打分
从截距和斜率讲起,写出线性回归的假设函数,再用三个点一帧一帧算出代价函数 J,看清它为什么是一只碗。
一句话版
线性回归要找一条直线去贴数据。这一页先解决「怎么给一条直线打分」:把每个点的预测和真实值相减、平方、加起来,分数越低,直线越贴。
读之前最好先懂特征 x、标签 y、回归是什么,见 L04a-1。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| θ₀, θ₁ | 读「西塔零」「西塔一」,参数 | 直线的截距和斜率,也就是要学的两个旋钮 |
| h_θ(x) | hypothesis,假设函数 | 用当前参数算出的预测值,这里就是那条直线 |
| m | 训练样本数 | 一共有几个训练样本 |
| x⁽ⁱ⁾, y⁽ⁱ⁾ | 读「x 上标 i」 | 第 i 个样本的特征和标签;上标是编号,不是幂次 |
| Σ | 读「西格玛」,求和 | 把后面那一项对所有样本加起来 |
| J(θ) | cost function,代价函数 | 给一组参数打的「误差分」,越小越好 |
一个类比:射箭比赛怎么计分
射箭比赛不看你某一箭射得多准,看所有箭离靶心的总距离。离得越远扣分越多,最后分数最少的人赢。
给直线打分是同一个思路。每个训练点是一支箭,直线在这个点上的预测值是箭的落点,真实价格是靶心。落点离靶心的距离就是误差。把所有箭的误差平方后加起来,就是这条直线的总分。
为什么要平方?有两个原因。一是误差有正有负,直接相加会互相抵消,平方之后全是正数。二是平方让偏得远的点扣分更重:差 1 扣 1 分,差 3 扣 9 分。
类比在哪里失效:
- 射箭是人在射,每一箭都可以重来。线性回归里数据是固定的,能调的只有直线本身,也就是两个参数。
- 射箭比赛只比一次分数。这里我们要把很多条候选直线的分数都算出来,连成一条曲线,再去找最低点。这条曲线就是后面说的「碗」。
从零讲起
1. 先补一块:直线的截距和斜率(补充)
它解决什么问题
线性回归的模型就是一条直线。要读懂它的公式,先得知道一条直线由哪两个数决定,每个数改了以后直线怎么动。
直觉
把一根筷子斜靠在墙上。筷子底端碰墙的高度,就是截距:x 等于 0 时直线有多高。筷子的倾斜程度,就是斜率:x 每往右走 1 步,直线往上升多少。
截距变大,整根筷子平着往上抬;斜率变大,筷子变得更陡。两个数各管一件事,互不干扰。
一步一步看
目标:在 y = 1 + 0.5x 上沿 x 走几步,再分别改截距和斜率,看两个数各让直线怎样动。
拿直线 y = 1 + 0.5x 来看,截距是 1,斜率是 0.5。
-
x = 0 时,y = 1。这就是截距:直线和纵轴的交点。
-
x 从 0 走到 1,y 从 1 变成 1.5,升了 0.5。
-
x 再走到 2,y 变成 2,又升了 0.5。每走一步都升同样多,这就是斜率。
-
把截距改成 2、斜率不动,每一行的 y 都多 1,直线整体上移。
x y = 1 + 0.5x y = 2 + 0.5x 0 1 2 1 1.5 2.5 2 2 3 3 2.5 3.5 -
斜率改成 0,直线就是一条水平线,x 怎么变 y 都不动。
怎么算
直线一般写成 y = 截距 + 斜率 × x。
意思是:先站在截距那个高度,然后 x 每多 1,就往上加一份斜率。斜率是负数时,x 越大 y 越小,直线往右下方走。
常见误解
以为截距和斜率改哪个都差不多
两者的效果完全不同。截距只把直线上下平移,倾斜程度不变;斜率只改倾斜程度,直线和纵轴的交点不动。看图时先找直线和纵轴的交点读截距,再数 x 走一格 y 升几格读斜率。
试一下
直线 y = 3 − 2x 的截距和斜率各是多少?x = 2 时 y 是多少?
截距 3,斜率 −2。x = 2 时 y = 3 − 4 = −1。斜率是负的,所以直线往右下方走。
2. 假设函数与记号
它解决什么问题
我们想用房子面积预测房价。先得定一个形状去贴数据,最简单的形状就是直线。假设函数就是这条直线的正式写法,它把「预测」变成一个能算的公式。
从哪来(补充)
「回归」这个词来自 19 世纪的 Francis Galton。他研究身高遗传,发现高个子祖先的后代,身高往往往平均值回落。他把这个现象叫作回归,后来这个词被借去指所有「从数据里拟合出一条关系」的方法。
出处:Wikipedia: Regression analysis
直觉
把上一个概念里的截距和斜率换成两个符号 θ₀ 和 θ₁,直线就写成 h_θ(x) = θ₀ + θ₁x。这里的 θ₀ 和 θ₁ 是待定的,训练的目标就是找出最好的一组。
h 来自英文 hypothesis,意思是「假设」:我们先假设数据大致沿一条直线分布,再去找具体是哪条。
一步一步看
目标:把房价表写成带上标的训练样本,再用一组随手取的参数预测第一套房,看预测和真实价差了多少。
课件的房价表有两列,面积 x(平方英尺)和价格 y(千美元)。
-
把每一行当成一个训练样本。前四行是 (2104, 460)、(1416, 232)、(1534, 315)、(852, 178)。
编号 i 面积 x⁽ⁱ⁾ 价格 y⁽ⁱ⁾ 1 2104 460 2 1416 232 3 1534 315 4 852 178 -
用上标给样本编号:x⁽¹⁾ = 2104,y⁽¹⁾ = 460,x⁽²⁾ = 1416。
-
随便取一组参数,比如 θ₀ = 50、θ₁ = 0.06,假设函数就是 h(x) = 50 + 0.06x。
-
代入第一套房:h(2104) = 50 + 0.06 × 2104 ≈ 176。
-
真实价格是 460,预测差了约 284,说明这组参数不好,需要一个办法来衡量「多不好」。
怎么算
h_θ(x) = θ₀ + θ₁x
意思是:给定一组参数 θ₀、θ₁,任意输入一个面积 x,就能算出一个预测价格。θ₀ 管直线的高低,θ₁ 管直线的倾斜,换一组参数就是换一条直线。
常见误解
把 x⁽ⁱ⁾ 的上标当成幂次
上标带括号,是样本编号:x⁽²⁾ 是第 2 套房的面积,不是 x 的平方。真正的幂次出现在后面讲过拟合时的 x²、x³,那是不带括号的普通上标。
以为 h 和 J 都是 x 的函数
h 的输入是 x,参数固定;下一个概念里的 J 输入是参数,数据固定。一个是「拿这条线做预测」,一个是「给这条线打分」。
试一下
参数是 θ₀ = 50、θ₁ = 0.06 时,面积 852 的房子预测价是多少?离真实价格 178 差多少?
h(852) = 50 + 0.06 × 852 ≈ 101.1,比 178 低了约 77。
3. 代价函数
它解决什么问题
候选直线有无数条。想比较两条直线哪条更好,需要把「贴不贴数据」压成一个数。代价函数 J 就是这个数,越小说明直线越贴。
从哪来(补充)
把误差平方后加起来、取最小,这个方法叫最小二乘法。Legendre 在 1805 年最早把它清楚地发表出来。Gauss 在 1809 年发表了用它计算天体轨道的方法,并说自己 1795 年起就在用。这套方法当年被用来预测新发现的小行星谷神星会出现在哪里。
直觉
固定一条直线,对每个训练点做三件事:算预测值,减去真实值,平方。三件事做完,把所有点的结果加起来,再除以 2m。
除以 m 是取平均,这样样本多少不影响分数的尺度。多出来的那个 2,是为了后面求导时和平方的 2 约掉,算起来干净,不影响最低点在哪。
一步一步看
目标:在三个点上逐个累加误差平方再除以 2m,看 J(0.5) 怎样算到约 0.58,以及哪个点贡献最大。
用课件的迷你例子:三个点 (1,1)、(2,2)、(3,3),θ₀ 固定为 0,只看 θ₁ = 0.5 这条线 h(x) = 0.5x。每一帧里,青绿的竖虚线是当前这个点的误差。
-
先画出直线和三个点,还没开始算,累计平方和是 0。
-
第 1 个点 (1,1):预测 0.5,误差 0.5 − 1 = −0.5,平方 0.25。累计 0.25。
-
第 2 个点 (2,2):预测 1,误差 −1,平方 1。累计 1.25。
-
第 3 个点 (3,3):预测 1.5,误差 −1.5,平方 2.25。累计 3.5。
-
最后除以 2m。m = 3,所以除以 6,J(0.5) = 3.5 ÷ 6 ≈ 0.58。
离直线越远的点,竖线越长,平方后在总分里占的份量越大。第 3 个点一个就贡献了 2.25,比前两个加起来还多。
怎么算
J(θ₀, θ₁) = (1/2m) Σ_{i=1}^{m} (h_θ(x⁽ⁱ⁾) − y⁽ⁱ⁾)²
意思是:对第 1 个到第 m 个样本,每个都算「预测减真实」,平方掉正负号,全部加起来,最后乘 1/2m。课件把它叫作平方误差函数。训练的目标是找到让 J 最小的 θ₀、θ₁。
常见误解
以为系数是 1/m,1/2 可有可无所以随便写
课件的写法是 1/2m,考试照这个写。乘一个常数不改变最低点的位置,所以 1/2 不影响找到的参数,但写错公式会扣分。它的作用是求导时把平方带下来的 2 约掉。
把「预测减真实」写反成「真实减预测」
平方之后两种写法结果一样,所以 J 的值不受影响。但到了求导那一步,符号会影响更新式的样子,课件统一用预测减真实,跟着写最安全。
试一下
同样三个点,θ₀ = 0、θ₁ = 1.5,J 是多少?
预测 1.5、3、4.5,误差 0.5、1、1.5,平方 0.25、1、2.25,加起来 3.5,除以 6 约 0.58。和 θ₁ = 0.5 一样,因为两条线离 y = x 一样远,只是一条在上一条在下。
4. J 是一只碗
它解决什么问题
上一个概念只给一条直线打了分。我们要的是所有候选直线里分数最低的那条。把每个 θ₁ 的分数都算出来、连成曲线,就能一眼看出最低点在哪。
直觉
想象左右两张图并排。左图横轴是 x,画的是数据和直线;右图横轴是 θ₁,画的是分数 J。左图每换一条直线,右图就多一个点。
θ₁ 离 1 越远,直线离三个点越远,分数越高;θ₁ 正好等于 1,直线穿过所有点,分数是 0。这些点连起来,中间低、两边高,就是一只碗。
一步一步看
目标:把五个 θ₁ 的 J 算出来连成曲线,看代价函数怎样左右对称地围成一只碗,碗底落在 θ₁ = 1。
-
算出五个 θ₁ 的分数,列成表:
θ₁ 三个误差 平方和 J(θ₁) 0 −1, −2, −3 14 2.33 0.5 −0.5, −1, −1.5 3.5 0.58 1 0, 0, 0 0 0 1.5 0.5, 1, 1.5 3.5 0.58 2 1, 2, 3 14 2.33 -
表左右对称:θ₁ = 0 和 2 分数相同,0.5 和 1.5 分数相同,因为它们离 1 一样远。
-
把这些点画到以 θ₁ 为横轴的图上,连成曲线。
-
碗底在 θ₁ = 1、J = 0,对应左图那条穿过全部三个点的直线。
怎么算
三个点都满足 y = x,所以第 i 个点的误差是 θ₁x⁽ⁱ⁾ − x⁽ⁱ⁾ = (θ₁ − 1)x⁽ⁱ⁾,平方和是 (θ₁ − 1)² × (1 + 4 + 9)。
J(θ₁) = (1/6) × 14 × (θ₁ − 1)² = (14/6)(θ₁ − 1)²
意思是:J 是 θ₁ 的一条开口向上的抛物线,最低点在 θ₁ = 1。代回 θ₁ = 0.5,得 (14/6) × 0.25 ≈ 0.58,和逐点算的一样。两个参数都放开时,J 变成一张三维曲面,形状仍是碗,仍然只有一个最低点。
常见误解
把左右两张图的横轴当成同一个东西
左图横轴是 x,固定一组 θ 画出一整条线。右图横轴是 θ₁,每个 θ₁ 只对应一个 J 值。左图的一整条线,在右图里压缩成一个点。
以为碗底的 J 一定等于 0
这个例子里三个点正好在一条直线上,所以碗底是 0。真实房价不会排成一条直线,碗底的 J 会大于 0,它只是所有直线里最小的那个分数。
试一下
用通式算 J(3)。它比 J(2) 大还是小?
J(3) = (14/6) × 4 ≈ 9.33,比 J(2) ≈ 2.33 大得多。离碗底越远,碗壁越陡,分数涨得越快。
把它们串起来
这一页搭好了线性回归的前两块零件。
第一块是模型:h_θ(x) = θ₀ + θ₁x,一条直线,两个旋钮。截距管高低,斜率管倾斜。
第二块是评分:J 把每个样本的预测误差平方后加起来,再除以 2m。J 的输入是参数,所以它回答的是「这组参数有多糟」。
把所有参数的分数连起来,得到一只碗。线性回归的碗只有一个底,找到碗底就找到了最好的直线。三点例子里碗底一眼能看出来,参数一多、数据一大就看不出来了。下一页讲怎么一步步走到碗底:梯度下降。
课件里的坑
- [课件留白] p.13 左图 θ₁ = 0 的标签印在一条斜线旁边,θ₁ = 0 对应的应是贴着横轴的水平线,按公式理解(p.13)
- [记号] p.9 的代价函数系数是 1/2m,后面求导后的更新式系数变成 1/m,两处别混(p.9、p.23)
- [课件留白] p.15 右边的三维曲面没有标出 θ₀ = 50、θ₁ = 0.06 在哪,只能定性判断它离碗底较远(p.15)
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先默写假设函数和代价函数;再拿三个点 (1,1)、(2,2)、(3,3) 自己算一遍 J(0.5),写出每个点的误差和平方;最后做变式题,确认自己分得清 h 和 J 的输入。
必背
- 单变量线性回归的假设函数 h_θ(x) = θ₀ + θ₁x:θ₀ 是截距,管上下平移;θ₁ 是斜率,管倾斜
- x⁽ⁱ⁾ 的上标是第 i 个样本的编号,不是幂次;m 是训练样本个数
- 代价函数 J(θ₀, θ₁) = (1/2m) Σ_{i=1}^{m} (h_θ(x⁽ⁱ⁾) − y⁽ⁱ⁾)²,求和遍历全部样本,预测减真实再平方,系数是 1/2m 而非 1/m
- 三点例题 (1,1)(2,2)(3,3) 且 θ₀ = 0:J(1) = 0,J(0.5) = 3.5/6 ≈ 0.58;h 是 x 的函数、J 是 θ 的函数,左图一条线对应右图一个点
- 线性回归的 J 画出来是一只碗(凸函数),只有一个最低点;三点例子里 J(θ₁) = (14/6)(θ₁ − 1)²,碗底在 θ₁ = 1
课件例题
例 1(课件 p.3):房价训练集里 m、x、y、(x⁽¹⁾, y⁽¹⁾) 各是什么?
题面:表格两列是 Size in feet² (x) 和 Price ($) in 1000’s (y),前四行是 (2104, 460)、(1416, 232)、(1534, 315)、(852, 178)。
提示
m 数的是行,不是列。上标带括号的是编号。
解答
m 是训练样本个数,也就是表的行数;x 是面积这个特征;y 是以千美元计的价格;(x⁽¹⁾, y⁽¹⁾) = (2104, 460) 是第一个样本。x⁽²⁾ = 1416 是第二套房的面积,不是 x 的平方。
例 2(课件 p.8):三组 θ 各画出什么样的线?
题面:h_θ(x) = θ₀ + θ₁x,三组参数是 (θ₀, θ₁) = (1.5, 0)、(0, 0.5)、(1, 0.5)。
提示
先看 θ₁ 是不是 0:是 0 就是水平线。再看 θ₀,它是直线和纵轴的交点。
解答
(1.5, 0):高度 1.5 的水平线。(0, 0.5):过原点、斜率 0.5。(1, 0.5):截距 1、斜率 0.5,和第二条平行,整体抬高 1。θ₀ 管上下平移,θ₁ 管倾斜。
例 3(课件 p.11–13):三点数据上算 J(θ₁),画出碗形
见下方完整例题。
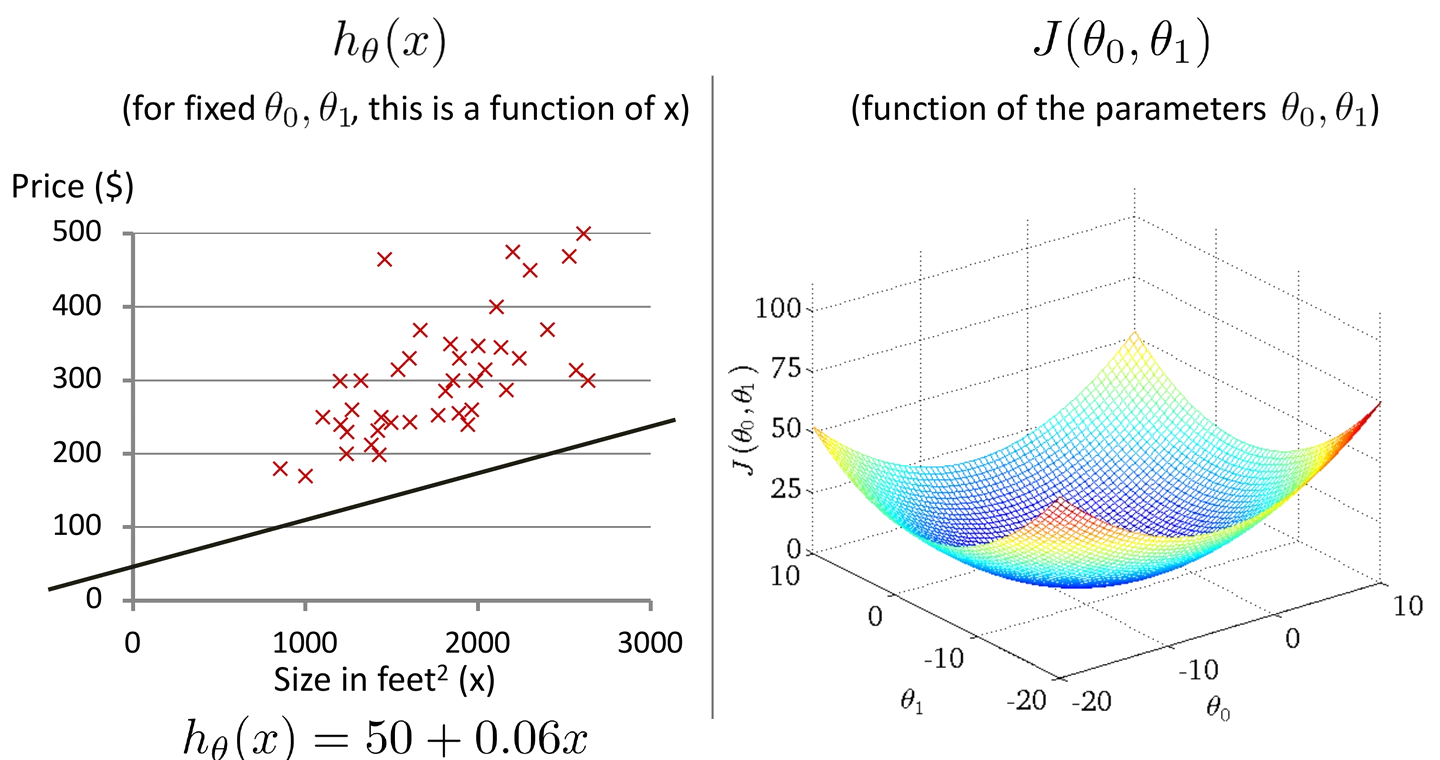
例 4(课件 p.15):直线 h_θ(x) = 50 + 0.06x 在房价图上贴不贴数据?
题面:左图是房价散点(Price 0–500,Size 0–3000)和这条直线,右图是 J(θ₀, θ₁) 的三维曲面。
提示
代一个大面积进去,看直线的高度和散点比是高还是低。
解答
x = 3000 时直线高度是 50 + 0.06 × 3000 = 230,整条线落在散点下方,误差大,所以这组 θ 在右边曲面上离碗底较远。两个参数时 J 从曲线变成曲面,仍是碗形、仍只有一个最低点。
完整例题
题面(课件 p.11–13):训练集三个点 (1,1)、(2,2)、(3,3)。把 θ₀ 固定为 0,模型变成 h_θ(x) = θ₁x。分别求 θ₁ = 1、θ₁ = 0.5 时的 J(θ₁),再说明 J(θ₁) 画出来是什么形状、最低点在哪。
约定:m = 3,J(θ₁) = (1/6) Σ (θ₁x⁽ⁱ⁾ − y⁽ⁱ⁾)²。误差写成「预测减真实」。
解法:
- θ₁ = 1。预测值 1、2、3,和真实值完全一样,误差全是 0,J(1) = 0/6 = 0。
- θ₁ = 0.5。预测值 0.5、1、1.5,误差 −0.5、−1、−1.5,平方和 0.25 + 1 + 2.25 = 3.5,J(0.5) = 3.5/6 ≈ 0.58。
- 找通式。三个点都满足 y = x,每项误差是 (θ₁ − 1)x,平方和是 (θ₁ − 1)² × 14,J(θ₁) = (14/6)(θ₁ − 1)²。代回 0.5 得 14/24 ≈ 0.58,和第 2 步一致。
- 看形状。开口向上的抛物线,关于 θ₁ = 1 对称:J(0) = J(2) ≈ 2.33。最低点在 θ₁ = 1、J = 0。
- 读两张图。左图横轴 x,每个 θ₁ 画一条线;右图横轴 θ₁,每条线变成一个点,连起来就是碗。
要点:线性回归的 J 是凸的碗,只有一个最低点,这是下一页梯度下降一定能找到最优解的前提。
答题格式:先写 J 的简化式,再列「θ₁ / 预测值 / 误差 / 平方和 / J」五列表,最后一句话说形状和最低点。
变式题(先自己做)
(1) 改编自课件 p.12:同样三个点、θ₀ = 0,求 J(0) 和 J(1.5)。 (2) 自编情境:三个点改成 (1,2)、(2,3)、(3,4),固定 θ₁ = 1,只调 θ₀。写出 J(θ₀) 的式子,求 J(0)、J(1),并说碗底在哪。 (3) 自编情境:有人把代价函数写成 (1/m) Σ (y⁽ⁱ⁾ − h_θ(x⁽ⁱ⁾))²。和课件的写法比,最低点的位置变不变?考试这样写有什么问题?
提示
(1) 照完整例题逐点算,或者直接代通式。(2) 每个点的预测是 θ₀ + x,减去真实值后三个误差都一样。(3) 乘常数、改减法顺序,各自影不影响最低点。
判分点与答案(非官方评分标准)
判分点:① (1)(2) 要写出逐点误差,不能只给结果;② (3) 要分开回答「最低点」和「写法」两件事。
(1) θ₁ = 0:预测全是 0,误差 −1、−2、−3,平方和 14,J(0) = 14/6 ≈ 2.33。θ₁ = 1.5:误差 0.5、1、1.5,平方和 3.5,J(1.5) ≈ 0.58。
(2) 预测 θ₀ + 1、θ₀ + 2、θ₀ + 3,减去真实值 2、3、4,三个误差都是 θ₀ − 1。J(θ₀) = (1/6) × 3(θ₀ − 1)² = (1/2)(θ₀ − 1)²。J(0) = 0.5,J(1) = 0,碗底在 θ₀ = 1。
(3) 最低点不变:平方后减法顺序无所谓,乘 1/m 和乘 1/2m 只差一个常数倍。但它和课件的定义不一致,系数要写 1/2m,顺序要写预测减真实,否则后面推更新式时常数和符号都会对不上。
闪卡自测
1. 单变量线性回归的假设函数是什么?两个参数各管什么?
h_θ(x) = θ₀ + θ₁x。θ₀ 是截距,控制直线上下平移;θ₁ 是斜率,控制倾斜(p.4、p.8)。
2. x⁽³⁾ 是什么意思?m 是什么?
第 3 个样本的特征值,上标是编号不是幂次。m 是训练样本个数(p.3)。
3. 写出代价函数,说出三个最容易写错的细节。
J(θ₀, θ₁) = (1/2m) Σ_{i=1}^{m} (h_θ(x⁽ⁱ⁾) − y⁽ⁱ⁾)²。细节:求和从 1 到 m、预测减真实再平方、系数是 1/2m(p.9)。
4. 为什么要平方,不直接把误差加起来?
误差有正有负,直接加会互相抵消;平方后全是正数,而且偏得远的点扣分更重。
5. 1/2m 里的 1/2 有什么用?会不会改变最优参数?
求导时和平方带下来的 2 约掉,让更新式干净。乘常数不改变最低点的位置,所以最优参数不变。
6. 三点 (1,1)(2,2)(3,3)、θ₀ = 0 时,J(1) 和 J(0.5) 各是多少?
J(1) = 0,直线穿过全部三点;J(0.5) = 3.5/6 ≈ 0.58(p.11、p.12)。
7. h_θ(x) 的图和 J(θ₁) 的图横轴分别是什么?
前者横轴是 x,固定 θ 画出一条线;后者横轴是参数 θ₁,每个 θ₁ 对应一个 J 值。左图一条线压成右图一个点(p.11、p.13)。
8. 线性回归的 J 是什么形状?有几个最低点?
一个参数时是开口向上的抛物线,两个参数时是碗形曲面,都只有一个最低点(p.13、p.15)。
9. 碗底的 J 一定是 0 吗?
不一定。只有数据正好排成一条直线时才是 0;一般情况下碗底是所有直线里最小的那个正数。
下一讲
碗底在哪,三个点时能一眼看出来;参数一多就只能一步步摸下去。下一页从斜率和导数讲起,讲梯度下降,见 L04b-2。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。