L04a-4 强化学习与 RLHF:数据靠自己试出来
从零讲强化学习:智能体在状态 s 下做动作 a,环境回给奖励 r 和新状态 s′,数据边试边攒;再看三种学习怎样按任务并列、按方法叠用,以及 RLHF 怎样把它们串进一个系统。
一句话版
强化学习没有人事先给好的数据,程序要自己去环境里试:做一个动作,看拿到多少奖励,慢慢学会怎样做奖励最多。
前三页讲了监督学习(数据带答案 y)和无监督学习(只有 x)。这一页讲第三种,再看三种学习怎样在 RLHF 里叠在一起。最好先读过 L04a-1 和 L04a-3。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 强化学习 | reinforcement learning,RL | 边试边学,靠奖励知道好坏 |
| 智能体 | agent | 做动作、拿奖励的那个程序 |
| 环境 | environment | 智能体所处的世界,会对动作做出反应 |
| 状态 s / 动作 a | state / action | 现在在哪 / 这一步做什么 |
| 奖励 r | reward | 环境对这一步的打分 |
| 策略 | policy,课件写作 strategy | 在什么状态下做什么动作的规则 |
| RLHF | Reinforcement Learning from Human Feedback,基于人类反馈的强化学习 | 先请人给回答打分,再用打分去调教语言模型 |
| 奖励模型 | reward model | 学会替人给回答打分的模型 |
一个类比:训练小狗坐下
你想教小狗听到「坐」就坐下。你没法给它看一本标准答案。你能做的是:喊「坐」,它碰巧坐下了,给一块零食;它乱跑,什么都不给。
一开始它乱试。试多了,它发现「听到坐,屁股着地」最常换来零食,就越来越常这么做。
零食是奖励,喊「坐」时它所处的情况是状态,坐下或乱跑是动作。它的训练数据是自己一次次试出来的,没人提前准备。
类比在哪里失效:
- 小狗做对了马上就有零食。很多强化学习任务的奖励要隔很多步才来,比如下棋只有终局才知道输赢,前面哪一步功劳大很难算。
- 零食是天然的好坏信号。让语言模型「回答得好」却没有现成的分数,所以 RLHF 要先请人打分,再训练一个模型来替人打分。
从零讲起
1. 强化学习:智能体和环境你来我往
它解决什么问题
有些任务没有现成的 (x, y) 对可学。下棋时每一步「正确答案」是什么,没人说得清;机器人走路,每个关节该怎么动,也没人标得出来。能知道的只是结果好不好。强化学习就是从这种「好坏反馈」里学。
直觉
智能体看一眼现在的情况,选一个动作。环境告诉它:这一步得了几分,现在到了哪。智能体把这条经历记下来,下次在同样的情况下更倾向于选得分高的动作。
一步一步看
目标:让智能体在四格走廊里往右走一趟,看每一步怎样攒下一条数据,拿到 +1 后再用来改进策略。
一条只有四格的走廊,格子 4 是终点,到了奖励 +1,其他格子奖励 0。智能体 A 从格子 1 出发。
-
A 在格子 1,看到状态 s = 1,还没选动作。
-
A 选动作「往右」,环境回给奖励 0,新状态 2。这一步攒下一条数据 (1, 往右, 0, 2)。
-
再往右,奖励 0,到格子 3。又一条数据 (2, 往右, 0, 3)。
-
再往右,到达终点格子 4,奖励 +1。数据 (3, 往右, +1, 4)。
-
这一趟走完攒了三条数据。拿去训练,策略会学到「在这条走廊里往右走」。下一趟用改进后的策略再走,又能攒到新数据。
怎么算
强化学习每一步攒下的数据是一个四元组:
一条经历 = (s, a, r, s′)
意思是:在状态 s 下做了动作 a,拿到奖励 r,到了新状态 s′。监督学习的一条数据是 (x, y),强化学习的一条数据是这四个量。
课件把整个过程画成两个循环。下面这个是智能体和环境之间的一来一回:
上面那个循环在更高一层:数据收集和训练互相指。先用当前策略去试,收集反馈;再根据反馈改进策略;改完再去试。
常见误解
以为奖励就是标签 y
y 告诉你「这一步该做什么」。奖励只告诉你「这一步做得怎样」,不说该怎么做才对。走廊里往左走得 0 分,智能体并不知道往右才对,得自己再试。
以为强化学习的数据是一次性准备好的
课件定义里的关键词是 interactively:数据边试边攒。策略一变,下一轮攒到的数据也跟着变。
试一下
同一条走廊,A 在格子 2 选了「往左」,回到格子 1。写出这条经历的 (s, a, r, s′)。
(2, 往左, 0, 1)。格子 1 不是终点,奖励 0。
2. 三种学习放在一起:按任务并列,按方法叠用
它解决什么问题
学完三种范式,容易以为它们互不相干,一个任务只能属于一类。课件用连续两页同样的三个圈纠正这一点。
直觉
按「要解决什么任务」分,三类是并列的:有答案就监督,没答案就无监督,靠试就强化。按「手里有哪些工具」看,一个系统可以同时用好几种,就像一个厨师既会炒也会蒸,做一道菜时两样都用上。
一步一步看
目标:对照课件前后两页的三个圈,看三种范式按任务分时并列,当成方法用时可以叠在一起。
-
先按数据长什么样,把三种范式排在一起看:监督学习有 (x, y) 对,无监督学习只有 x,强化学习的数据靠交互收集。
-
课件第一张图把三个圈画得互不相交,标题写明这是按任务分的简化视角。
-
翻一页,同样三个圈画成两两相交,下面加了一行字:can also be viewed as tools/methods。
-
两页之间的变化就是全部意思:按任务分并列,按方法用可以叠。下一节的 RLHF 是最好的例子。
怎么判断
给一个系统,逐个环节问:这一步的数据有没有 y?y 是给好的还是试出来的?
意思是:同一个系统里,每个环节可以分别归类。整个系统用到了几种,就说明它把几种范式叠在了一起。
常见误解
以为三种范式是互斥的,一个系统只能选一种
只在按任务分的视角下它们并列。当工具看,一个系统里可以三种全用上。
试一下
一个下棋程序先用大量人类棋谱学「高手在这个局面下会走哪步」,再自己跟自己下、赢了加分。它用了哪几种范式?
两种。学棋谱时每个局面都有高手的走法当 y,是监督学习;自己下棋靠输赢当奖励,是强化学习。
3. RLHF:请人打分,再用打分调教语言模型
它解决什么问题
大语言模型学会了续写文字,但续写出来的回答不一定是人想要的:可能啰嗦、可能答非所问。课件写它的目的是 align large language models with human preferences and values,让模型的回答对齐人的偏好。难点在于「回答得好」没有现成的分数。
从哪来(补充)
2017 年,OpenAI 和 DeepMind 的研究者用人类偏好训练智能体玩 Atari 游戏:人看两段游戏录像,选出更好的那段,程序就从这些选择里学。这套方法后来用在 InstructGPT 上流行起来,ChatGPT 也列在用 RLHF 训练的模型里。最后一步优化策略,通常用一种叫 PPO 的强化学习算法。
出处:Wikipedia: Reinforcement learning from human feedback
直觉
人没空给模型的每一个回答打分。所以先请人给一小批回答排个序,训练一个「打分员」模型学会人的口味。之后让这个打分员替人打分,语言模型照着分数调整自己,就是强化学习。
一步一步看
目标:沿 RLHF 流程图从左到右走四个环节,看人的排序怎样变成奖励模型的分数,再拿来调教语言模型。
课件的流程图取自维基百科,从左到右是四个环节:
- 用「提示 → 回答」对做监督训练,得到一个初始模型。
- 让这个模型对同一个提示给出几个回答,请人排序。排序结果再转成分数。
- 用这些排序数据训练奖励模型,让它学会给回答打分。
- 奖励模型通过 PPO 指导语言模型继续训练,得到对齐后的模型。
怎么判断
按上一节的办法逐步问「有没有 y,y 从哪来」:
| 环节 | 有没有 y | 归类 |
|---|---|---|
| 初始模型训练 | 有,回答就是 y | 监督学习 |
| 人来排序 | 这一步在造 y | 人工标注 |
| 训练奖励模型 | 有,排序就是 y | 监督学习 |
| PPO 微调语言模型 | 没有 y,只有奖励模型给的分 | 强化学习 |
意思是:只有最后一步是强化学习,前面都在为它准备奖励。课件底部把它压成三步:收集偏好数据、训练奖励模型、微调语言模型。
常见误解
以为 RLHF 从头到尾都是强化学习
名字里有 RL,但三步里前两步都属于监督学习一侧,只有最后一步是强化学习。
以为人要给语言模型的每个回答打分
人只给一小批回答排序。之后打分由奖励模型来做,所以才要专门训练它。
试一下
RLHF 里如果跳过奖励模型,让人直接给强化学习每一步打分,最大的困难是什么?
量太大。强化学习要试成千上万次,每次都要人打分不现实。奖励模型就是为了替人做这件事。
把它们串起来
三种学习按数据来源分。监督学习的数据是 (x, y) 对,事先给好;无监督学习只有 x;强化学习的数据边试边攒,每一步是 (s, a, r, s′)。
强化学习的核心是一个循环。智能体在状态 s 下做动作 a,环境回给奖励 r 和新状态 s′。攒够了经历就改进策略,再去试。奖励只说好坏,不说该怎么做,所以它得自己摸索。
三种学习按任务分是并列的,当工具看可以叠用。RLHF 就是例子:监督训练出初始模型,人工排序加监督学习训练出奖励模型,最后用强化学习让语言模型对齐人的偏好。
这一讲到这里是整门机器学习的地图。下一讲开始只走其中一条路:监督学习里的回归,从最简单的直线讲起。
课件里的坑
- [课件留白] p.7 和 p.8 是同样三个圈,一张不相交、一张两两相交。课件只加了一行 can also be viewed as tools/methods,不解释。考试问「三种范式互斥吗」,答「按任务并列,按方法可以叠加」,举 RLHF 为例。
- [用词] p.42 写的是 strategy,强化学习文献里通行的叫法是 policy(策略)。两个词指同一件事:从状态到动作的规则。
- [读图提醒] p.43 的流程图有四个环节,底部文字总结成三步。背三步时,第一步「收集偏好」对应图里的人工排序,图里最前面的监督训练是准备阶段。
- [缩写] p.43 出现了 PPO(Proximal Policy Optimization),课件只给缩写,考试不要求展开算法。
课后 10 分钟:考点复习
这 10 分钟怎么用:先合上页面,在纸上画出智能体和环境的循环,标上 s、a、r、s′。然后对着完整例题,把 RLHF 每一步「有没有 y、y 从哪来」说一遍。最后做变式题,先不看提示。
必背
- 三种范式按数据分:监督学习有 (x, y) 对,无监督学习只有 x,强化学习的数据靠和环境交互收集
- 强化学习一步的四个记号:状态 s、动作 a、奖励 r、新状态 s′;智能体在 s 下选 a,环境返回 r 和 s′
- 课件把数据收集和训练画成循环:先用当前策略去试、收集反馈,再根据反馈改进策略
- 三种范式按任务分是并列的,按方法用可以叠在一个系统里
- RLHF 三步:收集人类偏好排序、训练奖励模型、用奖励模型指导语言模型微调,前两步都是监督学习,最后一步才是强化学习
课件例题
例 1(课件 p.7–8):三个圈一张不相交、一张两两相交,各说明什么?
题面:p.7 是三个互不相交的圈,写着 Supervised、Unsupervised、Reinforcement Learning,标题是 A Simplistic View Based on Tasks。p.8 同样三个圈两两相交,下面加了 can also be viewed as tools/methods。
提示
注意 p.7 标题里的 Based on Tasks 和 p.8 新加的 tools/methods。
解答
p.7:按任务分,三类并列。p.8:当工具看,三类可以在一个系统里叠用。例子是 p.43 的 RLHF,监督学习和强化学习都用上了。
例 2(课件 p.42):强化学习的数据和监督学习有什么不同?写出循环里的四个量。
题面:p.42 写 The algorithm can collect data interactively;上半图是数据收集和训练的循环,下半图是智能体和环境的循环。
提示
找定义里那个副词。
解答
监督学习的数据事先给好,强化学习的数据是交互式收集的。四个量:状态 s、动作 a、奖励 r、新状态 s′。智能体在 s 下做 a,环境返回 r 和 s′。
例 3(课件 p.43):RLHF 流程里每一步属于哪种范式?
见下方完整例题。
完整例题
题目:课件的 RLHF 流程图从「提示数据」一路走到「对齐后的模型」。把图里的每一步归到监督学习或强化学习,并说出依据;再写出课件底部总结的三步。
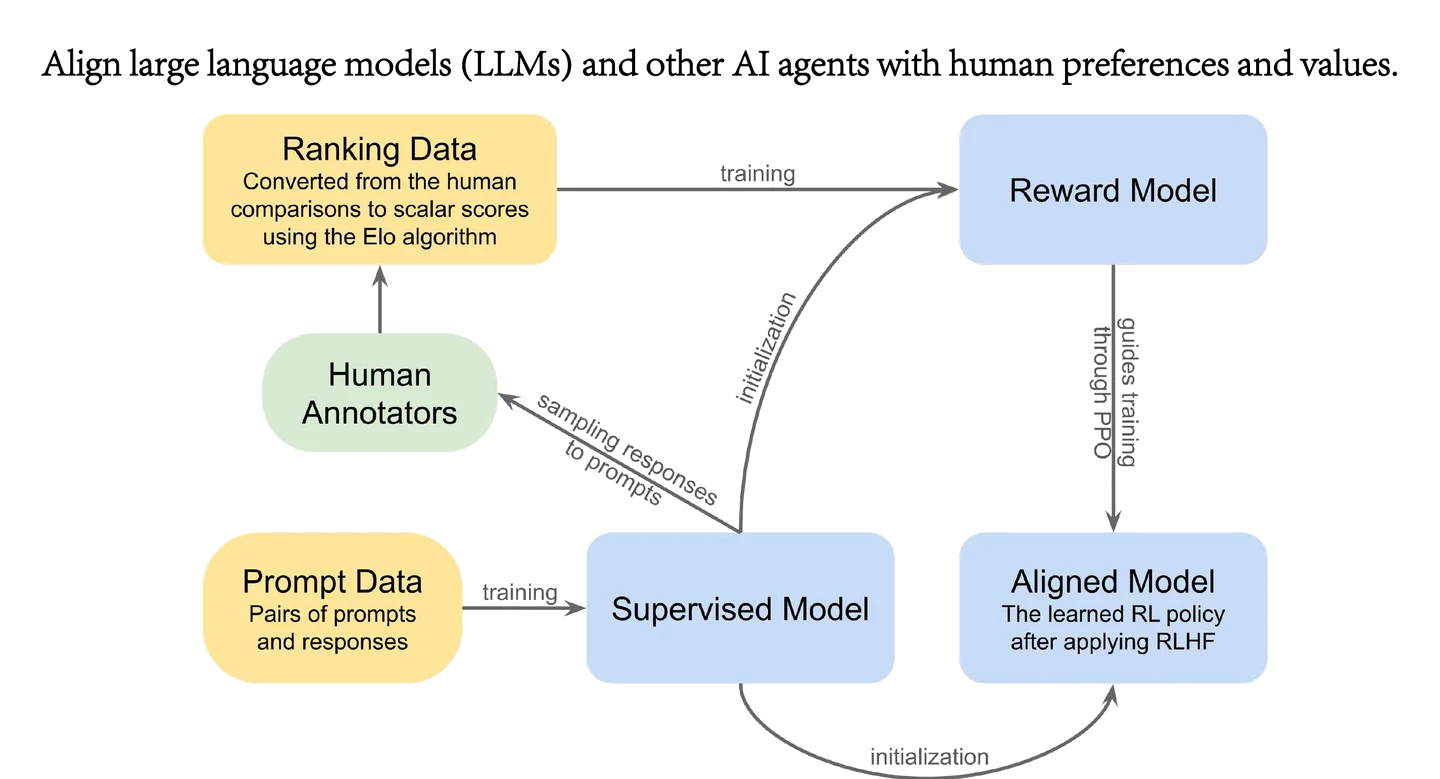
解:按「有没有 y、y 从哪来」逐步判断。
| 步骤 | 做什么 | 有没有 y | 归类 |
|---|---|---|---|
| 0 | 用「提示–回答」对训练,得到初始模型 | 有,回答就是 y | 监督学习 |
| 1 | 模型对同一提示给出多个回答,人来排序 | 这一步在造 y | 人工标注 |
| 2 | 用排序数据训练奖励模型 | 有,排序就是 y | 监督学习 |
| 3 | 奖励模型通过 PPO 指导语言模型微调 | 没有现成 y,只有奖励模型给的分 | 强化学习 |
课件底部的三步:收集人类反馈、建偏好数据集;训练奖励模型;微调语言模型。对应上表的第 1、2、3 步。考点说「前两步都是监督学习」,是把第 1 步算进监督学习这一侧:它不训练模型,只是给第 2 步造标签。
结论:整个流程里只有最后一步是强化学习。这正是 p.8 那张「三个圈两两相交」的图想说的。
答题格式:先写三步的英文或中文名称,再逐步标出范式和依据,最后一句点明「只有第 3 步是强化学习」。
变式题(先自己做)
(1) 自编情境:把下面五个任务归入监督学习、无监督学习、强化学习之一,并说出判断依据。① 根据房子面积和房间数预测成交价;② 把一万篇新闻按主题自动分组,事先不知道有哪些主题;③ 训练一个程序玩跳棋,赢了加分输了扣分;④ 判断一张 X 光片有没有肺炎;⑤ 机器人学走路,摔倒扣分、走得远加分。 (2) 自编情境:一条五格走廊,格子 5 是终点,奖励 +1,其他格子奖励 0。智能体从格子 2 出发,依次做「往右、往左、往右、往右、往右」。写出每一步的 (s, a, r, s′)。
提示
(1) 先问有没有 y;没有 y 再问数据是给定的还是试出来的。(2) 每一步的 s′ 就是下一步的 s。
判分点与答案(非官方评分标准)
判分点:① (1) 每题写出依据,不能只给类别;② (2) 五个四元组前后衔接。
(1) ① 监督(回归),y 是成交价。② 无监督,没有 y,找主题就是聚类。③ 强化,数据靠一局局下出来,输赢是奖励。④ 监督(分类),y 是有或没有。⑤ 强化,摔倒和走远是奖励,动作要自己试。
(2) (2, 往右, 0, 3)、(3, 往左, 0, 2)、(2, 往右, 0, 3)、(3, 往右, 0, 4)、(4, 往右, +1, 5)。
闪卡自测
1. 强化学习的数据和监督学习的数据最本质的区别是什么?
收集方式。监督学习的 (x, y) 事先给好,强化学习的数据交互式收集(p.42)。
2. 强化学习循环里出现哪四个记号?
状态 s、动作 a、奖励 r、新状态 s′(p.42)。
3. 课件上半张图的循环是哪两件事?
数据收集和训练:用策略去试、收集反馈;根据反馈改进策略(p.42)。
4. 课件第 7 页和第 8 页的三个圈有什么区别?
第 7 页互不相交,按任务分三类并列;第 8 页两两相交,加了 can also be viewed as tools/methods,表示一个系统里可以叠用(p.7–8)。
5. RLHF 的目的是什么?
让大语言模型和其他智能体对齐人的偏好和价值观(p.43)。
6. RLHF 三步里哪一步是强化学习?
只有最后一步「用奖励模型指导语言模型微调」。前两步属于监督学习一侧(p.43)。
7. 为什么 RLHF 要专门训练一个奖励模型?
强化学习要试很多次,每次都请人打分不现实,奖励模型替人打分(p.43)。
下一讲
下一讲 L04b-1 把房价那条直线正式写成假设函数 h(x) = θ₀ + θ₁x,用代价函数衡量它有多准,再用梯度下降把参数调到最准。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。