L09d 选择公平:去掉组别不管用,按场景挑定义并公开审计
从零讲清课件最后一部分:不可能结果在投票理论里也很常见,把组别从输入里删掉挡不住代理变量,不同场景配不同的公平定义,取舍要公开,审计要从数格子开始,以及六件套之外的因果公平和个体公平。
一句话版
六条定义不能全要,把组别藏起来也躲不开;能做的是按场景挑一条定义,把选择和错误率公开,让别人能检查、能争论。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 不可能结果 | impossibility result | 一组看似都合理的要求,证明不能同时满足 |
| 代理变量 | proxy | 不直接是组别,却和组别高度相关的线索 |
| 盲选择器 | blind selector | 输入里不含组别的选择器 |
| 可读的取舍 | legible trade-off | 把选了什么、代价在哪写出来给人看 |
| 审计 | audit | 拿数据逐项检查公平声明 |
| 因果公平 | causal fairness | 只改组别,决定会不会变 |
| 个体公平 | individual fairness | 相似的人有没有被相似对待 |
一个类比:城市的交通规划
一座城市要修路,目标有好几个:通勤快、噪音小、造价低、每个区都照顾到。规划师知道这些目标互相打架,不会假装全都能满足。
好的做法是:说清楚这条路优先照顾哪个目标,公布各区受到的影响,开听证会让居民争论。
只说「我们没看是哪个区」并不能证明规划公平,因为地价、学校、公交线路早就把区分得清清楚楚。
类比在哪里失效:
- 交通目标之间的冲突常靠经验判断;公平定义之间的冲突能写成命题证明。
- 修路的影响看得见;算法选择的影响要先把每组的格子数出来才看得见。
- 交通规划有法定听证程序;算法公平怎样公开、向谁公开,课件只给了原则。
从零讲起
1. 不可能是常态
它解决什么问题
上一页的结论是六条定义只能挑一条。听起来像公平这个概念本身出了问题。课件用投票理论说明:一组合理要求不能同时满足,在别的领域早就很常见。
从哪来(补充)
Arrow 不可能定理:Kenneth Arrow 1950 年在 Journal of Political Economy 发表论文证明,后收入 1963 年版的 Social Choice and Individual Values。结论是:备选项至少三个时,没有按排序汇总的群体决策规则能同时满足一组合理条件。课件画的三人循环是 Condorcet 投票悖论,Arrow 定理是更一般的结论。出处:Arrow’s impossibility theorem, Wikipedia。
Simpson 悖论:几组数据里各自出现的趋势,合并后消失或反转,Edward H. Simpson 1951 年的论文描述过。常见例子是 1973 年秋季伯克利研究生录取:合并看男性录取率约 44%、女性约 35%;按院系看,女性更多申请录取率低的院系。出处:Simpson’s paradox, Wikipedia。
直觉
三个投票人对 A、B、C 三个选项的排序各不相同。两两多数票比较时,A 赢 B,B 赢 C,C 又赢 A,绕成一个圈,没有一致的赢家。
课件把这件事和 Arrow 定理、Simpson 悖论放在一起,最后说:如果公平最后比投票还简单,那才叫意外。
Simpson 悖论和上一页的构成效应是同一类现象:整体比例由各组组成决定,合并看和分开看可以得出不同的结论。
一步一步看
目标:用三人投票表,看出两两多数票为什么会绕圈。
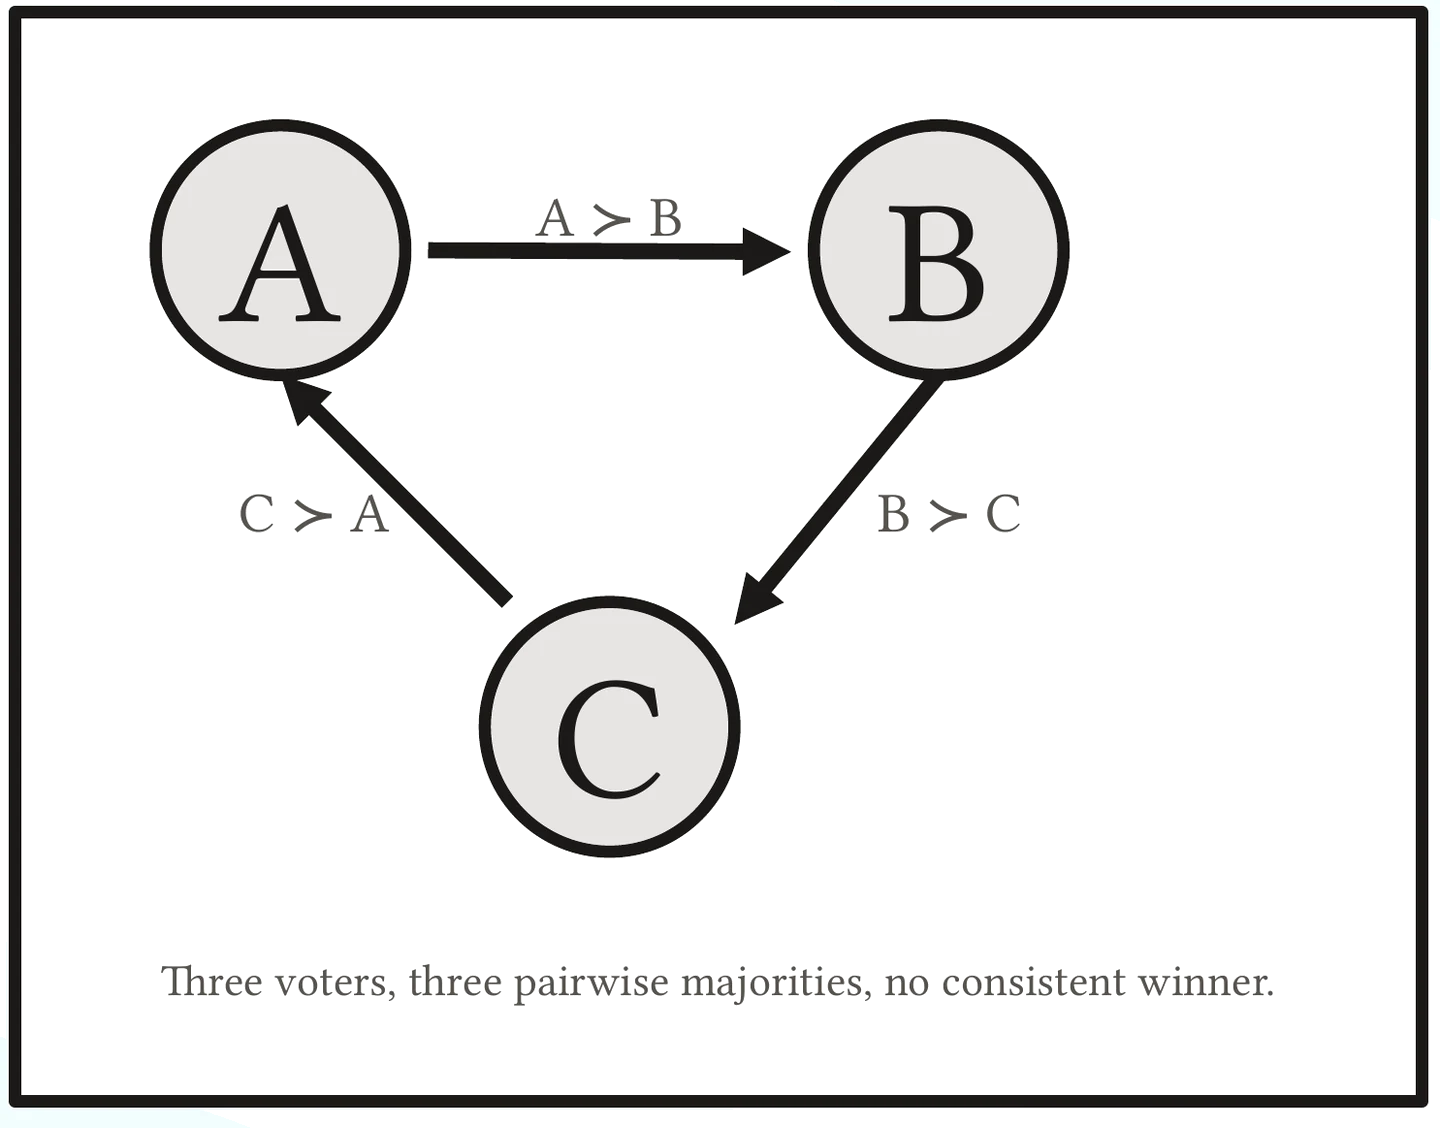
-
写出三个投票人的排序。
投票人 第一 第二 第三 1 A B C 2 B C A 3 C A B -
比 A 和 B:投票人 1、3 把 A 排在 B 前,A 以两票对一票胜。
-
同样比 B 和 C,B 胜;比 C 和 A,C 胜。
-
结论:三个两两比较绕成一个圈,没有一致的赢家。
怎么判断
判断口诀:每条要求单独看都合理,不代表能一起满足;先问它们之间有没有被证明过的冲突。
| 领域 | 不可能结果 | 说的是 |
|---|---|---|
| 投票 | Arrow 定理 | 没有投票规则能同时满足一小组公平公理 |
| 统计 | Simpson 悖论 | 合并能反转每个子组里的趋势 |
| 算法公平 | 上一页的两个命题 | 基率不同时几条定义不能同时成立 |
意思是:公平定义互相冲突,并不说明公平是个坏概念,它和投票、统计里的老问题属于同一类。
常见误解
误解:定义之间有冲突,说明算法公平是个伪命题
课件的态度相反:投票理论早有 Arrow 定理,大家照样设计选举制度。冲突说明必须做选择,并不说明不用讲公平。
误解:课件的三人循环就是 Arrow 定理本身
三人循环是 Condorcet 投票悖论,是一个具体例子。Arrow 定理是更一般的结论,说的是所有按排序汇总的规则。
试一下
如果第三个投票人的排序改成 A、B、C,两两多数票还会绕圈吗?
答案
不会。A 对 B 有投票人 1、3 支持,A 胜;A 对 C 有投票人 1、3 支持,A 胜;B 对 C 有投票人 1、2、3 支持,B 胜。A 是一致的赢家。
2. 去掉组别为什么不管用
它解决什么问题
一个很自然的想法是:既然组别惹麻烦,那就不让选择器看到组别。课件用两页说明这条路走不通。
直觉
一个从来没看过组别的选择器,仍然能从上百条小线索里把组别读出来。
课件举的线索有:姓氏、口音、居住的街区;参加机器人社还是书法社;学校、爱好、消费习惯。这些都和组别相关,课件的标题就是 BECAUSE EVERYTHING CORRELATES。
一个肯下功夫的学习器能从代理变量里重建 G,偏见换了个样子又回来了。去掉标签,信息还在。
一步一步看
目标:画出组别影响决定的两条路,看去掉组别切断了哪一条。
-
找出组别到决定的两条路。
路径 走法 去掉 G 后 直接 G → S 被切断 间接 G → 代理变量 → S 仍然存在 -
选择器只看代理变量,代理变量又和组别相关,组别的信息就通过间接路径流进决定。
-
结论:盲选择器仍能通过代理变量看到组别,盲不等于中立。
怎么判断
判断口诀:去掉一个变量之前,先问还有哪些变量能把它猜出来。
| 说法 | 是否成立 | 原因 |
|---|---|---|
| 不输入组别,就不会因组别区别对待 | 不成立 | 代理变量带着组别信息 |
| 去掉标签就去掉了信息 | 不成立 | 信息分散在其他特征里 |
| 要检查公平,仍需要组别数据 | 成立 | 不知道谁属于哪组,就算不出每组的比例 |
意思是:蒙上选择器的眼睛,偏见并不会消失;审计时反而需要组别,才能把每组的格子数出来。
常见误解
误解:只要删掉所有和组别有关的特征就行
课件说一切都相关。删到最后,和组别相关的特征往往也是和目标相关的特征,选择器会变得没用。
误解:盲选择器至少能满足人口均等
不一定。选择器通过代理变量间接读出组别,各组的选择率照样可以不同;人口均等要拿各组的选择率去算才知道。
试一下
一个贷款模型不输入申请人所属的组,但输入邮编。说出一种组别信息可能流进决定的方式。
答案
如果不同组的人集中住在不同的街区,邮编就带着组别信息,这是一个代理变量。模型看邮编,就间接看到了组别。
3. 按场景挑定义,并把取舍公开
它解决什么问题
既然只能挑一条,挑哪条?课件的回答是:公平是一个选择,不是一个勾选框;挑哪条要看场景里真正要问的问题。
直觉
每个场景都有一个最要紧的问题,这个问题指向一条定义。
招聘和晋升问:同样够格的候选人机会一样吗?这是等几率。大学录取问:各组需要同等代表吗?这是人口均等。借贷和保险问:分数对每组意思一样吗?这是预测均等。公屋和奖学金抽签问:要不要让运气完全代替判断?这是目标无关或分层无关。
警务最难:要相等的错误率,还是按比例的拦查?等几率和人口均等在这里正面冲突。
挑好以后,课件要求把取舍摆出来:公布指标,按组列出错误率,邀请审视。透明不消除取舍,它让取舍可以被争论。
一步一步看
目标:把课件的五个场景对上各自的问题和定义。
-
读出每个场景要问的问题。
场景 要问的问题 对应定义 招聘和晋升 同样够格的人机会一样吗 等几率 大学录取 各组需要同等代表吗 人口均等 借贷和保险 分数对每组意思一样吗 预测均等 公屋和奖学金抽签 要让运气代替判断吗 目标无关或分层无关 警务 相等错误率,还是按比例拦查 等几率对人口均等 -
挑好定义后,做三件公开的事。
动作 内容 公布指标 说出选了哪条定义,以及理由 列出错误率 把数字按组拆开 邀请审视 像辩论法律一样辩论它 -
结论:定义是按价值观挑的,公开后才能被别人检查和争论。
怎么判断
判断口诀:先写下这个场景最怕哪种不公平,再找管这件事的定义。
意思是:没有一条定义在所有场景都对;课件给的五个场景是参考,具体场景要说出理由。
常见误解
误解:公开了指标和错误率,取舍就解决了
课件原话:透明不消除取舍,它让取舍可以被争论。冲突还在,只是决定从幕后搬到了台前。
误解:既然有现成的对照表,照表选就行
课件的标题是公平是选择,不是勾选框。对照表给的是每个场景最要紧的问题,警务一行就没有定论。
试一下
一个医院用模型决定谁优先做进一步检查。按课件的思路,你会先问什么问题?可能对应哪条定义?
答案
可以先问:同样需要检查的病人,各组被选中的机会一样吗?这对应等几率。也可以有别的理由选别的定义,关键是公开说明。
4. 六步审计,以及六件套之外
它解决什么问题
有人声称一个系统公平,怎么检查?课件的说法是:一条公平声明的可信程度,取决于它背后的那张表。
从哪来(补充)
课件推荐的书是 Solon Barocas、Moritz Hardt、Arvind Narayanan 合著的《Fairness and Machine Learning》,副标题 Limitations and Opportunities,MIT Press 2023 年出版,网站提供全书可免费读。出处:fairmlbook.org。
直觉
审计的核心是第三步:把每组的 TP、FP、FN、TN 数出来。有了这张表,选择率、TPR、FPR、PPV 都能算,六条定义也都能逐条检查。
课件的底线是:填不出格子,就不能声称公平。
六件套也不是全部。课件说还有几十种别的定义,紧挨着的有两种:因果公平问「如果组别换了,决定会变吗」;个体公平问「相似的人是否被相似对待」,它是对个人的承诺,不是对平均数的。
一步一步看
目标:按课件的六格走一遍审计流程。
-
读出六格。
步骤 课件写的 要做什么 第一格 DEMOGRAPHIC PARITY 疑似模板残留,见课件里的坑 第二格 定义比较的组 比哪些组,为什么 第三格 数格子 每组的 TP、FP、FN、TN 第四格 算比例 选择率、TPR、FPR、PPV 第五格 挑定义 让指标和场景对上 第六格 公开辩论 让取舍可读 -
把审计和前面几页对上:第三、四格就是上一页六问表的做法,第五、六格就是上一节的内容。
-
结论:审计的每一步都落在一张表上,没有表的公平声明无从检查。
怎么判断
判断口诀:听到「这个系统是公平的」,先问:按哪条定义,表在哪里。
| 声明 | 缺什么 |
|---|---|
| 我们的模型没有偏见 | 没说按哪条定义 |
| 各组选择率相同 | 只说了人口均等,其余几条没查 |
| 我们没用组别 | 代理变量没查,格子也没数 |
意思是:一条声明要说清定义,并附上每组的格子,才算可以检查。
常见误解
误解:审计就是检查各组选择率是否相同
那只是人口均等一条。课件的审计从数四个格子开始,算出几种比例,再按场景挑定义。
误解:六件套覆盖了所有公平定义
课件明说还有几十种,紧挨着的就有因果公平和个体公平。个体公平看的是相似的人,不看群体平均数。
试一下
一家公司说:「我们的招聘模型各组录取率完全相同,所以是公平的。」按课件的审计思路,你会追问哪两件事?
答案
追问一:按场景,招聘最要紧的问题是同样够格的人机会是否一样,为什么挑人口均等?追问二:每组的 TP、FP、FN、TN 是多少,等几率成立吗?
把它们串起来
不可能结果在投票理论和统计里早就出现过,公平定义互相冲突不是公平这个概念的失败。
把组别从输入里删掉挡不住代理变量,盲不等于中立,审计反而需要组别数据。
剩下的路是:按场景挑一条定义,把选择和按组拆开的错误率公开,从数格子开始审计。六件套之外,还有因果公平和个体公平可以继续读。
课件里的坑
- [疑似模板残留] p.41 六步审计的第一格印 DEMOGRAPHIC PARITY / Same selection rate per group,和其余五格的动作格式不一致,像是从六件套页照搬未改;原意课件没写,答题时可按其余五步作答并说明
- [画法提醒] p.36 的三人循环是 Condorcet 投票悖论;Arrow 定理是更一般的结论,图只是举例
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先默写五个场景和对应定义;再写出六步审计里能写清的五步;最后把 Match the Notation 六题做一遍,对照解答。
必背
- 不可能结果很常见:Arrow 定理说没有投票规则能同时满足一小组公平公理,Simpson 悖论说合并数据能反转每个子组里的趋势
- 去掉 G 不等于公平:选择器能通过姓名、学校、社团、街区等代理变量重新读出组别,盲不等于中立
- 公平是选择,不是勾选框:招聘配等几率,大学录取配人口均等,借贷保险配预测均等,公屋和奖学金抽签配目标或分层无关,警务在等几率和人口均等之间争论
- 取舍是价值判断就要公开:公布选了哪条指标和理由、按组列出错误率、像辩论法律一样接受审视
- 审计要从表开始:定义比较的组、数每组的 TP/FP/FN/TN、算选择率/TPR/FPR/PPV、按场景挑定义、公开辩论;填不出格子就不能声称公平
- 六件套之外还有因果公平(换了组别决定会变吗)和个体公平(相似的人是否被相似对待)
课件例题
例 1(课件 p.36):不可能是常态
题面:三个投票人的排序是 A > B > C、B > C > A、C > A > B。两两多数票结果是什么?课件用它说明什么?
提示
每对比较数一数几票。
解答
A 胜 B,B 胜 C,C 胜 A,形成循环,没有一致的赢家。课件用它和 Arrow 定理、Simpson 悖论说明:一组合理要求不能同时满足很常见,公平比投票还简单才叫意外。
例 2(课件 p.37–38):去掉 G
题面:为什么不让选择器看到组别,不能保证公平?
提示
直接路径和间接路径。
解答
去掉 G 只切断了 G → S 的直接路径。姓氏、口音、街区、社团、学校、爱好、消费习惯都和组别相关,学习器能从这些代理变量重建 G,偏见换个样子回来。去掉标签不去掉信息,盲不等于中立。
例 3(课件 p.39):按场景挑定义
题面:招聘晋升、大学录取、借贷保险、公屋和奖学金抽签、警务,各配哪条定义?
提示
先写每个场景最要紧的问题。
解答
招聘晋升配等几率;大学录取配人口均等;借贷保险配预测均等;公屋和奖学金抽签配目标无关或分层无关;警务在等几率和人口均等之间争论。
例 4(课件 p.40):让取舍可读
题面:取舍是价值判断时,课件要求做哪三件事?透明能消除取舍吗?
提示
指标、错误率、审视。
解答
公布指标(说出选了哪条定义和理由);按组列出错误率;像辩论法律一样邀请审视。透明不消除取舍,它让取舍可以被争论。
例 5(课件 p.41):六步审计
题面:写出六步审计里动作清楚的五步和课件的结论句。
提示
第一格疑似模板残留。
解答
定义比较的组;数每组的 TP、FP、FN、TN;算选择率、TPR、FPR、PPV;按场景挑定义;公开并辩论。结论:填不出格子,就不能声称公平。第一格印的是人口均等,疑似模板残留,作答时可说明。
例 6(课件 p.42):Match the Notation
题面:把左边六个式子和右边六句话配对。
- S⊥G
- T⊥G
- S⊥T
- S⊥G|T
- T⊥G|S
- S⊥T|G
- A. 选择完全不看才能,就是抽签
- B. 被选中的人在每组都同样可能有才能
- C. 每组被选中的比例相同
- D. 每组内部,选择不看才能
- E. 每组的人才储备一样强
- F. 有才能的人和其余的人里,各组错误率相同
提示
上排三个看两两独立,下排三个先固定第三个变量。
解答
1-C,2-E,3-A,4-F,5-B,6-D。
例 7(课件 p.43):六件套之外
题面:课件说紧挨着六件套的还有哪两种定义?各问什么?
提示
一个看因果,一个看个人。
解答
因果公平:如果组别换了,决定会变吗?个体公平:相似的人是否被相似对待?它是对个人的承诺,不是对平均数的。课件推荐的延伸读物是 Barocas、Hardt、Narayanan 的《Fairness and Machine Learning》。
完整例题
题目:一个城市用模型分配公屋。审计报告只写了一句:「模型不使用申请人的族群信息,因此是公平的。」按本讲内容写一段审计意见。
① 指出盲选择器的问题。不用族群信息只切断直接路径,居住街区、学校、姓名等代理变量仍可能带着族群信息。
② 指出缺少定义。报告没说按哪条定义判断公平。按课件,公屋分配可以配目标无关或分层无关,需要说明理由。
③ 要求数格子。要拿到每组的申请人数、获配人数,以及(若有资格标准)每组的 TP、FP、FN、TN。
④ 算比例并检查。按选定的定义算出对应比例;如用分层无关,要检查组内是否真的抽签、组间名额是怎么定的。
⑤ 要求公开。公布选用的指标、理由和按组拆开的结果,接受公众审视。
变式题(先自己做)
自编情境:一家银行说:「我们的信用评分对每组的意思都一样:评分高的人里,每组违约的比例相同。」这对应哪条定义?按课件的场景对照合理吗?要审计它,还需要哪些数据?它可能牺牲哪条定义?
提示
把「评分高」当成 S,「不违约」当成 T。
判分点与答案(非官方评分标准)
定义:评分高者里结果比例各组相同,是预测均等 T⊥G|S。
场景:课件把借贷保险配预测均等,合理,仍需写出理由。
数据:每组的 TP、FP、FN、TN,以及组别数据本身。
代价:若各组基率不同,按上一页命题 2,人口均等和预测均等不能同时成立;等几率一般也难以同时满足。
判分点:定义识别正确;指出要组别数据和四格;能说出至少一条被牺牲的定义及原因。
闪卡自测
1. 课件三人循环叫什么?
Condorcet 投票悖论,Arrow 定理是更一般的结论(p.36)。
2. Simpson 悖论说什么?
合并数据能反转每个子组里都成立的趋势(p.36)。
3. 为什么去掉 G 不管用?
代理变量能把组别重新读出来,盲不等于中立(p.37)。
4. 课件举了哪些代理变量?
姓氏、口音、街区、社团、学校、爱好、消费习惯(p.38)。
5. 招聘配哪条定义?
等几率(p.39)。
6. 借贷保险配哪条定义?
预测均等(p.39)。
7. 让取舍可读的三件事?
公布指标、按组列错误率、邀请审视(p.40)。
8. 审计的底线?
填不出格子,就不能声称公平(p.41)。
9. T⊥G|S 配哪句话?
被选中的人在每组都同样可能有才能(p.42)。
10. 六件套之外紧挨着的两种定义?
因果公平和个体公平(p.43)。
下一讲
进度表下一讲是 Ethics of AI and generative tools(周一班 11/16、周六班 11/21),从 L10a 开始:生成式 AI 写得流畅不等于写得对,它在文献检索、数据和分析上怎么帮忙、每一步要怎么核查。回到 课程目录 可以按讲次复习。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。