L07a-3 标识符与匿名:去掉名字不等于认不出人
从零讲清直接与间接标识符、去标识化/假名化/匿名三个标签各承诺什么、匿名化为什么是情境中的再识别评估,在无名数据认出 Leo、假名化表格的钥匙等场景上一步步套判断。
一句话版
一份去掉名字的数据,只要用现实手段还能认出是谁,就还没有匿名。
先认识这几个词
上一页留下一个问题:数据真正匿名后为什么删不掉,见 L07a-2。「几条无害的信息拼起来认出一个人」在第一讲出现过,叫马赛克效应。
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 标识符 | identifier | 能把一条数据连回一个具体的人的信息 |
| 直接标识符 | direct identifier | 单独一项就能指出是谁,比如姓名 |
| 间接标识符 | indirect identifier | 单看无害,和别的信息拼起来能指出是谁 |
| 去标识化 | de-identification | 去掉一部分标识信息的宽泛说法 |
| 假名化 | pseudonymization | 把名字换成代码,代码和真人的对照表另外锁好 |
| 匿名化 | anonymization | 处理到用现实手段也认不出是谁 |
| 再识别 | re-identification | 从处理过的数据里重新认出某个人 |
| GDPR | General Data Protection Regulation,通用数据保护条例 | 欧盟的个人数据保护法规,下一页细讲 |
一个类比:衣帽间的号码牌
你去听音乐会,把外套存进衣帽间,拿到一张写着「号码 X9」的牌子。外套挂在架子上,上面没有你的名字。可衣帽间的登记本上写着「X9 是这位穿红围巾的女士」,只要拿出登记本,外套就能对回到你。
这就是假名化:名字换成了代码,但钥匙(登记本)还在。所以衣帽间要把登记本锁好,外套也仍然算「你的东西」。
再想一种情况:衣帽间连登记本都没有,号码牌也收回了。可架子上只有一件外套是荧光粉色、带击剑社徽章的,全场都知道那是谁的。没有名字、没有号码,照样认得出。这就是间接标识符拼起来的效果。
真正的匿名,是在这个衣帽间、这群观众里,用现实可用的办法也分不出哪件是谁的。
类比在哪里失效:
- 外套是物件,认出来最多是尴尬;研究数据认出一个人,暴露的可能是健康、成绩这类会被评判的信息。
- 衣帽间换一场演出,观众换了,判断要重做;数据也一样,判断依据会随时间和技术变化,而外套的样子不会变。
从零讲起
1. 直接标识符和间接标识符
它解决什么问题
研究者处理数据时最常做的一步是「把名字删掉」。删完以后,人还认不认得出来?
要回答这个问题,先得数清数据里有哪些信息能把人认出来。标识符分两类,删名字只处理了其中一类。
从哪来(补充)
间接标识符能认出人,有一个常被引用的案例。研究者 Latanya Sweeney 在 1997 年用公开记录,在一份去掉了身份信息的医疗数据里认出了时任马萨诸塞州州长 Bill Weld。她后来指出,87% 的美国人可以凭出生日期、性别、邮编三项被唯一识别。出处:Wikipedia: Latanya Sweeney。
直觉
- 直接标识符:姓名、邮箱地址、证件号码、人脸照片,或直接指向某人的链接。单独一项就能指出是谁。
- 间接标识符:位置、在线标识(比如账号)、精细的时间戳,以及罕见的特征组合。单看无害,拼在一起可能只剩一个人。
间接标识符像拼图的碎片。一片看不出画的是什么,几片拼起来,轮廓就出来了。越罕见的特征,越容易把范围缩到一个人。
一步一步看
目标:拿 Jordan T. 那一行逐列清点再把间接列拼起来,看删掉直接标识符后为何仍可能认出他。
案例:课件里的一张表有六列:姓名、邮箱、证件号、年龄、邮编、冷门爱好。其中一行是 Jordan T.,34 岁,邮编 94110,爱好修复古董打字机。逐列清点。
-
先找单独一项就能指出是谁的列。
列 单独能不能指出是谁 类别 姓名 能 直接 邮箱 能 直接 证件号 能 直接 -
剩下的列单看如何。
列 单看 类别 年龄 34 很多人都是这个年龄 间接 邮编 94110 一个区有很多人 间接 修复古董打字机 冷门,但单看不知道是谁 间接 -
把间接的几列拼起来。
拼法 剩下几个人 只看年龄 很多 年龄 + 邮编 少了很多 年龄 + 邮编 + 修复古董打字机 可能只剩一个
三步走完,删掉前三列之后,后三列拼起来仍可能认出 Jordan。
怎么判断
判断口诀:一项一项问「单独能不能指出是谁」,再把剩下的拼起来问一次。
| 信息 | 类别 | 处理时要注意 |
|---|---|---|
| 姓名、邮箱、证件号、人脸、直接链接 | 直接标识符 | 删掉或换成代码 |
| 位置、在线标识 | 间接标识符 | 能和别的记录对上 |
| 精细时间戳 | 间接标识符 | 能和门禁、上网日志对上 |
| 罕见特征组合 | 间接标识符 | 越罕见越危险 |
意思是:两类都要清点,只删直接标识符,等于只锁了前门。
常见误解
误解:删掉姓名、邮箱、证件号就安全了
间接标识符还在,拼起来照样能认出人。处理数据时两类都要清点。
误解:常见的信息不会泄露身份
单项常见,组合起来可能很罕见。年龄、性别、邮编每一项都普通,三项合在一起能缩到很小的范围。
试一下
问卷记录了「每次提交的精确到秒的时间」,它属于哪一类?
答案
间接标识符。精细时间戳可以和别的记录(比如门禁、上网日志)对上。
2. 三个标签,三种承诺
它解决什么问题
别人告诉你「数据已经处理过了」,这句话可能指三种完全不同的状态。有的仍然是个人数据,要按法规保护;有的已经出了法规的范围。
分清三个标签,才知道对方到底承诺了什么,后面该不该保护、退出时能不能删。
从哪来(补充)
GDPR 第 4 条第 5 项给假名化下了定义:处理之后,不借助另外保存、受保护的附加信息,就无法归属到具体的人。出处:GDPR Art. 4。
GDPR 序言第 26 段(Recital 26)说:假名化数据凡是能借附加信息连回某人的,仍算可识别的个人数据;匿名信息不受 GDPR 规制,包括用于统计或研究的匿名信息。出处:GDPR Recital 26。
直觉
- 去标识化(de-identified):宽泛的说法,要追问具体用了什么技术。
- 假名化(pseudonymized):名字换成代码,能把代码连回真人的钥匙另外保存、单独保护。只要钥匙在,它仍是受保护的个人数据。
- 匿名(anonymous):用现实手段已经无法认出是谁。真正匿名的数据才在 GDPR 范围之外。
把名字换成代码能降低风险,但只要还有钥匙或别的现实链接,和人的联系就没断。删名字、给 ID 做哈希、加代码,单靠这些都不能让数据集变成匿名。
一步一步看
目标:给三份「处理过的数据」逐份贴标签,看有没有钥匙、能不能认出人怎样决定它算哪一种。
拿三份「处理过的数据」,逐份贴标签。
-
数据甲:「删了一些个人信息」,没说删了什么。
问题 回答 用了什么技术 不知道 标签 去标识化,要追问 -
数据乙:表里写「用户 X9,年龄 22,城市 Metro City」,保险箱里有一张纸写着「X9 = Leo」。
问题 回答 有没有钥匙 有:保险箱里的对照纸 标签 假名化,仍是个人数据,要保护 -
数据丙:只剩全班睡眠时长的平均值,没有单条记录,也找不到能对照的数据。
问题 回答 用现实手段能不能认出某人 不能 标签 匿名,可以出 GDPR 范围
怎么判断
判断口诀:先问用了什么技术,再问钥匙在不在,最后问用现实手段还能不能连回人。
| 问题 | 回答「是」时的标签 |
|---|---|
| 只说「处理过了」,没说怎么处理? | 去标识化,先追问 |
| 有钥匙或别的现实链接能连回人? | 假名化,仍是个人数据 |
| 用现实手段也认不出是谁? | 匿名 |
意思是:三个标签按「和人的联系断没断」排开,只有彻底断了才叫匿名。
常见误解
误解:去标识化就是匿名
前者只说去掉了一些东西,没说去到什么程度。要问用了什么技术、钥匙在哪、还能不能连回人。
误解:匿名就是「绝对不可能识别」
课件有一处标签写了 impossible,说得过满。课件后面给的标准是考虑现实手段和可预见的发展之后不可识别,这是一次风险评估。
试一下
给学号做了哈希,原始学号已删除,这份数据算匿名吗?
答案
单靠这一步不算。还要看其余字段能不能拼出人、有没有别的数据可以对照。
3. 真正的匿名:放在情境里评估
它解决什么问题
前两节说了:删名字不够,钥匙在就不算匿名。那么钥匙也销毁了、名字也删了,是不是就匿名了?
还不一定。匿名化是一次现实的再识别风险评估,不是删掉显眼标识符这一个动作。这一节讲这次评估怎么做。
从哪来(补充)
Recital 26 说,判断能否识别,要考虑控制者或其他人「合理可能使用的手段」(means reasonably likely to be used),包括单独挑出一人(singling out),还要看识别所需的成本和时间、处理时可得的技术和技术发展。出处:GDPR Recital 26。
直觉
评估时看情境里的六样因素:
- 能不能单独挑出一个人。
- 还有哪些别的数据集可以拿来对照。
- 时间。
- 成本。
- 技术。
- 可预见的发展。
同一条记录,放在不同的情境里结论可能不同。一所学校的官网公开了社团干部名单,另一所没有,同一条「击剑社社长」的记录风险就不一样。所以课件的结论写的是「在这个情境里」不是匿名。
一步一步看
目标:拿一条年龄 20、生物专业、击剑社社长的记录对照学校官网,看它为何在这个情境里不算匿名。
案例:一条「无名」记录写着年龄 20、生物专业、击剑社社长。学校官网公开了击剑社的干部名单。按评估因素逐步判断。
-
能不能单独挑出一个人?击剑社只有一位社长,这个组合很可能只剩一人。
-
有没有其他可得的数据集?有:官网干部页写着社长 Leo,生物专业。
-
在这个情境里算匿名吗?不算:身份被推出来了,仍要当作个人数据保护。
前两步已经够下结论,时间、成本、技术、可预见的发展这几样不用再算:查一下官网几乎不花成本。
怎么判断
判断口诀:站在一个想认出人的人的位置,问他用现实手段做不做得到。
| 因素 | 要问的问题 |
|---|---|
| 单独挑出一人 | 记录的组合会不会只剩一个人? |
| 其他可得数据集 | 有没有公开名单、社交资料能对照? |
| 时间、成本 | 认出这个人要花多少功夫? |
| 技术、可预见的发展 | 现在或可预见的将来,有没有工具能做到? |
意思是:只要其中一样让认出人变得现实,这份数据在这个情境里就不算匿名。
常见误解
误解:匿名是一劳永逸的标签
判断依据会变。今天找不到对照数据,明天公开了一份名单,原来的结论就要重做。
误解:数据里没有直接标识符就算匿名
Leo 那条记录一个直接标识符都没有,照样被认了出来。评估看的是整体组合和外部数据。
试一下
同一条记录,放在一所没有击剑社、也没有公开名单的学校,结论一定一样吗?
答案
不一定。能否单独挑出一人和有没有可对照的数据都变了,要重新评估。
把它们串起来
这一页从上一页留下的问题出发:什么时候数据才算真正匿名,连单条都找不回来?
先清点标识符。直接标识符一眼能认出人,间接标识符要拼起来才认得出,所以光去掉名字不够。
再分清三个标签。去标识化是笼统说法,假名化留着钥匙、仍是个人数据,只有匿名才出 GDPR 范围。
最后是判断方法:匿名要在具体情境里评估,看能不能挑出一个人、有没有可对照的数据、成本时间技术和可预见的发展。
数据认得出人,就落在个人数据保护法规的范围里。GDPR 怎样管这些数据,下一页讲。
课件里的坑
- [措辞过满] p.15 匿名标签写 “Impossible to re-identify using reasonable means”;p.17、p.18 的标准是考虑现实手段和可预见发展之后不可识别,是一次风险评估。答题按 p.17 的说法写,不要写「绝对不可能识别」
- [读图提醒] p.16 保险箱写 X9 = Leo,p.17 写 “Leo” becomes “P-104”:两页是两个独立的例子,代码不同,不是同一份数据
- [拼写] p.16 文字框 “PSEUDOYMIZATION” 应为 PSEUDONYMIZATION,标题拼写是对的
- [排版] p.13 标题 “Direct vs. Indirect Identifiers” 压在漫画上,和漫画标题 THE IDENTIFIER DETECTIVE 重叠;漫画底部横幅后半被文字框挡住
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先默写直接与间接标识符各四个例子、三个标签各承诺什么、匿名评估的六样因素;再对照课件 p.13–18 做课件例题和变式题;最后回查一个易错点:假名化数据算不算个人数据。
必背
- 直接标识符:姓名、邮箱、证件号、人脸、直接指向某人的链接;间接标识符:位置、在线标识、精细时间戳、稀有特征组合;去掉名字不够
- 三个标签三种承诺:de-identified 是宽泛说法要看技术;pseudonymized 有钥匙仍是个人数据;anonymous 才出 GDPR 范围,且要真匿名
- 删名字、哈希 ID、加代码,单靠这些都不能让数据集变成匿名
- 判断匿名要放在具体情境里:同一条记录换了情境、多了一份公开数据,结论就要重做
- 匿名化是情境中的再识别评估:能否单独挑出一人、其他可得数据集、时间、成本、技术、可预见的发展
课件例题
例 1(课件 p.13):标识符侦探
题面:漫画里的表有六列:NAME、EMAIL、ID NUMBER、AGE、ZIP CODE、RARE HOBBY。其中一行是 Jordan T.,34 岁,邮编 94110,爱好修复古董打字机。哪些列是直接标识符,哪些是间接标识符?间接的那几列有什么风险?
提示
哪几列单独一项就能指出是谁?剩下的几列拼在一起呢?
解答
NAME、EMAIL、ID NUMBER 是直接标识符。AGE、ZIP CODE、RARE HOBBY 是间接标识符:单看无害,组合起来可能只剩一个人。课件横幅的意思是间接的碎片能拼起来。
例 2(课件 p.14):去掉名字的数据认出了 Leo
见下方完整例题。
例 3(课件 p.16):秘密钥匙仍然连着人
题面:一张假名化表有五列:User ID、Age、City、Survey Response、Last Login,第一行是 User X9,22 岁,Metro City。旁边的保险箱里锁着一张「X9 = Leo」。这份表算不算匿名数据?
提示
有没有一样东西能把代码连回真人?
解答
不算。只要存在能把数据重新连回真人的钥匙,它仍是个人数据,必须保护。课件文字框的原意是假名化不等于匿名化。另外 Last Login 这样的精细时间戳本身也是间接标识符。
例 4(课件 p.18):「无名」记录的再识别评估
题面:记录写着年龄 20、生物专业、击剑社社长,对照公开资料后只有一个学生符合。这条记录算匿名吗?评估时要看哪些因素?
提示
这一题和 p.14 是同一个案例,这次要答出评估的因素。
解答
在这个情境里不是匿名的,身份被推断出来了。评估要看能不能单独挑出一个人、其他可得的数据集、时间、成本、技术、可预见的发展。匿名化是一次现实的再识别评估,不是删掉显眼标识符这一个动作。完整分析见下方完整例题。
完整例题
课件 p.14 原题:学生研究者 Maya 交出一份「去掉名字的数据」:专业 Biology,年龄 20,社团职务 Fencing Club President。同学打开学校公开网站的击剑社 2024–2025 届干部页,上面写着社长 Leo,生物专业,2026 届。同学说:“Wait, there’s only one fencing president. This data is about Leo!” 请分析隐私是怎样被泄露的,以及 Maya 本该怎么做。
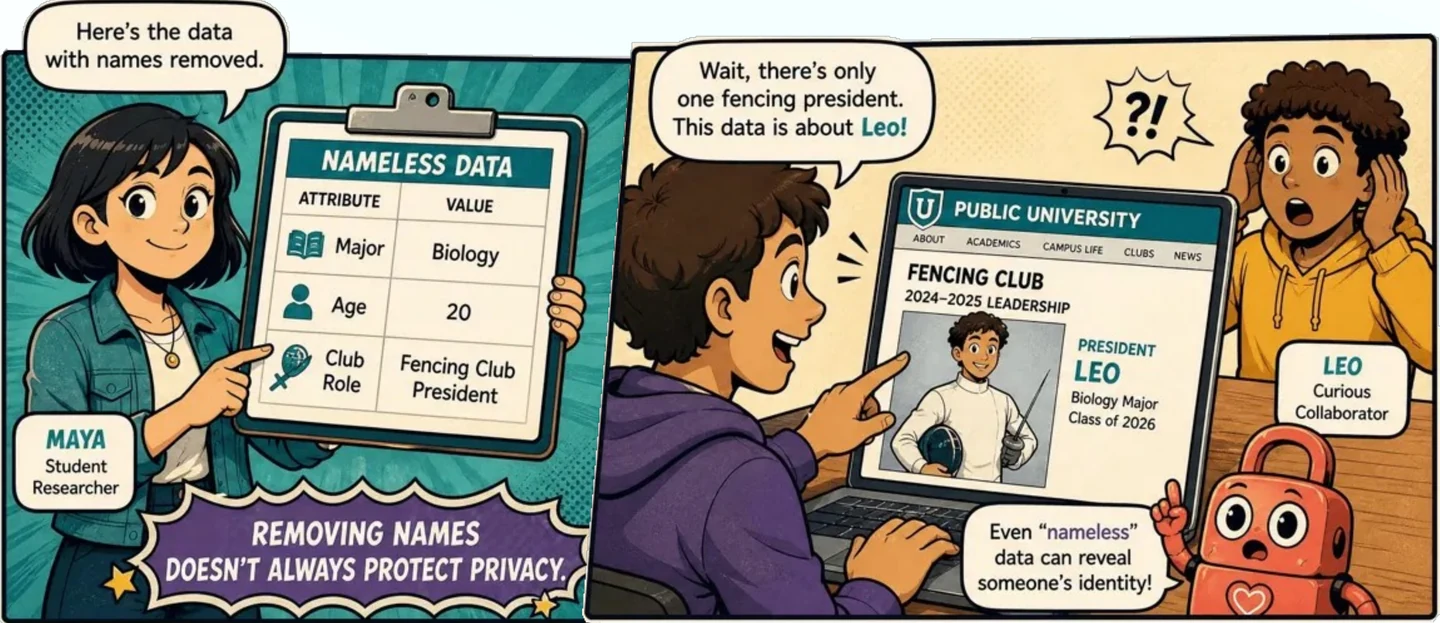
① 清点标识符。数据里没有直接标识符。专业、年龄、社团职务三项都是间接标识符,「击剑社社长」还是罕见特征,一个社团通常只有一位社长。
② 找对照数据。学校官网公开了干部名单,这就是一份「其他可得的数据集」。三项信息和公开页一对,只剩一个人。
③ 判断标签。这份数据只是去掉了名字,最多算去标识化。在这个情境里能单独挑出 Leo,所以不是匿名,仍应当作个人数据处理。
④ 本该怎么做。先按情境评估再识别风险,再减少细节:年龄改成年龄段;「击剑社社长」这种罕见组合删掉,或并成「社团干部」;对外只给汇总统计。这几个做法对应课件后面讲的数据最小化方法。
⑤ 结论。去掉名字不等于匿名。判断要看在这个情境里,用现实手段能不能认出人。
变式题(先自己做)
自编情境:一个小组做「宿舍作息」研究,同意书写「数据收集后立即匿名化,你可以随时要求删除自己的数据」。实际做法是:删掉姓名,把学号换成 S01、S02 这样的代码,对照表存在组长电脑里;保留楼栋、房号、每晚熄灯时间(精确到分钟)。请判断这份数据属于哪个标签,并指出同意书和处理方式各有什么问题。
提示
对照表算不算钥匙?楼栋和房号是哪一类标识符?如果真的匿名了,「随时删除」还做得到吗?
判分点与答案(非官方评分标准)
标签:对照表就是钥匙,这是假名化数据,仍是个人数据,同意书里「立即匿名化」的说法不成立。对照表要单独保护,不能放在个人电脑里随手可得。
标识符:楼栋加房号几乎能直接指到人,精确到分钟的熄灯时间是精细时间戳,都是间接标识符。只换学号远远不够。
同意书:如果以后真的匿名化,「随时删除」就做不到。应写明在匿名化之前可以撤回删除,之后无法定位单条记录。
改进:房号删掉,楼栋按需保留或合并,时间改成时段;评估真正匿名之后再销毁对照表,并如实告知参与者。
闪卡自测
1. 直接和间接标识符各举两个。
直接:姓名、邮箱。间接:位置、精细时间戳(p.13)。
2. Leo 的身份是怎么被推出来的?
专业、年龄、社团职务三个间接标识符,对上学校官网的公开干部页,只有一个人符合(p.14)。
3. 三个标签各承诺了什么?
去标识化:宽泛说法要看技术;假名化:有钥匙,仍是个人数据;匿名:用合理手段无法识别,在 GDPR 范围外(p.15)。
4. 假名化数据还算个人数据吗?
算,只要有钥匙或其他现实的链接能重新关联(p.16–17)。
5. 匿名评估要看哪六样因素?
能否单独挑出一人、其他可得数据集、时间、成本、技术、可预见的发展(p.18)。
下一讲
这一页讲完数据什么时候还认得出人。下一页 L07b-1 讲 GDPR:它管到哪里、七条原则、六种合法依据、有效同意,以及健康数据要过的两道门。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。