L04b-3 公平指标会打架:准确率与群体结果、群体与个体、三族与不可能性
公平指标在模型的优化空间里互相竞争:按分数录取最准却两组差距悬殊,错误率拉平了个人仍可能被误判,三族划分说明为什么不能全部同时达标;含课件 p.26 招生权衡原题。
一句话版
公平指标不能全部同时满足;每选一个,就要说清楚代价落在谁身上,以及群体数字背后有没有被误判的个人。
上一页把三个指标算了出来。这一页讲它们之间的两组冲突,再用三族划分说明冲突的数学根源。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 权衡 | trade-off | 要一样东西,就得让出另一样 |
| 个体公平 | individual fairness | 相似的个体应当得到相似的对待 |
| 阈值 | threshold | 把连续分数切成「是」或「否」的那条线 |
| Independence | 独立性 | 预测与群体归属无关 |
| Separation | 分离性 | 真实标签相同的人里,预测与群体归属无关 |
| Sufficiency | 充分性 | 同一个预测结果在各组含义相同 |
| precision | 精确率 | 被判成正的人里,真的是正的比例 |
一个类比:一条录取分数线
一所学校每年划一条录取分数线。线怎么划,就是这一页的全部问题。
按分数从高到低录,预测最准。可是两组学生的分数分布本来就错开,结果一组录得多、一组录得少。
规定两组录取比例相同,比例拉平了。代价是一些分数更高的人落选。哪种划法都要有人付代价,区别只在付代价的是谁。
再把镜头拉近。就算两组的错误率完全相等,总有一个学生刚好落在线下一点点。她和线上的人几乎没有差别,群体报表看一切正常,对她来说这是一次错误的拒绝。
类比在哪里失效:
- 学校的分数线通常公开。模型的阈值和取舍往往藏在代码里,不写进文档就没人知道当初放弃了什么。
- 分数线只有一条。公平指标有很多个,它们之间的冲突是数学上的,不是划线技巧能解决的。
从零讲起
1. 准确率与群体结果
它解决什么问题
一个模型预测得很准,是不是就没问题了?这一块用课件的招生三格图回答:准确和群体结果可以同时成立,也可以互相冲突。
直觉
课件用一张三圆韦恩图开场,三个圆是 SP、EO、PE。图旁的论题是:公平指标会重叠、交叉,并在模型的优化空间里主动互相竞争。
第一组冲突标在 SP 与 EO 的交集上,叫 Accuracy vs. Fairness。课件的三格图把它讲成一条完整的论证链:
| 格 | 标题 | 发生了什么 |
|---|---|---|
| ① | ACCURACY FIRST | 按分数录取,预测入学后表现的准确率 92% |
| ② | ZOOM OUT | 两组分数分布本来错开,录取率 GROUP A 68%、GROUP B 18% |
| ③ | STATISTICAL PARITY | 拉平录取率,一些高分者落选,整体准确率下降 |
第②格列的四条成因都不在申请人身上:学校资源差距、历史歧视、财富与机会差距、社区与环境因素。黄框写着 UNEQUAL OUTCOMES REFLECT UNEQUAL OPPORTUNITIES, NOT APPLICANT WORTH。
底部标语是 DIFFERENT FAIRNESS GOALS CAN CONFLICT。
一步一步看
目标:把三格图当论证题逐格读,看对 SP 的评价怎样取决于对分数差距成因的前提。
把三格图当成一道论证题,一格一格读。
-
第①格:模型准确地预测了历史上谁读得好。它没有在歧视,它在学历史。
-
第②格:历史数据里两组分数分布错开,成因是四条结构性因素。于是「公平地按分数录」产生了很大的录取率差距。
-
第③格:强制 SP 把录取率拉平。代价有两项:个别分数更高的人落选,整体准确率下降。
-
回到前提:接受第②格那句话,SP 的「忽略 merit」就是纠偏。不接受,SP 就是在惩罚努力。
立场 接受的前提 对 SP 的评价 纠偏派 分数差距反映的是机会差距 忽略 merit 是在纠正历史 绩效派 分数差距反映的是能力差距 忽略 merit 是在惩罚努力
怎么判断
遇到准确率与群体结果的冲突,答题分三步:
- 说出两种政策各自的代价落在谁身上。
- 说出选边依赖的那个前提:差距来自机会还是来自能力。
- 无论选哪边,都要同时报告 EO 或 PE,并把选择和理由写进文档。
课件没有替你选边。考题更可能要求你说清自己依赖什么前提。
常见误解
以为准确率高就说明模型中立
模型准确地复现了历史。历史数据里已经带着分数分布的差距,准确复现也就把这个差距带进了录取结果。
以为韦恩图上的交集是严格的集合关系
准确率与公平的张力对三个指标都成立,课件在 SP 的局限里就列了 Accuracy trade-off。图把议题挂在某个交集上是为了讲解方便。
试一下
一个招聘模型按历史绩效评分排序,整体预测准确率很高,但两组录用率差距很大。公司说:「模型很准,所以是公平的。」用一句话反驳,并说出答题要补的前提。
准确只说明模型复现了历史绩效评分,评分本身若带着机会差距,准确复现就是把差距延续下去。答题要说明:如果认为差距来自机会不平等,就该考虑 SP 并承担准确率代价;如果认为差距来自能力,就要论证评分本身可信。
2. 群体均等与个体均等
它解决什么问题
就算某个群体指标完全达标,具体的某个人还会不会被不公平对待?这一块回答:会,而且群体统计看不见。
从哪来(补充)
个体公平的经典表述来自 Cynthia Dwork 等人的论文 Fairness Through Awareness,2011 年首发于 arXiv。它提出的约束是:相似的个体得到相似的对待。出处:arXiv: Fairness Through Awareness。
直觉
同一张韦恩图换了箭头,指向 EO 与 PE 的交集,叫 Group vs. Individual Parity。课件的说法是:在宽泛群体间拉平错误率,不保证对具体个案的一致公平。
前面所有指标都是群体统计量,比的是两个比率。比率是对一群人求平均,平均值相等不排除平均值底下有个案伤害。
课件的三格图:
| 格 | 标题 | 发生了什么 |
|---|---|---|
| ① | GROUP PARITY | 两组 FPR 都是 8%,看起来相等 |
| ② | ZOOM IN | 一位无辜的申请人站在阈值线上,被模型故障错误标记 |
| ③ | INDIVIDUAL PARITY | 群体层面 Balanced on average,她个人的结果是 FALSE POSITIVE / REJECTED |
技术要害在阈值附近。把连续分数切成二元决定,切点附近有一条脆弱带。两个分数几乎一样的人会落到相反的两边。
一步一步看
目标:拿分数 0.501 和 0.499 的两位申请人对照,看群体指标达标时漏掉了什么、个体公平怎样把它问出来。
拿两位申请人,看群体指标和个体公平各说了什么。
-
两组 FPR 都是 8%,PE 达标。
-
申请人甲分数 0.501,落在阈值 0.5 上方,被标记。申请人乙分数 0.499,落在下方,未被标记。
-
两人其他条件几乎一样,结果相反。
-
群体报表上,这两次决定只是分子里的一个人和分母里的一个人,看不出问题。
-
个体公平问的正是这件事:这两个几乎一样的人,为什么结果不同?
视角 看什么 结论 群体(PE) 两组 FPR 是否相等 相等,达标 个体 相似的人是否被相似对待 甲乙几乎一样,结果相反
怎么判断
一个系统通过了群体公平审计,还要问三句:
- 达标的是哪一个指标?其他指标测了吗?
- 阈值附近有多少人?他们的结果是否稳定?
- 被误判的个人有没有复核和申诉通道?
常见误解
以为两组 FPR 都是 8% 就说明所有群体指标都达标
8% 对 8% 只说明 Predictive Equality 达标。TPR、正预测率是否相等,要另算。
把图里那位申请人的一次误判说成她的错误率是 100%
一次决定不是一个比率。结论是群体统计不能代替个案复核,不是她的错误率有多高。
试一下
一家银行的贷款模型按年龄组审计,两组 TPR、FPR 都相等。一位申请人投诉:她和同事收入、负债几乎一样,同事获批、她被拒。银行回复「模型通过了公平审计」。这个回复缺了什么?
群体指标相等不回答个案问题。银行要查两人的分数是否都在阈值附近、差别来自哪个特征,并提供复核。个体公平问的是相似的人是否得到相似的对待,这一点群体审计测不到。
3. 三族划分与不可能性结论
它解决什么问题
文献里的公平判据名目繁多。课件用一张表把它们归成三族,看第二列就知道谁和谁属于一类、谁和谁可能冲突。
从哪来(补充)
不相容结论出自 Barocas、Hardt、Narayanan 的《Fairness and Machine Learning》分类一章命题 4。条件是:所有事件概率都大于零,且 A 与 Y 不独立(各组基础率不同)。结论是 Separation 与 Sufficiency 不能同时成立。出处:fairmlbook: Classification。
直觉
课件这张表有四列:Name、Closest relative、Note、Reference。价值全在第二列。Note 列的 Equivalent 表示就是这一族的等价写法,Relaxation 表示只要求族条件的一部分。
| 族 | 形式条件 | 直白说法 | 本讲的指标 |
|---|---|---|---|
| Independence | Ŷ ⊥ A | 各组正预测率相同 | Statistical Parity |
| Separation | Ŷ ⊥ A | Y | 真实标签相同的人里,各组错误率相同 | EO、PE 是放松版,Equalized Odds 是等价版 |
| Sufficiency | Y ⊥ A | Ŷ | 预测相同的人里,真实结果分布各组相同 | Predictive parity 等,本讲未展开 |
韦恩图说指标「互相竞争」,数学根源在这里。每加一个公平约束,就在可行解里再切一刀。约束一多,可行解可能为空。
一步一步看
目标:给表里几个指标归族,看只差一个词的 Predictive Equality 和 Predictive Parity 为何分属两族。
拿表里几个名字练习归族,再看两个最容易混的。
-
Statistical parity:第二列是 Independence,Note 是 Equivalent。
-
Equal opportunity:Separation,Relaxation,出处 Hardt、Price、Srebro 2016。
-
Equalized odds:Separation,Equivalent,出处同上。
-
Predictive equality:Separation,Relaxation,出处 Chouldechova 2016。
-
Predictive parity:Sufficiency,Relaxation,出处同样是 Chouldechova 2016。
-
第 4 和第 5 个名字只差一个词,出处相同,族别不同。
名字 比什么 族 Predictive Equality FPR,分母是真实为负的人 Separation Predictive Parity precision,分母是被判为正的人 Sufficiency
怎么判断
拿到一个陌生的公平判据,按两步归族:
- 看竖线右边的条件:只有 A 是 Independence;有 Y 是 Separation;有 Ŷ 是 Sufficiency。
- 看它要求的是族条件的全部还是一部分:全部是 Equivalent,一部分是 Relaxation。
引用不相容结论时,要写全前提。省成「指标总是互斥」是错的。
常见误解
以为不可能性结论说明任何两个公平指标都不能同时满足
结论只涉及 Separation 与 Sufficiency,而且有前提:所有事件概率大于零、各组基础率不同。上一页的完整例题里 EO 和 PE 就同时成立了。
以为 EO 就等于整个 Separation 族
EO 只约束 Y=1 那一半,是放松版。Separation 的等价版是 Equalized Odds,要 Y=1 和 Y=0 两半都满足。
试一下
有人说:「我们的模型在各组的 precision 相同,所以满足了 Predictive Equality。」错在哪?
precision 相同是 Predictive Parity,属 Sufficiency 族,分母是被判为正的人。Predictive Equality 比 FPR,属 Separation 族,分母是真实为负的人。两者是不同的条件。
把它们串起来
上一页的三个指标不是孤立的。它们重叠、交叉,在模型的优化空间里互相争地盘。
第一组冲突是准确率与群体结果。按历史分数挑人最准,两组差距却可能很大;拉平差距,就要付准确率和个别高分者的代价。选哪边,取决于你认为分数差距来自机会还是能力。
第二组冲突是群体与个体。三个指标全是群体统计量,全部达标仍可能有个人在阈值附近被误判。
三族划分给出了根源。Separation 与 Sufficiency 在写全的前提下不能同时成立,所以必须选。下一页讲选的依据是什么、选完之后在哪里修。
课件里的坑
- [读图提醒] p.25 和 p.27 是同一张韦恩图,只是箭头改指:p.25 指准确率与公平,p.27 指群体与个体。p.26、p.28 分别是它们的图解
- [读图提醒] p.26 那张图里 GPA 3.96 出现两次,一次配 SAT 1510 标 ADMIT,一次配 SAT 1540 标 NOT ADMITTED。这是两套政策下的两个人,不是矛盾
- [读图提醒] p.26 第②格横轴写 GPA (UNWEIGHTED) / SAT EQUIVALENT,刻度却是 800 到 1600,那是 SAT 的量程,按 SAT 读
- [读图提醒] p.25 的韦恩图把两个议题挂在两个交集上,不是严格的集合关系
- [术语提醒] Predictive Equality 和 Predictive Parity 只差一个词,族别完全不同;英文作答要写清比较的是 FPR 还是 precision
- [补充] p.29 整页只有一张表,三族的形式条件和不可能性结论都是补充
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先默写 p.26 三格各说了什么、选边依赖哪个前提;再默写三族的形式条件和不可能性结论的前提;然后做课件例题和两道变式题;最后回查 Predictive Equality 与 Predictive Parity 的区别。
下面用于练习,不是官方题型或评分预测。论述题先说清 Ŷ=1 是好事还是坏事,再说代价落在谁身上,最后给出你依赖的前提。
必背
- 准确率与群体结果会冲突:按历史分数挑人最准,两组录取率却可能是 68% 对 18%;强制统计均等会让一些高分者落选、整体准确率下降
- 选边依赖前提:接受「不平等的结果反映的是不平等的机会,不是申请人的价值」,SP 就是纠偏;不接受,SP 就是在惩罚努力
- 群体均等不等于个体均等:两组 FPR 都是 8% 只说明 PE 达标,阈值附近的个人仍可能被误判,群体统计不能代替个案复核
- 三族划分:Independence 要 Ŷ 独立于 A,Separation 要给定 Y 时 Ŷ 独立于 A,Sufficiency 要给定 Ŷ 时 Y 独立于 A
- 补充定理:所有事件概率都大于零且各组基础率不同时,Separation 与 Sufficiency 不能同时成立
- Predictive Equality 比 FPR,属 Separation;Predictive Parity 比 precision,属 Sufficiency;名字只差一个词,族别不同
课件例题
例 1(课件 p.26):准确率 92% 的招生模型,两组录取率 68% 对 18%
题面:见下方完整例题,那里按五步拆解了这道原题。
提示
三格各说了一件事:准确、差距从哪来、拉平的代价。最后一步要说出选边依赖的前提。
解答
要点:第①格准确不等于中立;第②格的差距来自四条结构性因素;第③格拉平录取率要付高分者落选和准确率下降的代价;选边取决于是否接受「结果差距反映机会差距」。完整步骤见完整例题。
例 2(课件 p.28):两组假阳性率都是 8%,一位申请人被错误标记
题面:课件三格图。第一格,两组的 false-positive rate 都是 8%,看起来相等。第二格放大,一位女学生站在阈值线上,模型故障把这位无辜的申请人错误标记了。第三格,群体层面 Balanced on average,她个人的决定却是 FALSE POSITIVE / REJECTED。这组图证明了哪个指标达标?它想说明什么?
提示
FPR 是哪个指标比的量?再想想:一个比率相等,能不能说明比率里的每一个人都被公平对待?注意她站的位置。
解答
两组 FPR 都是 8%,只说明 Predictive Equality 达标。不能推出 TPR、正预测率或其他群体指标也达标。
图要说明群体均等不等于个体均等:平均值相等,不排除平均值底下有个案伤害。她站在阈值附近,分数和线另一边的人几乎一样,结果却相反,这是把连续分数切成二元决定时的脆弱带。
答题边界:不要把她的一次误判说成「她的错误率是 100%」。结论是群体统计不能代替个案复核和申诉机制。
完整例题
课件 p.26 原题:一个招生模型从历史录取档案学习,按分数从高到低录取,预测入学后表现的准确率达到 92%。拉远看,两组申请人的分数分布本来错开,成因列了四条:学校资源差距、历史歧视、财富与机会差距、社区与环境因素。在准确率优先的政策下,录取率是 GROUP A 68%、GROUP B 18%。第三格改用统计均等让两组录取率相等,代价是一些分数更高的人落选,例如 GPA 3.96 / SAT 1540 和 GPA 3.80 / SAT 1460 的申请人,整体准确率也下降。底部标语是 DIFFERENT FAIRNESS GOALS CAN CONFLICT。请分析这三格的论证,并说明选边依赖什么前提。
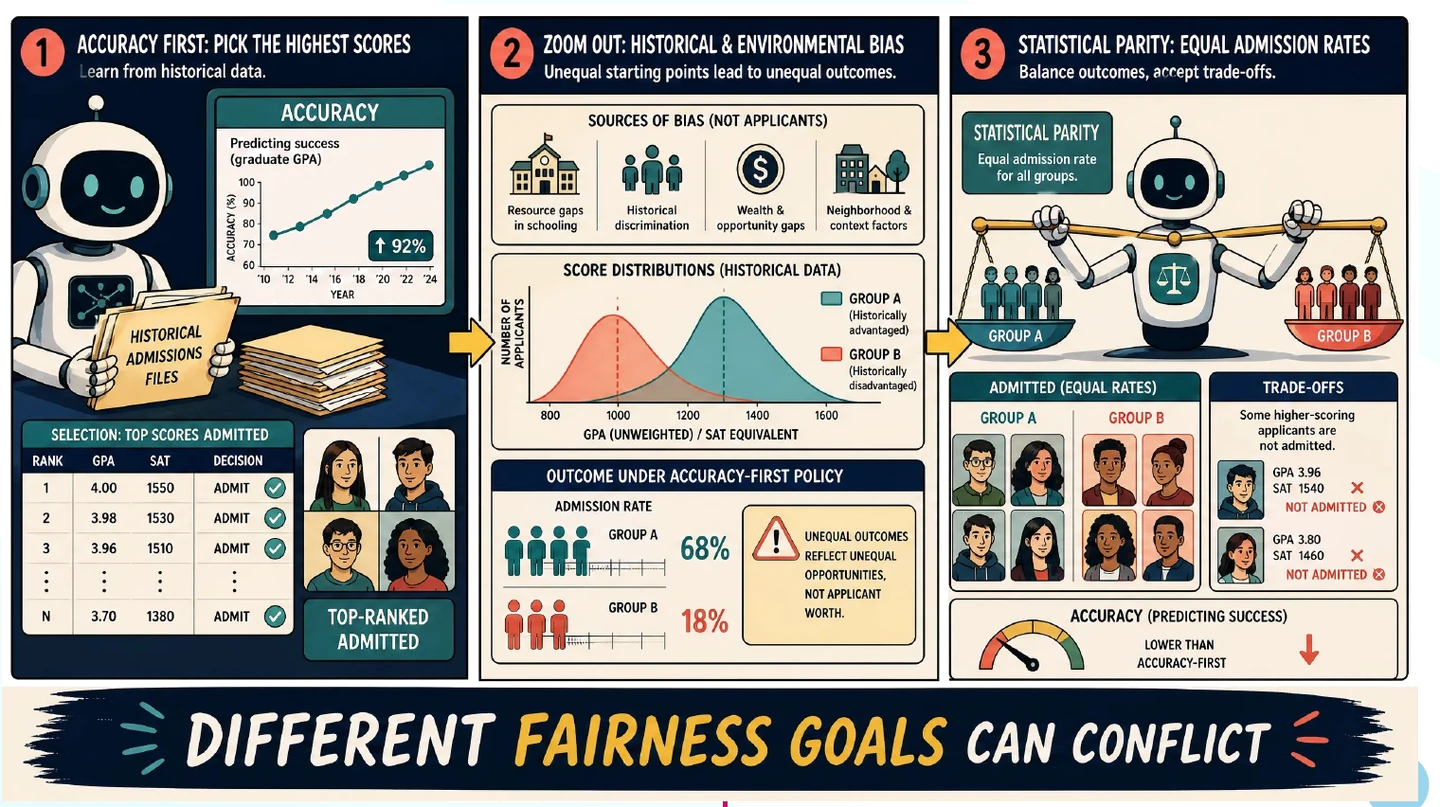
① 第一格不等于中立。模型准确地预测了历史上谁读得好,看起来无可指摘。但它学的是历史数据,历史数据里已经带着分数分布的差距。
② 第二格给出伦理论点。课件写 UNEQUAL OUTCOMES REFLECT UNEQUAL OPPORTUNITIES, NOT APPLICANT WORTH:68% 对 18% 的差距,反映的是机会不平等,不是申请人的价值。四条成因都不是申请人自己的问题。
③ 第三格给出 SP 的代价。录取率拉平了,代价有两项:分数更高的个别申请人落选,整体准确率下降。这正对应 SP 的两条限制:忽略 merit,以及准确率取舍。
④ 选边依赖的前提。接受第②格那句话,SP 的「忽略 merit」就是纠偏;不接受,SP 就是在惩罚努力。课件没有替你选边,答题要写清自己依赖哪个前提。
⑤ 还要补什么。无论选哪边,都应同时报告 EO 或 PE,说明取舍落在谁身上,并把选择和理由写进文档。
答题格式:三格各一句,再写前提,最后一句补充报告与记录。
变式题(先自己做)
变式 1(改编自课件 p.26):上一页完整例题的快速通道数据,两组各 1000 人,TP/FN/FP/TN 分别为 480/120/80/320 和 240/60/140/560,此时 Equalized Odds 达标,正预测率为 0.56 和 0.38。现在要让两组正预测率都等于 0.47:a 组少给 90 个,假设其中 70 个是 TP、20 个是 FP;b 组多给 90 个,假设其中 25 个 Y=1、65 个 Y=0。算出调整后的 TPR、FPR,说明这次调整换来了什么、丢掉了什么。
提示
a 组新的 TP 是 480−70,FP 是 80−20;b 组新的 TP 是 240+25,FP 是 140+65。分母不变:真实为正的人数和真实为负的人数不会因为挪阈值而改变。
判分点与答案(非官方评分标准)
判分点:① 新的 TP、FP 算对;② 分母沿用真实为正、真实为负的人数;③ 说出换来了 SP、丢掉了 Equalized Odds;④ 不把本题当成不可能性定理的证明。
| 正预测率 | TPR | FPR | |
|---|---|---|---|
| a 组(新) | 470/1000 = 0.47 | 410/600 ≈ 0.68 | 60/400 = 0.15 |
| b 组(新) | 470/1000 = 0.47 | 265/300 ≈ 0.88 | 205/700 ≈ 0.29 |
调整满足 SP,却产生 TPR 差 0.20、FPR 差约 0.143,即约 20、14.3 个百分点。换来的是两组正预测率相等,丢掉的是 Equalized Odds。
它展示一种具体权衡,和 p.26 第③格的结构相同。它不是 Separation 与 Sufficiency 定理的证明,因为本题并未以 Sufficiency 为约束。
变式 2(改编自课件 p.27–29):某医院的再入院风险模型,Ŷ=1 表示「高风险,安排随访」。审计报告写:「两组的 precision 相同,所以模型满足 Predictive Equality;而且两组 FPR 都是 0.12,所以每位病人都得到了公平对待。」指出这段话里的两处错误。
提示
第一处是名字和分母对不上。第二处是从群体比率跳到了每一个人。
判分点与答案(非官方评分标准)
判分点:① 指出 precision 相同是 Predictive Parity,属 Sufficiency;② 指出 Predictive Equality 比 FPR,属 Separation;③ 指出群体 FPR 相等不能推出每个人公平;④ 提到阈值附近的个案复核。
第一处:precision 相同是 Predictive Parity,分母是被判为高风险的人,属 Sufficiency 族。Predictive Equality 比的是 FPR,分母是真实不会再入院的人,属 Separation 族。报告把两个族混了。
第二处:两组 FPR 都是 0.12,只说明 PE 在群体层面达标。阈值附近的病人可能因为极小的分数差别被分到不同的随访安排,这是群体统计看不见的。应补充个案复核和申诉渠道。
闪卡自测
1. p.26 三格各说了什么?
①按分数录取,准确率 92%;②分数分布本来错开,录取率 68% 对 18%,成因是四条结构性因素;③拉平录取率,高分者落选、准确率下降(p.26)。
2. SP 与准确率之争,选边依赖什么前提?
是否接受「不平等的结果反映不平等的机会,不是申请人的价值」。接受则 SP 是纠偏,不接受则 SP 是惩罚努力(p.26)。
3. p.25 和 p.27 有什么关系?
同一张韦恩图,箭头指向不同交集。p.25 指 Accuracy vs. Fairness,p.27 指 Group vs. Individual Parity(p.25、p.27)。
4. 两组 FPR 都是 8%,能说明什么、不能说明什么?
只能说明 Predictive Equality 达标。不能说明其他指标达标,也不能说明每个个人都被公平对待(p.28)。
5. 个体公平的经典表述是什么?
相似的个体应当得到相似的对待,出自 Dwork 等人的 Fairness Through Awareness(补充)。
6. 三族各自的形式条件是什么?
Independence:Ŷ ⊥ A。Separation:Ŷ ⊥ A | Y。Sufficiency:Y ⊥ A | Ŷ(p.29;补充)。
7. 不相容结论的前提是什么?
所有事件概率都大于零,且各组基础率不同。此时 Separation 与 Sufficiency 不能同时成立。不要省成「指标总是互斥」(补充)。
8. Predictive Equality 和 Predictive Parity 有什么区别?
Predictive Equality 比 FPR,是 Separation 的放松版;Predictive Parity 比 precision,是 Sufficiency 的放松版。两者在 p.29 出处都是 Chouldechova 2016(p.29)。
下一讲
指标会打架,就必须选。下一页讲选的依据是伤害,偏差从哪进就在哪修,以及怎么把公平检查做成发布门禁:L04b-4。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。