L02 Societal Impact:算法没有中立选项,三支柱用来判它是不是 WMD
算法编码作者的价值;用 Opacity、Scale、Damage 三支柱判定伤害。
一句话版
算法一定会编码写它的人的价值;三支柱用来判它是不是 WMD。
一个类比:家里谁定菜单
课件 p.9 到 p.10 自己给了这个场景。家长每天做饭,孩子吃什么由家长定。家长可以按「有营养」定,也可以按「孩子不闹」定,于是菜单上出现榛子酱。孩子没有投票权,也没人告诉他菜单是怎么定出来的——课件那句 the child never got a vote 就是整讲的题眼。
把角色换一下:家长是写算法的人,孩子是被算法分配机会的公众,菜单是算法本身。家长定「有营养」还是「不闹」,对应的就是算法的成功定义;家里常买什么菜,对应训练数据的取舍;端上桌的那盘,对应模型的输出。三处都要做选择,三处都没有中立的选法。
类比在哪里失效:家里的孩子会长大,会自己下厨,会当场抗议;被算法评分的人往往不知道自己被评了分,更没有第二个厨房可去。家长真心为孩子好,而 p.27 那张表里给营利性大学投广告的模型是故意挑脆弱人群的。最关键的差别在回路——厨房里孩子挑食只是挑食,算法系统会把「被拒绝」记录成「果然不合格」,下一轮拿它当证据,偏见于是被当成事实固化下来(p.11)。
概念卡
1. 三个刻意选择与审查三问
人话定义:算法不会凭空产生价值判断,它只会放大写它的人的。p.8 把这三处选择点名:DEFINITION OF SUCCESS(用什么指标代表「好」)、CURATED DATA(喂什么历史进去)、PREDICTIONS & OUTPUTS(输出什么、给谁看)。
例子:p.15 给出的审查三问是 Who built this(他们自己会不会受这个系统影响)、What is their definition of success、Who is missing from the room。这三问是写作业时套任何场景的开场动作。
常见误解
以为存在「中立的算法」,只要不故意作恶就行 → 三处选择必须做出,不做也是一种做法;课件的说法是危险之处在于我们把算法当成不会犯错的东西来信任,而它犯错是可以预期的(p.16)。
2. 反馈回路与代理变量
人话定义:四个节点首尾相接,自己给自己供料(p.11)。
例子:这一讲唯一有新闻出处的真实案例是亚马逊的招聘工具(路透社,2018 年 10 月 10 日,Jeffrey Dastin)。它用十年的简历训练,学到的是「男性居多的历史就等于成功的样子」,最终被弃用。关键细节:它并没有把性别当作特征。
常见误解
以为把性别、种族这些字段删掉就能消除歧视 → 模型会从代理变量把它学回来:女子学院的名字、某些运动社团、特定措辞。想拆回路,得动成功定义那一层(p.12)。
3. WMD 三支柱
人话定义:WMD 是 Cathy O’Neil 的提法,三个特征是 Secret、Widespread、Harmful,对应三根支柱(p.17、p.18)。
例子:O’Neil 自己的背景是 2008 年金融危机时在对冲基金做量化,这份履历决定了她的判据全部指向「模型上线之后对人做了什么」,而不是模型本身精不精确。
常见误解
把三支柱当成三选一 → 它们是「与」关系。一个透明、只在一家公司内部用、纠错成本可控的模型,即使会出错也不构成 WMD;三条同时成立才是(p.18)。
4. 代理指标错配
人话定义:算法能优化的只有可测量的代理指标,受影响者关心的却是代理指标测不到的那个目标。p.27 那张表把这个错配在五个行业里各演一遍:
| 领域 | 作者定义的成功 | 受影响者真正的目标 |
|---|---|---|
| Teacher Evaluation 教师评估 | 标准化考试分数的提升 | 教学质量得到公平认可 |
| Job Applications 求职申请 | 性格测试的匹配分 | 一个公平的被录用机会 |
| Recidivism Scoring 再犯预测 | 预测再次被捕的概率 | 无偏、准确的风险评估 |
| For-Profit College Ads 营利性大学广告 | 学生报名数即收入 | 真正的职业发展 |
| Credit Scoring 信用评分 | 最小化放贷方违约风险 | 获得公平的金融机会 |
例子:五行的左列都是可测量的代理指标,右列都是难以测量的真实目标。第四行和其余四行有个区别:前者的错配是故意的,广告投放的目标本来就是收入(p.27)。
常见误解
以为换个更准的模型就能修好 → 错配发生在目标定义那一层,模型再准也只是把错的目标测得更准。p.30 给的三条防御 Ask Questions、Demand Audits、Human Oversight 正好各拆一根支柱。
5. 可解释性与伪相关
人话定义:p.39 把解释按受众拆成四类——受影响的个人要的是公平性说明,一线使用者要的是信心,管理层要的是策略依据,外部伙伴要的是问责链条。同一个模型要准备四套说法。
例子:常用工具里 SHAP 算单次预测中每个特征的贡献,PDP 看某个特征整体怎么影响输出,ICE 看它对单个个体的影响(p.40)。医学影像上单靠 saliency map 不够,课件给的补法是用生成式 AI 做反事实——把病灶改掉看模型是否改判,从而查出模型在读背景而不是读病灶(p.42 到 p.45)。
常见误解
以为热力图高亮了就算解释 → 高亮只说明模型看了那一块,说不清它看的是什么特征;p.38 那句 don’t throw models over the wall 提醒的是准确率达标不等于可以交付。
把它们串起来
主线是一句话的展开:the data collected about you determines the opportunities available to you(p.4)。前半讲证明算法必然带价值,中段用 2008 年把三支柱演一遍,后半段回答「那怎么办」。
「怎么办」被拆成三层。个人层是 p.30 的三条防御。制度层是 p.31 到 p.36:课件把当前状态叫 HOLLOW ETHICS,缺的是执照制度与外部审计;职业标准五要素里,EXAMS、CONTINUING EDUCATION、CODE OF CONDUCT、PROFESSIONAL STANDARDS 都能自愿实施,只有 DISCIPLINARY ACTIONS 是承重墙,没有惩戒其余四条都是装饰;课件点名精算师作为已经做到的对照。技术层是 p.37 到 p.46:Humble AI 让模型在没把握时交还给人,Drift Detection 盯分布漂移,Challenger Models 持续挑战现役模型,再配上按受众分层的可解释性。三层都指向同一件事——让模型的判断可以被外部质疑。
课件里的坑
- [课件有误] p.18 三根支柱的标题和正文整体错位:第一栏标题写 WIDESPREAD (Scale),正文描述的却是不透明;第二栏标题写 MYSTERIOUS (Opacity),正文描述的却是规模扩散;底部 HIDDEN 与 GLOBAL 跟随正文含义,但与各自栏标题不符。第三栏 DESTRUCTIVE 正确。背的时候按正文的意思归位
- [文字待核] p.22 的 NEGATIVE EALE、WHEN EQUITY ERIGHTS 等文字难以确认,不能擅自复原成 NEGATIVE SALE;FAILURE: SAFE 的原意也需核实。图意可读为房价下跌、负净值与违约风险,但这不是对模糊原词的订正。
- [口径差异] p.13 把「不被算法歧视」表述为 Constitutional Right → 这是规范性主张,不是对现行法律的陈述,写作业时不要当法条引
- [补充] p.21 与 p.22 是同一张流程图的两个配色版本,绿色是稳定回路、红色是失稳螺旋,不要当成两个不同模型
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先默写三条——三个刻意选择、WMD 三支柱、三条防御各自的适用位置;再把下面的「变式题」做一遍;最后回查两个最容易错的地方——以为删掉敏感字段就消除歧视、把三支柱当成三选一。三步做完再往下看答案。
两份评估都是场景式伦理分析,没有期末考试。Online Quiz 偏向有唯一答案的点:三个刻意选择的英文名、三支柱的对应关系、五要素里哪一条是承重墙。Written Assignment 更可能给一个陌生行业的算法系统,让你判断它是否构成 WMD 并给出改造建议,那时真正要练的是三问加三支柱的套用顺序。
必背
- 数据化把生活变成数据点,关于你的数据决定了你能拿到哪些机会
- 算法必然编码作者的价值,三个刻意选择是 DEFINITION OF SUCCESS、CURATED DATA、PREDICTIONS & OUTPUTS,每一个都没有中立选项
- 审查一个系统的三问:谁建的(他们自己受影响吗)、他们怎么定义成功、谁不在场
- WMD 三个特征是 Secret、Widespread、Harmful;三支柱 Opacity、Scale、Damage 是「与」关系,缺一条就不成立
- 数学没有坏,坏的是底层假设——训练数据只覆盖房价上涨期,模型给全国性同步下跌赋了接近零的概率
- 删掉敏感字段不能消除歧视,模型会从代理变量把它学回来
- 错配的一般形式:算法优化能测量的代理指标,受影响者关心的却是它测不到的那个目标
- 三条防御 Ask Questions、Demand Audits、Human Oversight 可交叉缓解风险;职业标准五要素里惩戒机制是承重墙
完整例题
这门课没有计算题,这一格换成案例判断。题面用课件花了八页解剖的那个案例:2008 年次贷危机里的 CMO 与评级模型(p.19–26),请判断它是否构成 WMD 并给出依据。
① 先确认它是不是算法决策系统:是。风险模型给每一层证券定价并给出评级,评级直接决定谁能买、买多少、以什么利率买,这是标准的机会分配。
② 逐条查三支柱。Opacity:CMO 把不同质量的贷款打包再切成优先级、中间级和权益级三档,还款瀑布层层分配,课件原话是这个过程被反复重复以遮蔽原始风险;p.24 进一步指出当数学复杂到无法被质疑,它就成了完美的欺诈护盾——第一条成立。Scale:p.25 三个词说得很清楚,INDUSTRY STANDARD、HOMOGENEOUS LOGIC、GLOBAL CONTAGION,同一套假设被整个行业采用,于是本该分散的风险变成同时爆——第二条成立。Damage:p.26 给的是 900 万人失业、800 万套房被止赎,加上 p.19 的 22 万亿美元财富蒸发,且损失集中落在家庭一侧,财富由家庭转移到机构,把系统性不平等固化下来——第三条成立。
打包过程课件画成了一张图:
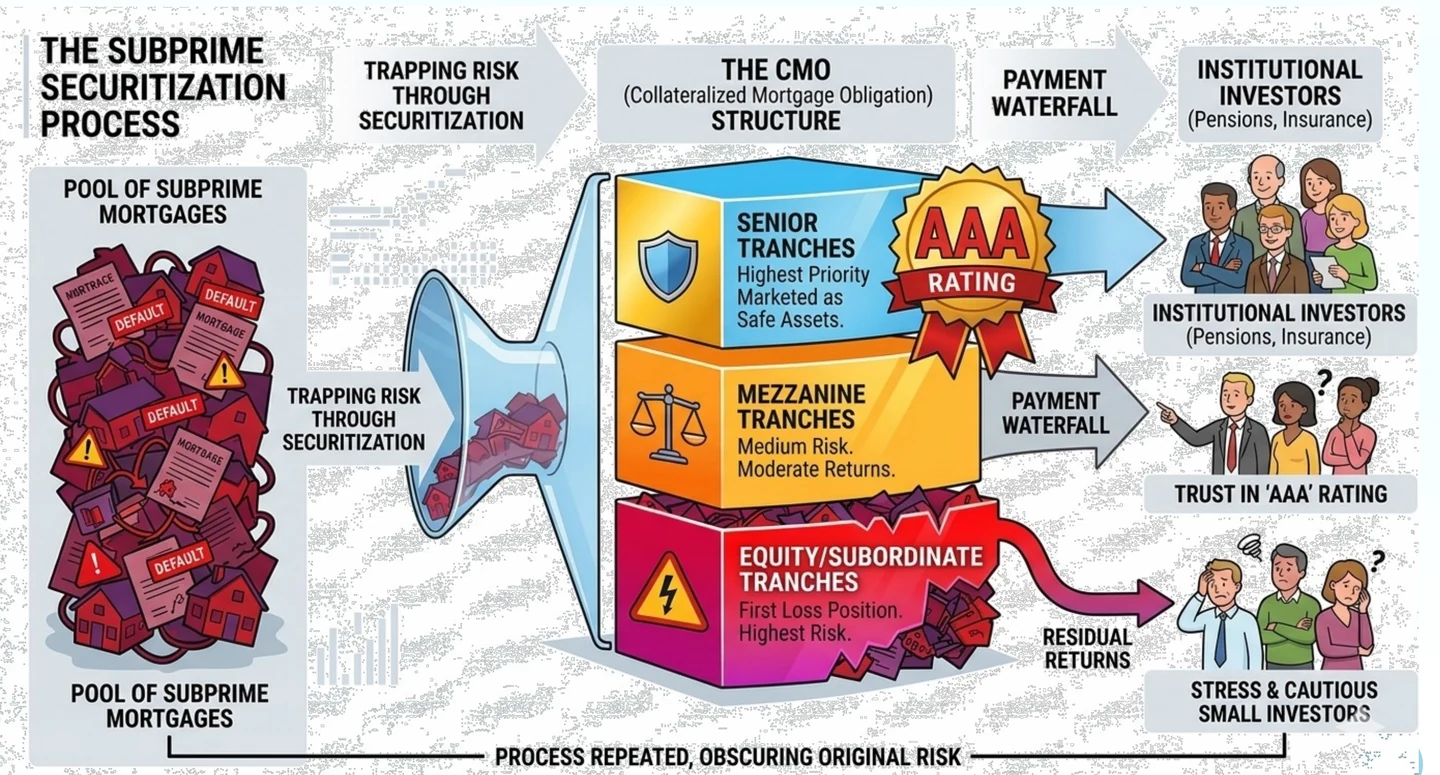
③ 结论:按课件提供的案例描述,三条支柱均有支持,可作为 WMD 分析示例。Historical Myopia 指历史数据和假设未充分覆盖房价下跌风险。这是课程的简化模型批评,不是对 2008 年危机全部成因的证明。
④ 三条防御如何配合:Ask Questions 追问假设和受损者;Demand Audits 独立检验数据覆盖、压力情景与模型风险;Human Oversight 保留质疑、复核与干预权限。它们可相互配合,不能仅凭题面断言某一项最弱或必能阻止危机(p.30)。
变式题(先自己做)
一所大学用「校友捐赠额 + 毕业生起薪」训练招生筛选模型,给每位申请人打分,分数低的在第一轮就被刷掉。分数不对申请人公开,也没有申诉渠道。
(1) 逐条查三支柱,它构成 WMD 吗?(2) 如果这套模型只有这一所学校在用、招生规模每年两百人,结论变不变?
提示
第二问应重新检查规模证据。课件没有给统一人数阈值;不要仅用“两百人”机械判断,也不要把标签判断与危害是否存在混为一谈。
参考答案与自检(非官方评分标准)
自检要点:① 三支柱分别给出证据和缺口;② 若提出反馈回路,要说明成立所需的后续训练条件;③ 单校、两百人不是普遍阈值,应解释规模证据是否充足;④ 不贴 WMD 标签也不代表伦理风险消失。
(1) 现有题面不足以确认三条全成立,需要分别给证据与缺口。
- Opacity:申请人不知道自己被什么打分,也无从申诉,连质疑的入口都没有。
- Scale:题面只说一所大学,未给覆盖人数或推广情况,不能把「可能被跟进」写成已发生的规模扩散。
- Damage:筛选影响申请人的机会;若后续录取群体再用于训练,可能形成反馈回路——偏向家境好的申请人 → 这批人日后起薪高、捐赠多 → 训练数据更”证实”了原有偏好 → 模型更确信。跑得越久越自我印证。
还要点破代理指标:若招生的真实目标是”这个学生适不适合这里”,用的替身却是校友捐赠和起薪。这两项可能受家庭背景影响,不等于学术潜力,属于典型的代理指标错配。
(2) 在本题「单校、每年两百人」的限定下,没有足够证据满足课件强调的广泛规模,不宜直接认定 WMD——三条必须同时成立。但不构成 WMD 不等于没问题:Opacity 和 Damage 仍在,不透明打分加上无申诉渠道,本身就是要修的。把”不是 WMD”读成”可以照常上线”是这道题最主要的失分方式。
闪卡自测
1. 默写数据化那句主张。
The data collected about you determines the opportunities available to you。危害的落点在机会分配这一层,比隐私被看见更实(p.4)。
2. 反馈回路的四个节点按顺序说出来。
Author Defines Success → Algorithm Learns from Past → Biased Outcomes → Bias Reinforced as Truth,然后回到第一步(p.11)。
3. 亚马逊招聘工具的出处、时间和最关键的技术细节是什么?
路透社 2018 年 10 月 10 日,记者 Jeffrey Dastin。最关键的细节是它并未把性别作为输入特征,偏见是通过代理变量学到的(p.12)。
4. WMD 三个英文特征词和三根支柱分别是什么?
特征是 Secret、Widespread、Harmful;支柱是 Opacity、Scale、Damage。三者是「与」关系(p.17、p.18)。
5. CMO 的三档分层叫什么?还款瀑布怎么走?
优先级(senior,评 AAA)、中间级(mezzanine)、权益级(equity)。还款先满足优先级,权益级最先吸收损失,所以同一批贷款能切出「看起来很安全」的一档(p.20)。
6. 用一句话说出 2008 年模型失效的根因。
数学没有坏,坏的是底层假设——模型建立在房价持续上涨的历史上,给全国性同步下跌赋了接近零的概率,课件称之为 Historical Myopia(p.23)。
7. p.26 给出的三类损害数字是什么?为什么损害不算「均匀」?
900 万人失业、800 万套房被止赎,叠加 22 万亿美元财富蒸发。课件认为损害与机会在家庭、机构之间分布不均,结果是系统性不平等被固化,所以不是均匀分摊(p.19、p.26)。
8. 三条防御各对应哪根支柱?
Ask Questions 对应 Opacity(逼系统说明规则),Demand Audits 对应 Scale(外部审计拦住同一逻辑的无限复制),Human Oversight 对应 Damage(在后果落到人身上之前留一个人来兜)(p.30)。
9. 职业标准的五个要素是什么?哪个是承重墙?为什么?
EXAMS、CONTINUING EDUCATION、CODE OF CONDUCT、PROFESSIONAL STANDARDS、DISCIPLINARY ACTIONS。惩戒是承重墙:前四条都可以自愿实施,没有惩戒就没有后果,其余四条会退化成装饰。课件点名精算师作为已建立此类制度的对照(p.34、p.35)。
10. 反事实审计在皮肤病变那个实验里查出了什么?
把病灶区域按反事实方式改动,模型判断随之改变属于合理;把背景改动而判断也跟着变,说明模型学到的是伪相关。实验横向对比了多个现成模型,并把结果与文献列作对照(p.42 到 p.45)。
下一讲
这一讲判的是系统在社会层面造成的伤害,下一讲把镜头拉回到个人——在没人看着的时候,一个数据从业者具体该怎么动手。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。