L01b-2 案例分析四步法:用 Maya 案走完 Consider、Analyze、Review、Evaluate
从零学会场景分析的四步答题结构,再用课件最长的 Maya 案逐步套用:三份匿名数据为什么合起来不安全(拼图效应),一个 2% 的合并错误为什么被三条 Section 各判一次,Maya 最后该怎么做。
一句话版
场景分析题照 Consider → Analyze → Review → Evaluate 四步写;Maya 案把四步完整走一遍,顺带教会你两件事:几份匿名数据合起来能认出人,合规签字不等于伦理过关。
先认识这几个词
这一页会用到上一页的 ACM Code 编号:1 开头是一般原则,2 开头是职业责任,3 开头是领导责任。
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 利益相关方 | stakeholder | 会被这个决定影响到的人或组织 |
| 重新识别 | re-identification | 从「匿名」数据里重新认出具体是谁 |
| 拼图效应 | Mosaic Effect | 几块单看无害的数据拼起来,就能认出一个人 |
| 化名 | pseudonym | 把真名换成一个代号,代号背后还是同一个人 |
| 准标识符 | quasi-identifier | 单独不唯一、组合起来能定位到人的字段,如邮编加生日加性别 |
| 合规 | compliance | 符合法律和规章的要求 |
一个类比:交实验报告前的检查清单
做完实验交报告前,靠谱的同学会按一张清单过一遍:实验对象是什么、测到了什么、还缺哪组数据;结果支持哪个结论、哪些数据最关键;如果换一种做法结果会不会不同;这份报告的结论以后别人会怎么引用。
四步法就是伦理案例的这张清单。它不替你得出结论,只保证你没漏掉该问的问题。最容易漏的两个,就像实验报告里的「还缺哪组数据」和「换一种做法会怎样」,大多数人不写,写了就拉开差距。
类比在哪里失效:
- 实验报告的数据可以重做;伦理案例里,你往往只能在信息不全的情况下判断。
- 实验报告最后只要结论对;伦理分析还要说清楚对谁好、对谁不好。
- 实验报告的清单是给自己用的,四步法的最后一步要想到这个决定会成为别人的先例。
从零讲起
1. 案例分析四步法
它解决什么问题
场景题最常见的失分方式是复述案情,或者直接甩一个「不道德」。四步法给你一个固定的答题结构,每步配两到三个必问的问题,照着写,分析的骨架自然就齐了。
直觉
四步各问什么:
- Consider(了解):涉及哪些行动者与利益相关方?预期的和可观察到的影响是什么?还缺哪些信息?
- Analyze(分析):哪些权利(法律的、自然的、社会的)受影响?哪些技术事实最相关?Code 的哪些原则最适用?
- Review(回顾):哪些责任、职权、惯例或政策影响了选择?有哪些替代行动?
- Evaluate(评价):这个决定会怎样成为未来同类案件的先例?哪些行动维护或违反了 Code?是否正当?
一步一步看
目标:用 Maya 案把四步完整走一遍,看最后落到哪三个动作上。
拿 Maya 案把四步完整走一遍。案情:Maya 是一家城市规划非营利组织的数据科学家,要分析身体健康与空气污染、通勤习惯的相关性;她交叉引用三份「匿名」数据,合规委员会签字放行;后来发现连接算法有缺陷,经理要她照样上线。
-
Consider:谁受影响,还缺什么信息。滑板车用户、社区居民、组织本身都受影响;还缺分组错误率和结论的下游用途。
-
Analyze:哪些权利受影响,哪条 Code 适用。隐私权受拼图效应威胁,对应 1.6;错误的健康结论造成伤害,对应 1.2。
-
Review:谁在施压,有哪些替代行动。施压的是经理的「低优先级」标签;替代行动是说清局限、找同行评审、按公共利益升级。
-
Evaluate:会立下什么先例,是否正当。照样上线会让「合规签字就算安全」成为先例,违反 2.1 与 3.1。
四步走完,结论落在三个动作上:说清楚、找外人评审、以公共利益为准。
怎么判断
判断一份分析写没写到位:四段齐全,并且第一段写了「还缺什么信息」,第三段写了至少一条两个极端之外的替代行动。
| 检查项 | 没写到的样子 | 写到的样子 |
|---|---|---|
| 还缺哪些信息 | 直接下结论 | 列出要先查清的两三件事 |
| 有哪些替代行动 | 只有「照做」和「辞职」 | 至少还有一条建设性的做法 |
意思是:这两问是区分「复述案情」和「做了分析」的分水岭。
常见误解
误解:四步法是给一个标准答案的流程
四步法只保证该问的问题都问到了。它和 ACM Code 一样,不是算法,结论还要你自己权衡。
误解:替代行动就是「照做」或「辞职」二选一
两个极端之外通常还有很多路:书面说明局限、请人评审、向上一级反映、暂停部分功能。课件 Maya 案的结论就是三条建设性的动作。
试一下
只用一句话写出这个场景的 Consider:学校要用学生的校园卡刷卡记录预测谁可能挂科。
答案
行动者是学校和做模型的团队,利益相关方是学生,尤其是被预测为「会挂科」的那批;还缺的信息是学生知不知道、预测结果会被拿去做什么、误判的人会怎样。
2. 合规签字不等于伦理过关
它解决什么问题
Maya 案里有一个看起来很稳的环节:合规委员会签字批准了。很多人到这里就停了。这个概念说明为什么签字之后还要再问一次。
直觉
合规委员会的逻辑是:「每份数据集都合法且匿名,所以把它们合起来完全安全。」
这句话前半句是法律判断,后半句是伦理判断,中间没有推理。这正是第一页「不能把道德外包给法典」的教科书式反例。
一步一步看
目标:把合规委员会那句话拆成前提和结论,看推理在哪一步断掉。
把合规委员会那句话拆开检查。
-
拆出前提。
前提 性质 每份数据集都合法 法律判断 每份数据集都匿名 对单份数据的技术判断 -
拆出结论。
结论 性质 合起来完全安全 对合并结果的伦理判断 -
检查前提能不能推出结论。
问题 回答 单份合法,合并后一定合法吗 不一定,合并会产生新信息 单份匿名,合并后一定匿名吗 不一定,这就是下一个概念的拼图效应
三步走完,推理断在第三步:合法性不能逐份相加。
怎么判断
判断口诀:看到「每一份都……所以合起来……」,就要检查合并之后有没有长出新东西。
意思是:答题时如果只写「三份数据合起来会泄露隐私」,只答了一半;另一半是「合规签字不构成伦理背书」。
常见误解
误解:合规委员会签了字,责任就不在 Maya 身上了
签字说明它大概率不违法,这是地板那一层。Maya 作为做分析的人,仍要回答天花板那一层的问题。
试一下
有人说:「这三个第三方接口单独调用都在条款允许范围内,所以把它们的数据合到一个用户画像里也没问题。」指出这句话的跳步。
答案
跳步在「单独允许」到「合起来没问题」之间。合并会产生新信息,比如认出具体的人,单份条款管不到这一步;还要单独判断合并后的伦理影响。
3. 拼图效应:行为模式本身就是身份
它解决什么问题
Maya 已经清除了所有直接姓名与账号 ID,换成随机化的用户哈希。她以为这就是匿名了。这个概念解释为什么还不够。
直觉
把不同来源的数据合并,可能导致重新识别,哪怕每一份单独看都是「匿名」的。课件把它画成三层叠加:
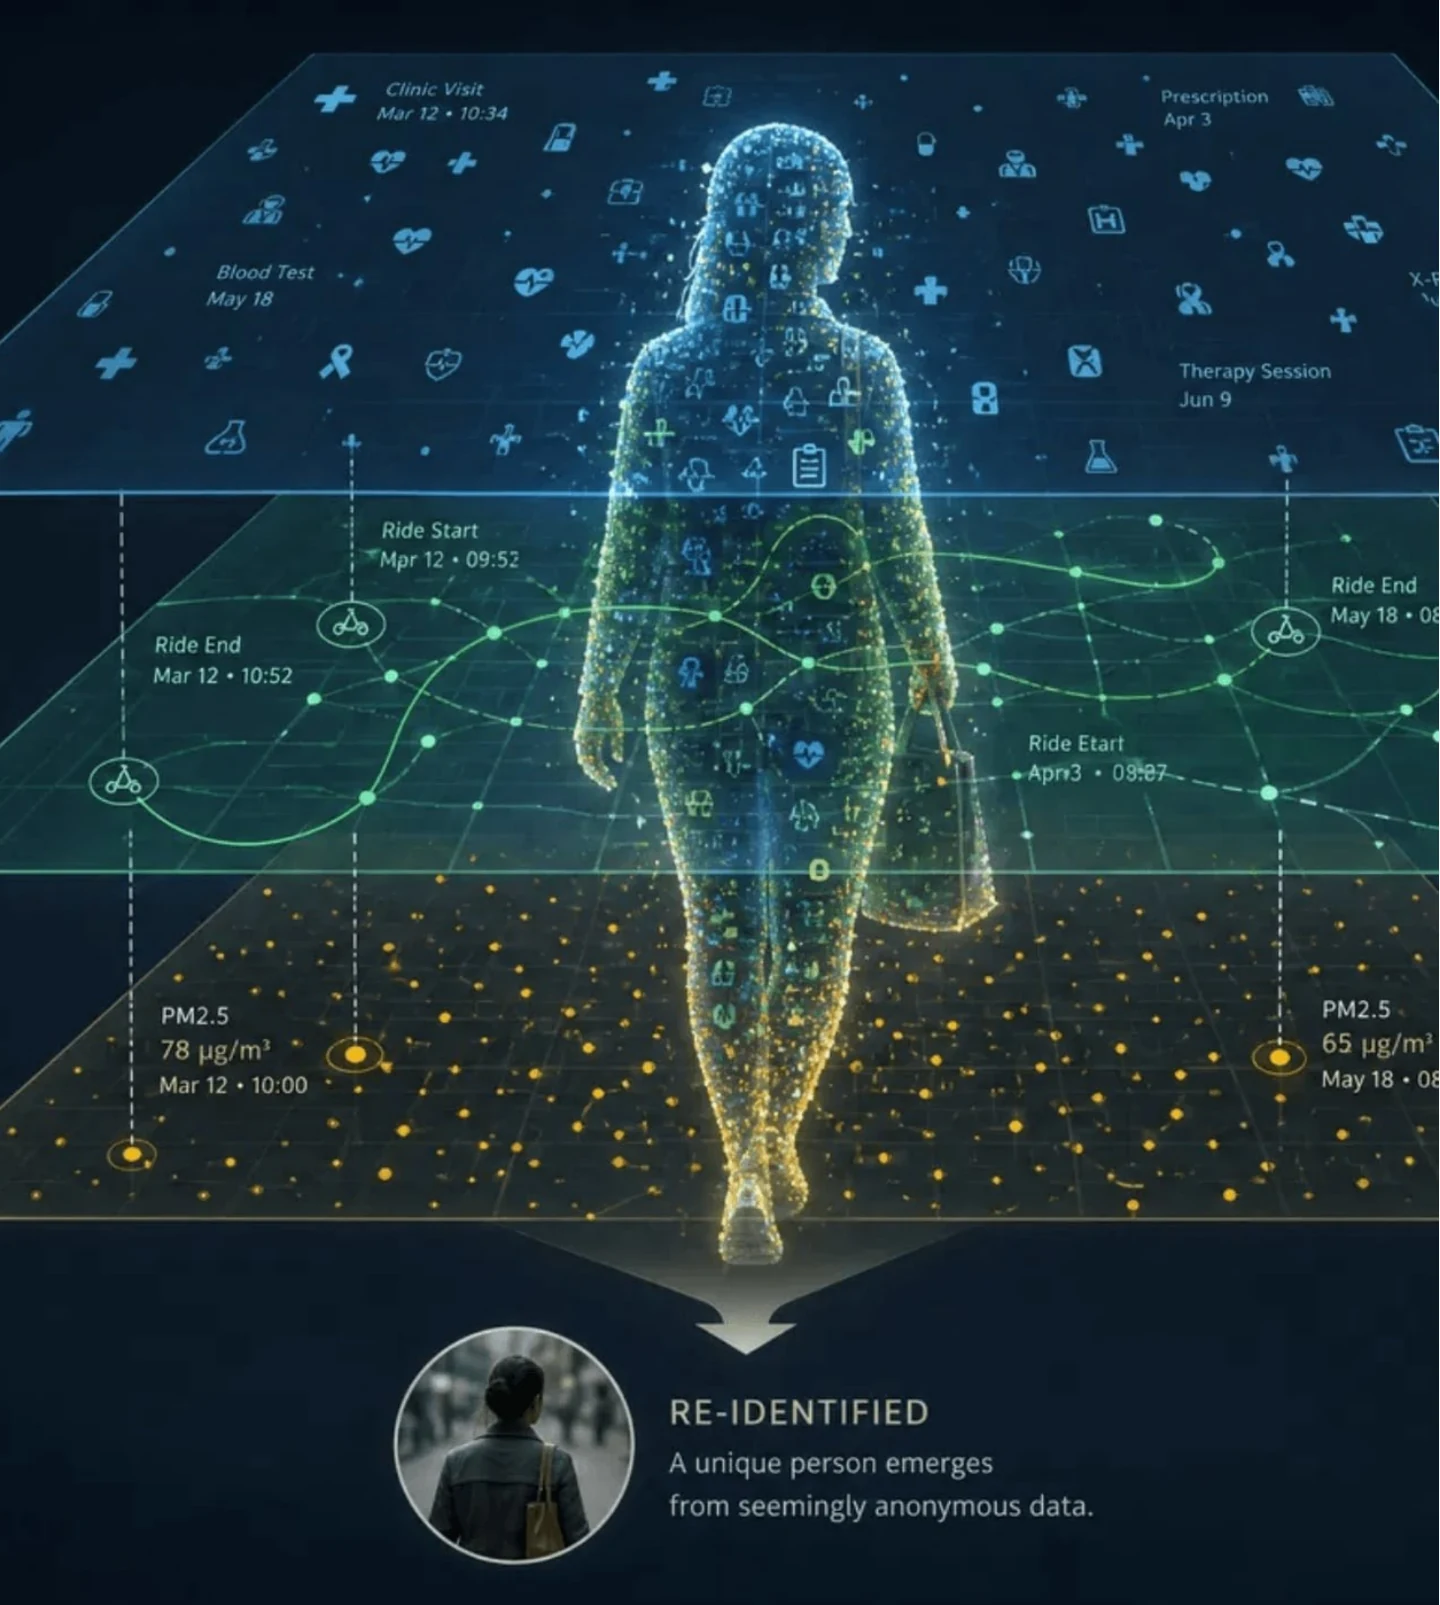
一句话说清机制:去掉身份字段不等于去掉身份,因为行为模式本身就是身份。
一步一步看
目标:用一个虚构通勤者把数据一层层叠上去,看匿名数据怎样拼出一个具体的人。
用一个虚构的通勤者走一遍拼图。
-
只看出行数据。
能看到什么 能认出是谁吗 一个哈希代号,每天早上同一时间从同一个坐标出发 还不能,只知道有这么一个人 -
加上医疗数据。
能看到什么 能认出是谁吗 每月同一天,同一家诊所附近有一次就诊记录 范围大大缩小 -
把两层叠起来。
能看到什么 能认出是谁吗 出发点(多半是家)加上固定的就诊时间 在城市尺度上,往往只对应一个人 -
再叠上空气质量数据,健康信息和住址被绑在一起。
结果 意思 RE-IDENTIFIED 一个具体的人从看似匿名的数据里浮现出来,敏感健康信息暴露
四步走完,Maya 的工作在不经意间用看似安全的数据造出了一个高风险的监控工具。对应的条款是 Section 1.6(Respect Privacy)。
怎么判断
判断一份数据是不是真匿名:问「能不能被重新识别」,不问「删没删姓名」。
意思是:匿名化的强度不由字段决定,由重识别的可能性决定。保留了通勤路线这类独特的行为模式,清除姓名就不够。
常见误解
误解:换成随机哈希就是匿名化
随机哈希只是化名。课件把它叫作 quasi-identifiers,用词不准:准标识符是单独不唯一、组合起来能定位到人的字段。这个用词恰好点出了问题所在,Maya 以为自己做的是匿名化,实际做的只是化名化。
误解:数据是公开的,就可以随便合并
上一页说过,数据「公开」不等于不经同意使用它合乎伦理。拼图效应说明,公开数据拼起来同样能认出人。
试一下
一份数据只有三列:邮编、出生日期、性别,没有姓名。它算不算匿名?
答案
不能直接算。这三个字段正是准标识符的经典例子,单独都不唯一,组合起来往往能定位到人。要看能不能被重新识别。
4. 一件事三层条款,以及升级路径
它解决什么问题
Maya 案升级了:连接算法把不同通勤者合并成同一画像,错误率 2%;经理标成低优先级,要求照样上线。这个概念教你两件事:同一件事怎么被不同层级的条款各判一次,以及 Code 给出的对策长什么样。
直觉
三件事,三个层级:
| 事件 | 违反的条款 | 层级 |
|---|---|---|
| 推送被污染的数据导致错误的健康结论 | 1.2 Avoid Harm | 后果层 |
| 经理把 bug 标为「低优先级」,速度压过质量 | 2.1 High Quality | 手艺层 |
| 无视数据完整性,未把公共利益放首位 | 3.1 Public Good | 领导层 |
这就是上一页说的「往往需要同时考虑好几条原则」的实例。
一步一步看
目标:先检查经理「错误率只有 2%」的辩解再给对策,看总体误差率为何证明不了无害。
先检查经理的辩解,再给出对策。
-
检查「错误率只有 2%」。
问题 回答 总体 2% 能证明风险可接受吗 不能,没说明错误落在谁身上 课件给了分组错误率吗 没有,不能断言误差已经集中在某个社区 -
列出该追问的事。
追问 为什么 错合并是否集中于相似路线或特定人群 低误差率不等于无害,关键是误差落在谁身上 错误会怎样影响规划决策 要评估下游后果 -
给出对策:三个动作,各挂一条 Section。
行动 条款 对系统的局限与潜在问题保持透明 1.3 Honesty 推动 GitHub 同行评审 2.4 Review 把公共利益置于经理的「低优先级」标签之上 3.1 Public Good
三步走完,对策的形状很清楚:说清楚、找外人看、换判断依据。
怎么判断
判断一个对策合不合 Code:它是不是建设性的、留痕的、可被复核的。
意思是:先内部升级、要求评审、留下书面记录,比「辞职」或「直接捅给媒体」更符合 Code。课件把这一页叫 Integrity vs. Authority(正直 vs 权威),它是四个场景共同的形状:上级或朋友要你别说,答案都是职业义务高于服从。
常见误解
误解:Code 要求你直接违抗上级
Code 给的是升级路径。Maya 的三个动作都在体制内留痕、可复核,没有撂挑子。
误解:已经知道误差集中在某个社区
课件只给了总体 2%,没给分组错误率。误差是否集中在某些人群身上,是需要验证的风险假设,不是已知事实。
试一下
经理说:「这个模型准确率很高,个别出错没关系。」用一句话追问。
答案
出错的是哪些人?如果错误集中在某一群人身上,对他们来说准确率并不高,而且要评估这些错误会带来什么后果。
把它们串起来
四步法是答题的骨架:Consider 找人和缺的信息,Analyze 找权利、技术事实和条款,Review 找压力和替代行动,Evaluate 找先例和正当性。
Maya 案把骨架填满了。Analyze 那一步里有两个陷阱:合规签字是法律判断,不能直接推出伦理结论;化名化的数据拼在一起,能把人重新认出来。数据质量那一层,一个总体 2% 的错误被三条不同层级的条款各判一次。
最后的对策是整讲的落点:正直对权威时,走留痕的升级路径。前面的病人、Alex、Sarah、Elena,到这里的 Maya,都是同一个形状。
课件里的坑
- [课件有误] p.38 把随机化的用户哈希称作 quasi-identifiers,用词不准。准标识符指单独不唯一、组合起来能定位到人的字段,随机哈希只是化名
- [口径提醒] p.41 没有给出分组错误率,不能断言误差已经集中在某个社区;这是待验证的风险假设
- [读图提醒] p.40 三层叠加的配图把机制画得最清楚,文字层只有结论
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先默写三条:四步法的顺序和每步必问的问题、Mosaic Effect 的机制、Maya 的三个动作各挂哪条 Section;再把下面的「变式题」做一遍;最后回查两个最容易错的地方:把合规签字当成伦理背书、把总体错误率低当成无害。
Written Assignment 是场景分析,四步法就是现成的答题结构,照 Consider → Analyze → Review → Evaluate 分四段写。背结论没用,要练把框架套到陌生场景上的手感。
必背
- 案例分析四步 Consider → Analyze → Review → Evaluate;最容易漏的两问是还缺哪些信息、有哪些替代行动
- Maya 案的核心谬误:合规委员会用法律标准(每份都合法)得出伦理结论(所以安全);合法性不能逐份相加
- Mosaic Effect:去掉身份字段不等于去掉身份,行为模式本身就是身份
- 总体 2% 错误率不能单独证明质量合格;需核查分组分布与下游后果,不能把误差集中于某群体当作已知事实
- 同一件事被三条不同层级的条款各判一次:1.2 后果层 / 2.1 手艺层 / 3.1 领导层
- Code 给的是升级路径而非违抗:说清楚(1.3)、找外人评审(2.4)、以公共利益为准(3.1)
课件例题
例 1(课件 p.38–42):Maya 的城市规划项目,三份匿名数据和一个合并错误
见下方完整例题。
例 2(课件 p.36–37):四步法每一步要问什么
题面:课件给出案例分析的四个步骤,每步配两到三个问题。请按顺序写出四步的名称和各自要问的问题,并指出最容易被跳过的两问。
提示
四个英文词的首字母依次是 C、A、R、E。最容易漏的两问,一个在第一步,一个在第三步。
解答
Consider:涉及哪些行动者与利益相关方;对他们预期的和可观察到的影响;还缺哪些信息。
Analyze:哪些权利(法律的、自然的、社会的)受影响、程度如何;哪些技术事实最相关;Code 的哪些原则最适用。
Review:哪些责任、职权、惯例或政策影响了选择;有哪些替代行动。
Evaluate:这个决定如何成为未来同类案件的先例;哪些行动维护或违反了 Code;考虑到所有利益相关方,这些行动是否正当。
最容易被跳过的是「还缺哪些信息」和「有哪些替代行动」。
例 3(课件 p.39–40):合规委员会为什么放行,拼图效应又是什么
题面:合规委员会批准了 Maya 的项目,理由是每份数据集都合法且匿名,所以合起来完全安全。课件下一页给出 Mosaic Effect。请指出合规委员会的逻辑错在哪,并用一句话说清拼图效应的机制和对应的 Section。
提示
先分清前提是哪一类判断、结论是哪一类判断。再想清除姓名之后,还有什么信息留在数据里。
解答
合规委员会用法律标准(每份都合法)得出伦理结论(所以完全安全),两者之间没有推理,合法性不能逐份相加。
拼图效应:把不同来源的数据合并可能导致重新识别,哪怕每份单独看都是匿名的;把位置数据和医疗记录连起来会暴露敏感的健康信息。保留了通勤路线这类独特的行为模式,清除姓名就不够。对应 Section 1.6(Respect Privacy)。
例 4(课件 p.41):明知有 bug 还要上线,违反了哪几条
题面:连接算法把不同通勤者合并成同一个画像,错误率 2%。经理把它标为低优先级,理由是目标只是看大趋势,并要求 Maya 照样上线。请列出三件事各违反哪条 Section,并说明它们分别在什么层面。
提示
三件事是:发现、反应、命令。三条编号的第一位分别是 1、2、3。
解答
The Discovery:明知推送被污染的数据会导致错误的健康结论、造成系统性伤害,对应 Section 1.2(Avoid Harm),后果层。
The Reaction:把速度置于追求高质量的职业义务之上,对应 Section 2.1(High Quality),手艺层。
The Order:无视数据完整性问题,未把公共利益作为首要考量,对应 Section 3.1(Public Good),领导层。
另外,总体 2% 错误率不足以证明风险可接受,课件没有给分组错误率,应追问错误落在谁身上。
完整例题
课件 p.38–42 原题:Maya 是一家城市规划非营利组织的数据科学家,要分析身体健康与社区空气污染、日常通勤习惯的相关性。她用了三份「匿名」数据:本地泛化后的呼吸系统体检记录、某电动滑板车与共享单车 App 的匿名化坐标、社区级雾霾与颗粒物传感器的公开数据。她清除了姓名与账号 ID,换成随机用户哈希。合规委员会签字放行,理由是每份数据都合法且匿名,所以合起来完全安全。后来她发现连接算法把不同通勤者合并成同一个画像,错误率 2%;经理把这个 bug 标为低优先级,说目标只是看大趋势,要她照样上线。请用四步法给出完整分析与结论。
① Consider(了解):行动者是 Maya、她所在的城市规划非营利组织、合规委员会、她的经理;利益相关方是三份数据背后的居民,尤其是被合并进同一画像的那批通勤者。可观察的影响是一份用于城市规划决策的相关性分析,预期之外的影响是一个高风险的监控工具。还缺的信息:三份数据各自的使用边界写了什么、居民在原始采集时同意的用途是什么、那 2% 的合并错误落在谁身上。
② Analyze(分析):受影响的权利是隐私与不被错误分类的权利。关键技术事实有两条:随机哈希只去掉了直接标识,通勤路线这类行为模式被完整保留;连接算法把不同通勤者合并成同一画像,错误率 2%。适用的条款按层级分:1.6 Respect Privacy 管重新识别,1.2 Avoid Harm 管推送被污染的数据造成的系统性伤害,2.1 High Quality 管把速度置于质量之上,3.1 Public Good 管未把公共利益作为首要考量。
③ Review(回顾):影响选择的是合规委员会的签字和经理把 bug 标为低优先级这两项授权。替代行动不止「照做」和「辞职」两个:可以先把局限与潜在问题写成书面说明,可以推动 GitHub 同行评审,可以要求把公共利益而非低优先级标签作为判断依据。
④ Evaluate(评价):合规委员会的逻辑有一个硬伤:每份数据合法是法律判断,合起来完全安全是伦理判断,两者之间没有推理。经理的辩解也站不住:总体 2% 没说明错误落在谁身上,还要评估它对规划决策的后果。结论:Maya 不应照原样上线。她的三个动作各挂一条 Section:保持透明对应 1.3 Honesty,推动同行评审对应 2.4 Review,把公共利益置于经理的标签之上对应 3.1 Public Good(p.42)。这三个动作都是建设性的、留痕的、可被复核的,比「辞职」或「直接捅给媒体」更符合 Code。
变式题(先自己做)
自编情境:外卖平台要上线「骑手疲劳度预测」。数据是骑手手机的运动传感器记录,同意书里写的用途是导航与路线优化。疲劳分高的骑手会被系统自动减少派单,产品经理说这是为了保护骑手,但骑手收入按单结算。模型误判率 8%,且对传感器精度较低的旧手机用户误判更高。法务确认「数据都是自家采集的,没有法律风险(这是题设人物的主张,并非本笔记的法律结论)」。请用四步法走一遍并给结论。
提示
四步里最容易写空的是第三步。先别急着下结论,把「除了照做和拒绝之外还能做什么」列出来两三条。另外注意法务那句话的逻辑形状,和 Maya 案里合规委员会那句很像。
判分点与答案(非官方评分标准)
判分点:① 每条判断都要挂 Section 编号,不要只写「不道德」而缺少论证;② 第三步必须给出两个极端之外的替代行动;③ 要点破法务那句话的跳步:合法不等于合乎伦理,这是本讲反复考的形状。
① Consider:行动者是算法团队、产品经理、法务;利益相关方是骑手,尤其是用旧手机那批。可观察影响是派单量下降,预期之外的影响是收入下降。缺的信息:8% 误判具体落在谁身上、骑手知不知道自己被打分、有没有申诉渠道。
② Analyze:二次使用需核查原许可是否覆盖疲劳推断,对应 1.6 Privacy;减少派单可能降低疲劳风险,也会减少收入,需评估净影响,对应 1.2 Avoid Harm;旧手机用户误判更高,对应 1.4 Fairness。题面已给群体差异,不能说完全没有分组评估;应追问分组指标、样本量与验证质量,对应 2.5 Evaluation / 2.1 Quality。
③ Review:替代行动至少三条:把分数改成给骑手自己看的提示,不直接自动减单;按机型分组重测并公布差异;把「保护骑手」这个目标交给骑手一方确认,不由产品经理单方定义。
④ Evaluate:法务那句话的跳步和 Maya 案里合规委员会一模一样:自家采集只是数据来源事实,并不足以证明合法;即使合法,用于另一个目的且影响收入是伦理判断,两者之间没有推理。结论:不应按现状上线。团队应把已知局限书面留痕(1.3 Honesty)、推动同行评审(2.4 Review)、把骑手的实际利益作为判断依据,不停在「保护」这个说法上(3.1 Public Good)。
闪卡自测
1. 用一句话说清 Mosaic Effect 的机制。
把不同来源的数据合并可能导致重新识别,哪怕每份单独看都是匿名的;去掉身份字段不等于去掉身份,独特的行为模式(比如通勤路线)本身就是身份(p.40)。
2. p.41 里同一件事被哪三条 Section 各判一次?分别在什么层面?
1.2 Avoid Harm 管后果层(推送被污染的数据会导致错误的健康结论),2.1 High Quality 管手艺层(把速度置于追求高质量的职业义务之上),3.1 Public Good 管领导层(未把公共利益作为首要考量)(p.41)。
3. 经理说错误率只有 2%、目标只是看大趋势,这个辩解为什么站不住?
总体 2% 错误率并未说明错误落在哪些人身上。相似路线、时段或社区是否更容易被错合并,是需要分组检验的风险假设,不是课件已给出的事实。还应评估错误对规划决策的后果(p.41)。
4. Maya 为保护匿名做了哪两件事?为什么还不够?
清除所有直接姓名与账号 ID,替换成随机化的用户哈希。这只是化名化,通勤路线这类行为模式还在,三份数据一合并就能重新识别(p.38、p.40)。
5. p.42 的标题是什么?Maya 的三个动作各挂哪条 Section?
Integrity vs. Authority(正直 vs 权威)。保持透明对应 1.3 Honesty,推动同行评审对应 2.4 Review,把公共利益置于经理的标签之上对应 3.1 Public Good(p.42)。
下一讲
第一讲到这里结束。L02a-1 接着 Maya 案留下的那个问题往下走:误差率低不等于无害,关键是误差落在谁身上。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。