L08a VR 正常操作:2f+1 台机器,主节点排号,过半确认
只会宕机、不会撒谎的机器怎样保持副本一致:先补状态机复制,再推出 2f+1 台、等 f+1 个回应和多数集交集,最后一帧一帧跑一遍 VR 正常操作的四条消息。
一句话版
一份数据存在好几台机器上,只要每台都从同一个起点出发、按同一个顺序执行同样的操作,它们就始终一样。VR(视图戳复制)让一台主节点给每个操作排号,等过半的机器确认记下了,才执行并回复客户端。
这一页只讲没人出故障时的正常操作,以及背后的门槛为什么是「过半」。主节点崩溃后怎么换届、崩溃的机器怎么回来,见下一页 L08a-2。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 崩溃故障 | crash fault | 机器只会停下来不说话,不会发假消息 |
| f | 读「f」,failures | 最多允许几台机器同时崩溃 |
| 法定人数 | quorum | 做一个决定至少要凑齐的回应数,这里是过半 |
| 状态机复制 | state machine replication | 同一初始状态、同样顺序执行确定性操作,各副本结果一样 |
| VR | Viewstamped Replication,视图戳复制 | 主节点定顺序、副本照抄的复制协议 |
| 主节点 / 副本 | primary / replica | 负责排号的那台 / 跟着记账的其余几台 |
| 视图 | view,视图号记作 v | 「谁当主节点」的一个任期,换主节点就换视图 |
一个类比:四家分行的值班经理
一家银行有四个分行,每笔转账都要四家记成一模一样的账。
VR 的做法像排值班。本周由一分行当值班经理,所有客户的请求都先到它那里。它给每笔转账编个流水号,通知其他分行「第 8 笔是 Alice 转给 Bob 的这一笔」。
只要过半的分行回了「记下了」,值班经理就办理,并告诉客户办好了。没凑够过半之前,它不办、也不回话。
为什么是过半?下一任值班经理上任时,要从过半的分行那里把账本收上来。两拨过半的人至少有一个重叠,旧经理定下的每一笔,新经理都问得到。
类比在哪里失效:
- 真实分行能打电话确认对方倒闭没有。协议里的节点只能靠超时去猜,猜错了也不能出错。
- 值班经理的「通知」像开会。协议里每一步都只是发消息、数回应。
从零讲起
1. 先补一块:状态机复制(补充)
它解决什么问题
一台机器会坏。把同一份数据复制到几台机器上,坏一台还有别的。麻烦在于几份副本怎么保证始终一样。
状态机复制给出的回答很朴素:大家从同一个状态出发,按同一个顺序,执行同一串操作。只要这三条都满足,结果自然一样。剩下的难题只有一个,就是让所有人对「顺序」达成一致。VR 和后面的 Paxos 都在解这个难题。
从哪来(补充)
这套思路由 Leslie Lamport 在 1984 年的论文里提出,Fred Schneider 1990 年在 ACM Computing Surveys 上写了一篇系统的教程。它要求状态机是确定性的:同一个状态、同一个输入,永远得到同一个结果。
出处:Wikipedia: State machine replication
直觉
把每份副本想成一个只会照单执行的会计。你给两个会计同一本空账、同一张操作单,他们算出的余额一定相同。
要是一个会计先做第 3 条再做第 1 条,就可能算出不同的数。所以「同一个顺序」比「同一批操作」更要紧。
一步一步看
目标:看两份副本执行同样三条操作、只是顺序不同时,结果会不会一样。
下面两份副本拿到同样三条操作,只是排序不同。
-
两份副本都从 x = 0、y = 0 出发,初始状态相同。
-
副本甲按 set x = 5、set y = 7、set x = 9 的顺序执行。
-
副本乙把 set x = 9 排到最前,把 set x = 5 排到最后。
-
执行完,甲的 x 是 9,乙的 x 是 5,两份副本不一样了。
y 两边都是 7,因为 y 只被改了一次,顺序影响不到它。x 被改了两次,谁排后面谁说了算。
怎么判断
判断一组副本会不会始终一致,逐条问三个问题:
- 初始状态一样吗?
- 每条操作是确定性的吗?同一状态、同一输入,结果唯一。
- 所有副本执行的顺序一样吗?
意思是:三个问题都答「是」,副本就一致;有一个答「否」,就可能分叉。实际系统里前两条容易做到,第三条要靠协议保证,所以 VR 的主节点要给每条操作编全局序号。
常见误解
以为只要每份副本都收到了全部操作,结果就一样
收全了还不够,顺序也要一样。上面的例子里两份副本收到的操作一模一样,只因为两条 set x 的先后不同,最后 x 就差了。
以为操作里带「取当前时间」「取随机数」也没关系
这类操作不是确定性的,两台机器各自执行会得到不同结果,状态机复制的前提就破了。要么由主节点先算出确定的值再分发,要么不放进复制的操作里。
试一下
三条操作 set x = 1、set x = 2、set y = 3。副本甲按这个顺序执行,副本乙把前两条对调。两份副本最后的 x、y 各是多少?
甲:x = 2、y = 3。乙:先 set x = 2 再 set x = 1,x = 1、y = 3。y 一样,x 不一样,副本已经分叉。
2. 2f+1 台机器、等 f+1 个回应
它解决什么问题
有了「同一顺序」的目标,下一个问题是:要几台机器,每做一个决定要等几台回应?
等得太少,会有两拨人各自做了矛盾的决定,彼此不知道。等得太多,坏几台机器就凑不够人,系统停住。VR 的答案是:要容忍 f 台崩溃,就用 2f+1 台,每次等 f+1 台。
从哪来(补充)
「一次操作至少要拿到几票」这个想法叫 quorum,基于 quorum 的副本控制来自 David Gifford 1979 年的论文「Weighted voting for replicated data」。它的规则之一是写票数要超过总票数的一半,这样任意两次写都会撞到同一台机器。
出处:Wikipedia: Quorum (distributed computing)
直觉
崩溃的机器只会沉默。有 f 台可能不回话,那么等的人数最多只能是「总数减 f」,否则坏 f 台就永远等不齐。
另一头,等的人数要超过半数,两拨人才一定有重叠。有重叠,后来的人就能从重叠的那台问到之前的决定。
2f+1 台、等 f+1 台,正好同时满足两头:f+1 就是总数减 f,又恰好过半。
一步一步看
目标:看两拨过半的人为什么一定撞上同一台机器,人数不过半时又会怎样。
拿 5 个节点(f = 2)和 4 个节点两种情况对照。
-
5 个节点,过半是 3。旧主节点在 Q₁ = {P₁, P₂, P₃} 里定下了一条操作。
-
换届后新主节点凑到 Q₂ = {P₃, P₄, P₅},也是 3 个,也过半。
-
Q₁ 和 Q₂ 一共 6 个名额,只有 5 个节点,必有一个被用了两次,这里是 P₃。新主节点从 P₃ 那里得知旧操作。
-
再看 4 个节点、只等 2 个的情况:{P, R1} 和 {R2, R3} 各 2 个,交集是空的。两拨人可以各自做出矛盾的决定。
所以 4 个节点要等 3 个,按「超过半数」算,不能直接套 f+1。
怎么算
两个法定人数各有 f+1 个节点,合起来:
(f+1) + (f+1) = 2f + 2 > 2f + 1
意思是:两组人数加起来比节点总数还多一个,鸽子比笼子多,至少有一个节点同时在两组里。这就是「任意两个多数集必有交集」。
一般地,N 个节点的过半门槛是 ⌊N/2⌋ + 1。N = 2f + 1 时,⌊(2f+1)/2⌋ + 1 = f + 1,两种写法一致。N = 4 时,⌊4/2⌋ + 1 = 3。
能容忍几台崩溃,看剩下的还够不够门槛:总数 2f+1 减去崩溃的 f 台,剩 f+1 台,刚好够。
常见误解
节点数是 4 时,按 f = 1 等 2 个回应就够
f+1 的公式默认节点数是 2f+1。4 个节点里两组 2 个可以完全不相交,必须按「超过半数」等 3 个。
交集里有一个节点,任何故障模型下都够用
这只在崩溃故障下成立,交集里那个节点会如实报告它记下的操作。会撒谎的节点可能恰好站在交集里,那时就要更大的法定人数。
试一下
7 个节点,要容忍几台崩溃?每次等几个回应?任意两组法定人数至少重叠几个?
7 = 2 × 3 + 1,f = 3,每次等 f+1 = 4 个。两组各 4 个,4 + 4 = 8,比 7 多 1,至少重叠 1 个。
3. VR 正常操作:四条消息
它解决什么问题
前两个概念说了「要同一顺序」和「要过半确认」。VR 正常操作把这两件事落成具体的消息:谁来排顺序,什么时候算记下了,什么时候能告诉客户端成功。
VR 一共有三个子协议:正常操作、view change(换主节点)、副本恢复(崩溃的机器回来)。这一页只讲第一个。
从哪来(补充)
VR 由 Brian Oki 和 Barbara Liskov 在 1988 年的 PODC 会议上首次发表,比 Paxos 正式成文还早。
出处:Wikipedia: Paxos (computer science);论文 DOI
直觉
所有请求只进主节点一个门,排号这件事就只有一个人在做,不会两个人排出两种顺序。
主节点排完号先不执行,要等过半的人说「记下了」。这样它就算下一秒崩溃,这条操作也已经留在过半的机器上,新主节点一定能找回来。
一步一步看
目标:看一条请求在 VR 里经过哪几条消息,主节点凑够几个回应才执行并回复客户端。
用分行转账的场景跑一遍。Alice 是客户端,Branch-I 是主节点,Branch-II、Branch-III 是副本,3 台机器,f = 1。每一帧里近黑的箭头是这一步的消息,灰色的是前面已经走完的步骤。
-
Alice 把请求 ⟨request op, c, s, v⟩ 发给主节点。op 是操作,c 是客户端编号,s 是 Alice 自己给请求编的号,v 是她所知的视图号。
-
主节点给这条请求分配全局操作号 n,记进自己的日志,再把 ⟨prepare m, v, n⟩ 发给所有副本。m 是请求本身。
-
副本按顺序记下这条操作,回 ⟨prepareok v, n, i⟩,i 是副本自己的编号。主节点数回应:自己算一个,再加一个副本,就是 f+1 = 2,够了。
-
凑够之后,主节点执行操作,用 ⟨reply v, s, x⟩ 回复 Alice,x 是执行结果。接着通知副本执行。
怎么判断
主节点在第 3 步问自己一句:记下这条操作的机器,算上自己,有没有 f+1 台?
意思是:有,就可以执行并回复;没有,就继续等,绝不提前回复。f = 1 时要 2 台,f = 2 时要 3 台。
s 和 n 容易混。s 是客户端自己的计数,Alice 的第几个请求;n 是主节点排的全局序号,全系统第几个操作。不同客户端的 s 会重复,n 不会。
常见误解
主节点可以先回复客户端,再慢慢同步副本
顺序不能反。先回复再复制,主节点此刻崩溃,新主节点根本不知道这个操作,客户端拿到的「成功」就作废了。
副本坏了一台也要换主节点
只要剩下的机器加上主节点还够 f+1,正常操作照常进行,不需要 view change。换届只在主节点本身失联时发生。
试一下
5 台机器跑 VR,主节点发出 prepare 后,有 2 个副本回了 prepareok。主节点能回复客户端吗?
5 = 2 × 2 + 1,f = 2,要 f+1 = 3 台。主节点自己 1 台加 2 个副本,一共 3 台,够了,可以执行并回复。
把它们串起来
上一讲讨论的是会撒谎的节点,代价是更多机器和大量消息。这一讲退回到只会宕机的节点,门槛降到 2f+1。
状态机复制把「副本一致」化成「顺序一致」。VR 把排序权交给一个主节点,所有请求都从它那里拿号。
过半确认是安全的来源。主节点等到 f+1 台记下才回复,这条操作就留在了过半的机器上。任意两个过半集合有交集,换届时新主节点必能找回它。
还有一条边界。VR 管同一份数据的多份副本按同样顺序执行。3PC 管不同服务对一笔交易一起提交或一起放弃。两件事不能互相替代。
课件里的坑
- [适用条件] p.17 Exercise 1 有 4 个节点,f+1 公式不直接适用,按过半应等 3 个回应(p.17)。
- [页码说明] 课堂批注版比原版多 3 页,分别插在原版 p.19、p.29、p.42 之后。本页写「批注版 p.N」的按批注版计,其余页码按原版。
- [历史口径] p.4 写 Paxos 1988 首次提出。常见说法是 1989 年首次投稿、1998 年正式发表,答题写 1998 年正式发表不会错(p.4)。
课后 10 分钟:考点复习
这 10 分钟怎么用:先合上页面,默写 VR 四条消息的格式和各字段的意思;再用鸽笼的说法把交集论证讲一遍;然后做完整例题,最后做变式题。
必背
- VR:2f+1 个副本容忍 f 个崩溃,法定人数 f+1 含主节点;只崩溃不作恶
- VR 正常操作四阶段:⟨request op,c,s,v⟩ → ⟨prepare m,v,n⟩ → ⟨prepareok v,n,i⟩ → ⟨reply v,s,x⟩
- 任意两个多数集至少共享一个节点:(f+1)+(f+1) > 2f+1,这是 VR 和 Paxos 安全性的共同来源
- VR 三个子协议:正常操作、view change、副本恢复
- 3PC 解决原子提交(不同服务一起提交或放弃),VR 解决副本一致与操作排序,VR 单独不能做原子提交
- 节点数不是 2f+1 时按「超过半数」算门槛:4 个节点要等 3 个回应
课件例题
例 1(课件 p.9、p.11):分行转账里的 VR 角色
Alice 向 Bob 转 100 港币,四家分行一起记账,请求先到 Branch-I。谁是客户端、主节点、副本?复制的是什么?
提示
请求先到哪台,哪台就负责排号。
解答
Alice 是客户端,Branch-I 是主节点,Branch-II、III、IV 是副本,复制的是交易状态。
例 2(课件 p.17,Exercise 1):Replica 2 崩溃时的正常操作
见下方完整例题。
例 3(课件 p.19):为什么要过半
5 个节点,旧领导者在 {P₁, P₂, P₃} 里定下了操作,新领导者凑到 {P₃, P₄, P₅}。新领导者怎么知道旧操作?
提示
找两组共有的那个节点。
解答
两个过半集合必有交集,这里是 P₃。P₃ 把自己接受过的操作交上来,新领导者就不会漏掉。
老师批注:法定人数是 ⌊N/2⌋+1,N 为 5 时是 3,也就是 f+1;Q₂ 旁写着「with a view change」,指换届后新领导者凑的那一组(批注版 p.19)。
例 4(课件 p.20):3PC 和 VR 各管什么
例 A:一笔交易要同时给 Alice 扣款、给商户加款、把商品标为已售,三件事在三个不同的库里。例 B:副本要对 set x = 5、set y = 7、set x = 9 达成一致。各该用哪个协议?
提示
先分清是「几件不同的事要一起成败」,还是「同一份数据要排出同一个顺序」。
解答
例 A 是原子提交,要收集各服务的投票再统一 COMMIT 或 ABORT,用 3PC,VR 单独做不了。例 B 是副本一致与排序,用 VR;某副本若把 set x = 9 排在 set x = 5 前面,它的 x 最后是 5,和别人不一样。
完整例题
题面:Primary 加 Replica 1、2、3 共 4 个节点跑 VR,Replica 2 一开始就崩溃。写出一次请求的四个阶段,并回答 Primary 要等几个回应(含自己)。(课件 p.17,Exercise 1)
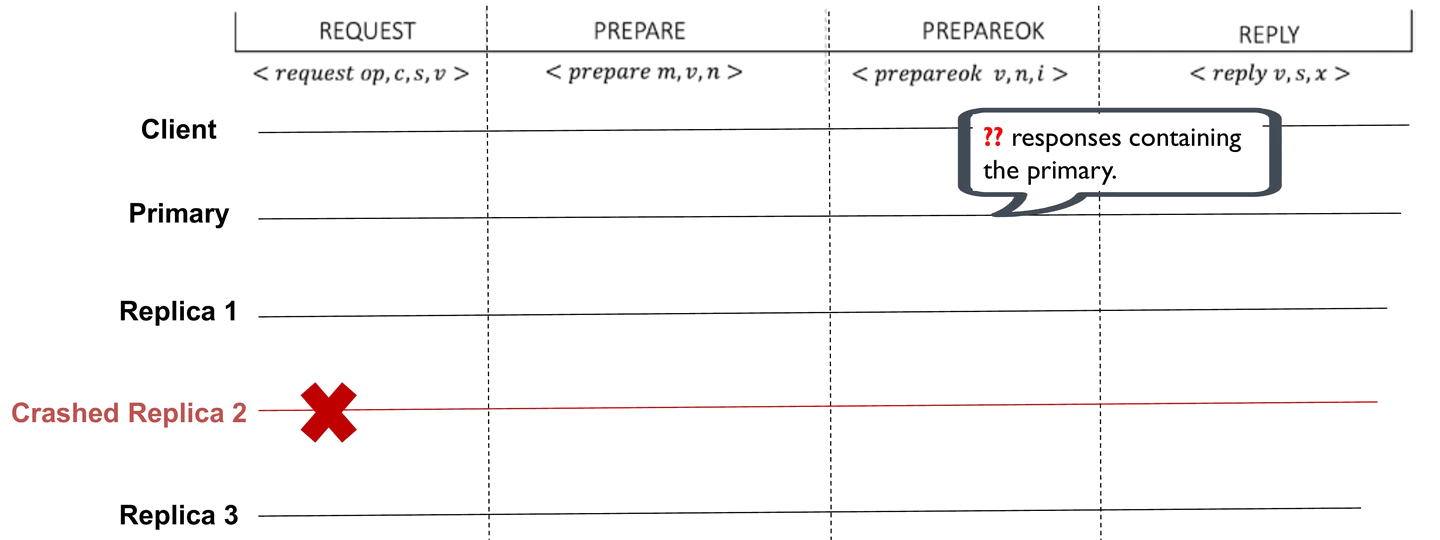
约定:崩溃的节点不回任何消息;「回应」把 Primary 自己算一个。
解法:
- Client 发 request 给 Primary。
- Primary 给 Replica 1、2、3 发 prepare。Replica 2 已崩溃,没有回应。
- Replica 1、3 回 prepareok。Primary 数一下:自己 + Replica 1 + Replica 3 = 3 个。
- 4 个节点的过半是 ⌊4/2⌋ + 1 = 3,够了。Primary 执行并回 reply 给 Client。
- 只等 2 个为什么不行:{Primary, R1} 和 {R2, R3} 各 2 个,交集为空,两组可以各自做出矛盾的决定。
- 只崩了副本,主节点还在,不触发 view change。
要点:门槛按「超过半数」算,4 个节点等 3 个。老师课上在这页写了 f=1,问号处填的也是 3(批注版 p.17)。
答题格式:先列四个阶段的消息,再写门槛的算式,最后用一句交集论证说明为什么不能只等 2 个。
变式题(先自己做)
(1) 5 个节点跑 VR,主节点是 R1,R4、R5 都已崩溃。正常操作时 R1 要等几个回应(含自己)?够不够?(改编自课件 p.17)
提示
先算 5 个节点的过半是几,再数崩溃后还剩几台。
判分点与答案(非官方评分标准)
5 = 2 × 2 + 1,f = 2,过半是 3。R1 要等自己加 R2、R3 共 3 个回应,正好够,正常操作可以继续。再坏一台就不够了。
(2) 3 台机器跑 VR,主节点发出 prepare 后两个副本都没回应。主节点该怎么做?(自编情境)
提示
数一下记下操作的机器有几台,再和 f+1 比。
判分点与答案(非官方评分标准)
3 = 2 × 1 + 1,f = 1,要 2 台。只有主节点自己 1 台,不够,不执行、不回复客户端,继续等。等不到时系统停住,但不会给出错误的成功。
(3) 有人说「VR 已经能保证副本一致,所以跨库转账也用 VR 就行」。指出问题。(改编自课件 p.20)
提示
跨库转账里的几件事是不是同一份数据?
判分点与答案(非官方评分标准)
跨库转账是几个不同服务对一笔交易一起提交或一起放弃,属于原子提交,要用 3PC 这类协议收集投票。VR 只保证同一份数据的副本按同一顺序执行,单独解决不了。
闪卡自测
1. VR 的三个子协议是什么?
正常操作、view change、副本恢复(p.10)。
2. 状态机复制需要什么前提?
所有副本从同一初始状态出发,操作是确定性的,再按同样顺序执行(p.10)。
3. VR 里 s 和 n 有什么区别?
s 是客户端给请求编的号,n 是主节点分配的全局操作号(p.12)。
4. 要容忍 f 台崩溃,VR 需要几台机器、每次等几个回应?
2f+1 台,等 f+1 个,含主节点自己(p.19)。
5. 为什么任意两个多数集必有交集?
两组各 f+1 个,合起来 2f+2 个,比总数 2f+1 多一个(p.19)。
6. 为什么 VR 单独解决不了跨三个服务的转账交易?
那是原子提交问题,要统一 COMMIT 或 ABORT;VR 管的是同一份数据的复制和排序(p.20)。
7. 为什么交集论证只在崩溃故障下成立?
交集里那个节点要如实报告自己接受过的操作;会撒谎的节点可能就站在交集里(p.19)。
8. 4 个节点跑 VR,主节点要等几个回应?
3 个。4 个节点的过半是 3,只等 2 个时两组可以不相交(p.17)。
下一讲
下一页是 L08a-2 VR 换届与恢复:主节点崩溃后,新主节点怎样从过半的日志里拼回已经提交的操作。带着问题读:k 为什么取「多数都完成的最新号」,而不取最长那份日志的号?
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。