L08a 图数据:节点、边、邻接矩阵和三类任务
社交网络、三维网格、分子都是图:节点数不定,每个节点的邻居数不定。这一页讲怎么把一张图写成邻接矩阵、度矩阵和特征矩阵,加自环得到 Ã 和 D̃,再认清图上的三类任务。
一句话版
图由节点和边组成,每个节点带一串特征。把「谁和谁相连」写成邻接矩阵 A,把「每个节点有几个邻居」写成度矩阵 D,把特征一行一行摞成 X,图就变成了几张能做矩阵乘法的表。
这一讲的后几页都在这几张表上做运算,这一页先把表写对。
先认识这几个词
读之前最好记得矩阵乘法的规则,不熟可以先看 P01a。
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 图 | graph | 一些点和连接它们的线 |
| 节点 / 边 | node / edge | 图里的点 / 两个点之间的连线 |
| 邻接矩阵 A | adjacency matrix | 记录哪两个节点相连的 0/1 表 |
| 度 | degree | 一个节点连着几条边 |
| 自环 | self-loop | 节点连向自己的一条边 |
| GNN | Graph Neural Network | 直接在图上运算的神经网络 |
一个类比:班级通讯录
一个班的同学是节点,谁加了谁的微信就是一条边。每个同学的资料卡(年龄、专业、爱好)就是节点特征。
把全班名单横着写一遍、竖着写一遍,交叉格里填「加了好友记 1,没加记 0」,这张大表就是邻接矩阵。每一行数一数有几个 1,就是这个同学有几个好友,也就是度。
类比在哪里失效:
- 微信好友是双向的,所以这张表左右对称。有些图的边有方向(比如关注关系),表就不对称了,本讲只用无向图。
- 通讯录里没人会把自己加成好友。GNN 却要故意给每个节点加一条连向自己的边,原因在下一页:算新特征时要把自己的信息也算进去。
从零讲起
1. 图是什么样的数据
它解决什么问题
前几讲的网络对输入形状有要求。图片是固定大小的网格,CNN 的卷积核按固定形状滑动;句子是一串词,RNN 和 attention 一个接一个地读。社交网络、分子结构这类数据两种形状都不是,需要一种新的写法和新的网络。
直觉
网格里每个像素都有上下左右 4 个邻居,大家一模一样。图里的节点各不相同:有的只连 1 条边,有的连 5 条。卷积核的形状没法跟着每个节点变,所以 CNN 用不上。
序列至少有先后顺序。图里的节点没有天然的第一个、第二个,也就不能像 RNN 那样从头读到尾。
一步一步看
目标:对比像素网格和图里每个节点的邻居数,再看课件三种图,看出图为什么要先写成矩阵。
-
先看网格:任取一个像素,它的邻居数是固定的。
-
再看图:右边 6 个节点,邻居数分别是 1、2、5 个,没有统一的窗口。
-
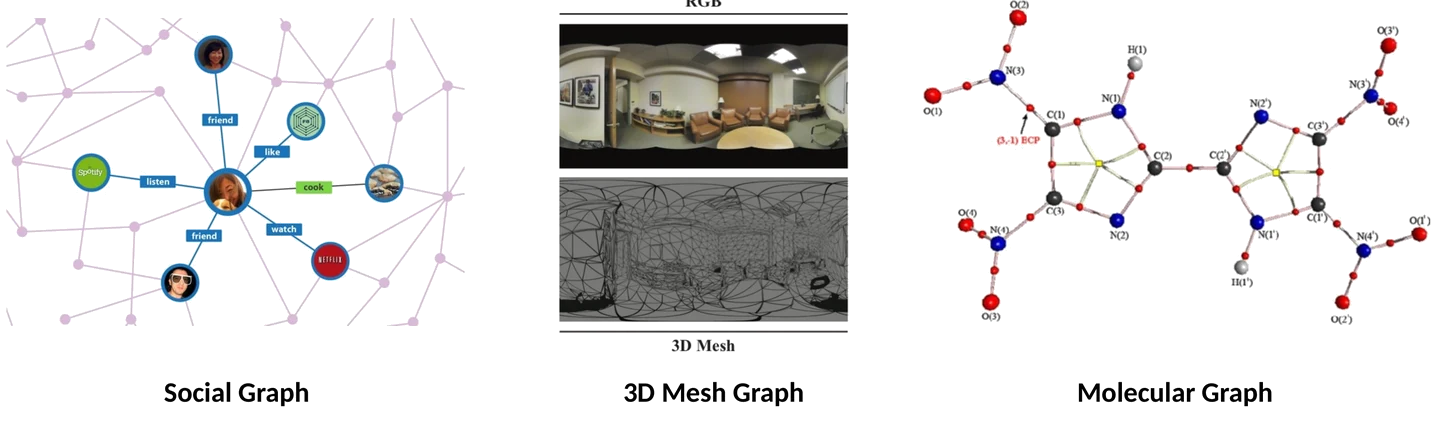
课件举了三种图:社交网络、三维网格(把房间表面拆成小三角形)、分子(原子是节点,化学键是边)。
图片来源:COMP5541 Lecture 8 课件, p.9 -
三种图的共同点:节点数各不相同,每个节点的边数各不相同,节点和边各带不同的信息。
-
所以要先把图写成矩阵,再设计在矩阵上运算的网络,这就是 GNN。
怎么判断
拿到一种数据,问两句:它的每个元素的邻居个数固定吗?元素之间有固定的先后顺序吗?
意思是:邻居个数固定、排成方格的是网格数据,用 CNN 或全连接层;有先后、长度可变的是序列,用 RNN 或 attention;两样都没有、只知道谁和谁相连的是图,用 GNN。
常见误解
以为图片也能算一种图,所以 CNN 就够用了
图片确实可以看成「每个像素连上下左右」的特殊图。但它的邻居数处处相同,CNN 正是靠这一点才能共用一个固定形状的卷积核。一般的图做不到这一点。
以为节点按编号排好以后,图就变成了序列
编号是人随手给的,换一种编号图还是同一张图。RNN 读序列时结果和顺序有关,用在图上会让「换个编号」改变输出,这不合理。
试一下
一张图有 4 个节点,边是 1-2、1-3、1-4。各节点的邻居数是多少?
节点 1 有 3 个邻居,节点 2、3、4 各 1 个。同一张图里邻居数不一样,这就是「不规则」。
2. 邻接矩阵、度矩阵和自环
它解决什么问题
神经网络只会算数,看不懂一张画出来的图。要把「谁和谁相连」「每个节点有几个邻居」「每个节点的特征」都写成矩阵,后面才能用矩阵乘法一次算完所有节点。
直觉
邻接矩阵就是一张「好友表」:行和列都是全部节点,相连的格子填 1。度就是数一行里有几个 1。
自环是给每个节点在表里也和自己「连上」,对角线从 0 改成 1。这样下一步按行收集信息时,节点自己的特征也会被收进来。
一步一步看
目标:用课件的五节点图依次写出邻接矩阵、度矩阵、加自环后的矩阵和特征矩阵,最后用边数核对。
用课件的例子图:5 个节点 A–E,7 条边,每个节点 3 个特征。
-
写邻接矩阵 A:A 和 B、C 相连,所以 A 行是 0 1 1 0 0。其余各行同理。
-
写度矩阵 D:每行数 1 的个数,A 有 2 个,B 有 4 个,C 有 3 个,D 有 2 个,E 有 3 个。放在对角线上,其余填 0。
-
加自环:Ã = A + I,对角线全变成 1;度跟着各加 1,D̃ = D + I,对角线是 3、5、4、3、4。
-
写特征矩阵 X:5 行 3 列,第一行是 A 的特征 [0.8, -0.6, 1.1],依次往下。
-
自查:7 条边,每条在 A 里出现两次(A 行 B 列、B 行 A 列),所以 A 里一共有 14 个 1,等于度的总和 2+4+3+2+3。
怎么算
A[i][j] = 1(i 和 j 之间有边),否则 0
D[i][i] = A 第 i 行之和;Ã = A + I;D̃ = D + I;X 的第 i 行 = 节点 i 的特征
意思是:A 记录连接关系,D 记录每个节点的邻居个数,I 是对角线为 1 的单位矩阵。加 I 就是给每个节点添一条连向自己的边,所以 Ã 的对角线是 1,D̃ 的每个对角数都比 D 多 1。
无向图里 A[i][j] = A[j][i],矩阵沿对角线对称。课件后面的 Ã、D̃ 都在这个基础上运算。
常见误解
以为度矩阵 D 每一格都要填数
D 只有对角线上有数,表示每个节点的边数;对角线以外全是 0。这样它左乘一个矩阵时,效果是把每一行各乘(或除以)一个数。
以为加了自环,度不用改
自环也是一条边,算进节点的度里。课件写 D + I,就是每个节点的度各加 1:A 从 2 变 3,B 从 4 变 5。
试一下
三个节点排成一条线 1-2-3,写出 A、D、Ã、D̃。
A 是 0 1 0 / 1 0 1 / 0 1 0;D = diag(1, 2, 1);Ã 是 1 1 0 / 1 1 1 / 0 1 1;D̃ = diag(2, 3, 2)。
3. 图上的三类任务
它解决什么问题
同一张图可以问不同的问题。要给谁打标签、训练时损失算在哪里,取决于任务是哪一类。先分清任务,后面的网络结构才有方向:节点分类只要 GCN 层,图分类还要把图缩小。
直觉
问「这个人支持谁」,答案落在一个节点上。问「这个分子稳不稳定」,答案落在整张图上。问「这两个人以后会不会成为好友」,答案落在一对节点之间的边上。
一步一步看
目标:用三个面板分别看节点分类、图分类和连边预测,再判断课件 A–E 的例子属于哪一类。
-
节点分类:每个节点一个标签。课件的社交网络例子是判断一个人支持哪位候选人。
-
图分类:一整张图一个标签。课件的例子是判断一个分子稳定还是不稳定。
-
连边预测(Link/Edge Prediction):给两个节点,判断它们之间有没有边。课件写 Connected / Disconnected?
-
课件 A–E 的例子属于节点分类:A、B、C 的标签已知,D、E 的标签要预测。
-
课件在三类后面写了省略号,表示图上的任务不止这三种,本讲只讲这三种。
怎么判断
看答案落在哪里:一个节点、一整张图,还是一对节点之间。
意思是:答案是每个节点各一个,就是节点分类;整张图只要一个答案,就是图分类;问两个节点会不会连上,就是连边预测。
常见误解
以为分子稳定性是节点分类,因为分子里每个原子都是节点
问题问的是整个分子稳不稳定,一张图只有一个答案,所以是图分类。原子是节点,但标签不在原子上。
以为节点分类时每个节点都要有标签才能训练
课件例子里只有 A、B、C 有标签,D、E 没有。训练用有标签的节点,学好以后去预测没标签的节点。
试一下
给一张论文引用网络,判断每篇论文属于哪个领域。这是哪类任务?
每篇论文是一个节点,每个节点一个答案,是节点分类。
把它们串起来
图是第三种数据形状:没有网格那样固定的邻居数,也没有序列那样的先后顺序。社交网络、三维网格、分子都是图。
要让网络处理图,先把它写成矩阵。邻接矩阵 A 记谁和谁相连,度矩阵 D 记每个节点有几个邻居,特征矩阵 X 每行放一个节点的特征。再给每个节点加自环,得到 Ã = A + I 和 D̃ = D + I。
拿到一张图,先看问题落在哪里:节点、整张图,还是一对节点之间的边。课件 A–E 的例子是节点分类,下一页就用 Ã、D̃、X 算每个节点怎么从邻居那里收集信息。
课件里的坑
- [留白] p.12 的方法分类图引自 Zhou 等的综述,红框圈出 GCN、DIFFPOOL 等。图里还列了 GraphSAGE、GAT、ChebNet 等方法,课件没有展开,不作为考点。
- [术语] p.15 只在两个矩阵旁写 A + I、D + I,到 p.16、p.18 才用 Ã、D̃ 的记号。两种写法指同一样东西。
- [术语] p.28 第 2 条把第三类任务写成 node connection prediction,和 p.11 的 Link/Edge Prediction 是同一类任务。
课后 10 分钟:考点复习
这 10 分钟怎么用:先说出图和网格、序列的区别;再对着课件 A–E 的图默写 A、D、Ã、D̃,用「1 的总数 = 度的总和」自查;最后给三个应用各判断一次是哪类任务。
必背
- 图是不规则数据:每张图的节点数不同,每个节点的边数不同,节点和边带的特征也不同。
- 固定大小的网格数据用 CNN / Dense 层,长度可变的序列用 RNN / Attention,图要用 GNN。
- 邻接矩阵 A:节点 i 和 j 之间有边记 1,没有记 0;无向图的 A 左右对称,对角线为 0。
- 度矩阵 D 是对角矩阵,对角线上是每个节点的边数,也就是 A 每行之和。
- Ã = A + I(给每个节点加自环),D̃ = D + I;特征矩阵 X 每行是一个节点的特征。
- 图上的三类任务:节点分类、图分类、连边预测(Link/Edge Prediction)。
课件例题
例 1(课件 p.15):写出例子图的四个矩阵
题面:p.14 的图有 5 个节点,边是 A-B、A-C、B-C、B-D、B-E、C-E、D-E。写出 A、D、Ã、D̃。
提示
先逐个节点数邻居,写出 A 的每一行;D 的对角线就是每行 1 的个数;最后对角线各加 1。
解答
- A:A 行 0 1 1 0 0;B 行 1 0 1 1 1;C 行 1 1 0 0 1;D 行 0 1 0 0 1;E 行 0 1 1 1 0。
- D = diag(2, 4, 3, 2, 3)。
- Ã:对角线全部改成 1,例如 A 行 1 1 1 0 0,B 行 1 1 1 1 1。
- D̃ = diag(3, 5, 4, 3, 4)。
例 2(课件 p.11):判断任务类型
题面:判断下面三个问题各属于哪类任务:(a) 社交网络里一个人支持哪位候选人;(b) 一个分子稳定还是不稳定;(c) 两个节点之间会不会连上。
提示
看答案落在一个节点、整张图,还是一对节点之间。
解答
(a) 节点分类;(b) 图分类;(c) 连边预测。
例 3(课件 p.9):图为什么是不规则数据
题面:说出课件列的三条理由。
提示
分别从节点数、边数、特征三个角度说。
解答
每张图的节点数不同;每个节点的边数不同;每个节点和每条边带的信息(特征)不同。
完整例题
自编情境。4 个节点 P、Q、R、S,边是 P-Q、Q-R、Q-S、R-S。(a) 写出 A 和 D。(b) 写出 Ã 和 D̃。(c) 用「1 的总数」自查。
- 邻居:P 连 Q;Q 连 P、R、S;R 连 Q、S;S 连 Q、R。
- A:P 行 0 1 0 0;Q 行 1 0 1 1;R 行 0 1 0 1;S 行 0 1 1 0。
- D = diag(1, 3, 2, 2)。
- Ã:对角线改成 1,P 行 1 1 0 0;Q 行 1 1 1 1;R 行 0 1 1 1;S 行 0 1 1 1。
- D̃ = diag(2, 4, 3, 3)。
- 自查:4 条边 × 2 = 8 个 1,度的总和 1+3+2+2 = 8,对上。
答案:D = diag(1, 3, 2, 2),D̃ = diag(2, 4, 3, 3),A 和 Ã 如上。
要点:A 对称、对角线为 0;Ã 对角线为 1;D̃ 每个对角数比 D 多 1。
答题格式:先列每个节点的邻居,再写 A,再写 D,最后写加了 I 的两个矩阵。
变式题(先自己做)
(1) 改编自课件 p.15:如果在例子图里删掉边 B-E,D 和 D̃ 变成什么? (2) 自编情境:5 个节点围成一个圈 1-2-3-4-5-1,D̃ 是什么? (3) 自编情境:电商平台想预测一位用户会不会买某件商品(用户和商品都是节点,购买是边)。这是哪类任务?
提示
(1) 删一条边,两端节点的度各减 1。(2) 圈上每个节点有几个邻居?(3) 答案落在哪里?
判分点与答案(非官方评分标准)
判分点:① 删边后两个端点都要改;② 自环让每个度加 1;③ 任务类型按答案位置判断。
- (1) B 从 4 变 3,E 从 3 变 2:D = diag(2, 3, 3, 2, 2),D̃ = diag(3, 4, 4, 3, 3)。
- (2) 每个节点 2 个邻居,D̃ = diag(3, 3, 3, 3, 3)。
- (3) 问用户和商品之间会不会出现一条边,是连边预测。
闪卡自测
1. 课件说图是不规则数据的三条理由?
节点数不同;每个节点的边数不同;节点和边的信息/特征不同(p.9)。
2. 网格数据和序列数据分别用什么层?
网格用 CNN / Dense 层,序列用 RNN / Attention 层(p.8)。
3. 邻接矩阵怎么填?
i 和 j 之间有边记 1,没有记 0;无向图对称,对角线为 0(p.15)。
4. 例子图的 D 和 D̃?
D = diag(2, 4, 3, 2, 3),D̃ = diag(3, 5, 4, 3, 4)(p.15)。
5. 为什么要加自环?
让节点在收集邻居信息时把自己的特征也算进去(p.15–16)。
6. 三类任务?
节点分类、图分类、连边预测(p.11)。
7. 分子稳定性是哪类任务?
图分类,一整张图一个答案(p.11)。
8. 课件 A–E 的例子是哪类任务?
节点分类:A、B、C 有标签,D、E 待预测(p.14)。
下一讲
下一页 L08b 用 Ã 乘 X,让每个节点把自己和邻居的特征加起来,再看为什么要除以度、有哪几种除法。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。