L03 Logistic Regression & NBC:中介 A 改做判断题
输出从一个数换成一个标签,于是模型加 sigmoid、损失换交叉熵;顺带出现一条完全不同的建模路线。
一句话版
把线性回归的输出套一层 sigmoid 压成概率,损失换成交叉熵,就能做分类;另一条路径干脆不学分界线,改学每一类长什么样,再用贝叶斯倒推。
一个类比:中介 A 改做判断题
上一讲 A 在纸条上写 价格 = w × 面积 + b,输出一个金额。这一讲他接了个新活:只回答「这套房三十天内卖得掉吗」,答案要么 0 要么 1。
纸条的第一行不用改,t = w × 面积 + b 照写。麻烦在输出:这一行可能算出 −3 万,也可能算出 500 万,而答案只有两种。于是在后面接一个 sigmoid,把任意实数压进 (0, 1) 区间,读成「卖得掉的概率」,0.5 就是分水岭(p.12, p.22)。
第二个麻烦是怎么算错得多离谱。A 顺手沿用上一讲的平方差,结果撞上一个怪现象:一套铁定卖得掉的房子,他判成「基本没戏」,这种最离谱的错误反而几乎不催他改参数——梯度在那里接近 0(p.18)。换成交叉熵,同一个位置的梯度直接顶到最大(p.15)。
同事 C 的做法不同:不画分界线,改成分别记下卖得掉和卖不掉的房子各长什么样,来了新房源就问它更像哪一堆。A 走判别式,C 走生成式,这一讲后半段就是 C 的做法——朴素贝叶斯(p.9, p.25)。
类比在哪里失效:C 要假设房子的各项特征互不相关,而面积和房间数显然一起涨;这个假设几乎总是错的,方法却照样能用来排序(p.27)。另外 A 的分界线只能是直的,弯的分界面靠上一讲的基展开绕,或等 L04 的多层网络(p.22, p.30)。
概念卡
1. 判别式与生成式(discriminative vs generative)
人话定义:一条路直接学「给定 x 时 y 是哪类」,另一条路学「每一类的 x 长什么样」加上「每一类占多大比例」,测试时用贝叶斯法则倒推。
例子:课件把两条路按训练、测试两个阶段并排画(p.9)。判别式建 P(yⁱ|xⁱ) = f(xⁱ, w),只有一套参数 w,测试时把 xᵏ 代进去直接得到 P(yᵏ|xᵏ)。生成式建 P(yⁱ) = h(w’) 和 P(xⁱ|yⁱ) = g(w) 两个分布,要估 w 和 w’ 两套参数,测试时先算 P(y)·P(x|y) 再用贝叶斯法则换成 P(y|x)。
生成式估两套参数,是因为它建的是联合分布 P(x, y) = P(x|y)·P(y),天然拆成条件和先验两块。判别式跳过联合分布,学不到 x 本身的分布,也就生成不出新样本。课件还列了两列成员(p.10):判别式这边是 Logistic Regression、Support Vector Machine、Conditional Random Fields,生成式那边是 Naïve Bayes Classifier、Markov Random Fields、Hidden Markov Models。
常见误解
「生成式参数多所以更准」→ 反过来。p.30 第一条优点写的是条件分布 p(y|x) 比联合分布 p(y, x) 容易学,判别式省下的建模能力全用在分界面上,准确率通常更高。
2. 逻辑回归的模型与交叉熵损失
人话定义:线性那一步原样保留,后面接 sigmoid 把实数压成概率,损失换成交叉熵。
例子:课件用左右两列对照(p.11–12)。第一步两边完全相同,tⁿ = w'xⁿ + b;第二步线性回归直接取 yⁿ = tⁿ,逻辑回归取 yⁿ = σ(tⁿ) = 1 / (1 + exp(−tⁿ))。损失从 L = (1/N) Σ(ȳⁿ − yⁿ)² 换成 L = (1/N) Σ[−ȳⁿ ln yⁿ − (1 − ȳⁿ) ln(1 − yⁿ)]。
t 有两个名字都要记:logit 和 pre-activation。第二个名字是给 L04 铺路的——到那时每一层都有自己的 pre-activation,sigmoid 只是众多激活函数里的一个。课件在两个 ln 旁边标了 logₑ or log₂:换底相当于给整个损失乘一个常数,梯度方向和最优解位置都不受影响。
常见误解
「套了 sigmoid 之后模型就非线性了」→ 决策边界仍然是线性的。sigmoid 只把实数轴单调压到 (0, 1),谁大谁小的次序一点没变,分界处始终是 t = 0 那个超平面(p.22)。
3. 交叉熵的梯度:(y − ȳ)x
人话定义:损失对参数求导,拆成三段链式,中间两段正好互相约掉,剩下「预测误差乘输入」。
例子:课件把 dL/dw 拆成 dL/dy · dy/dt · dt/dw(p.15),三段分别是:
dL/dy = −ȳ/y + (1 − ȳ)/(1 − y) = (y − ȳ) / [y(1 − y)]dy/dt = y(1 − y),这是 sigmoid 的导数 σ’ = σ(1 − σ)dt/dw = x
乘起来分母被整个约掉,dL/dw = (y − ȳ)x,dL/db = y − ȳ。
这个约分是交叉熵被选中的根本原因。sigmoid 在饱和区导数趋于 0,任何损失函数只要约不掉那个 y(1 − y),梯度都会在饱和区消失。交叉熵能约掉,L2 约不掉,下一张卡片就是反面演示。梯度下降的四步流程和上一讲一字不差,换的只有第三步要算的那个 L(p.14)。
常见误解
「记住结论 (y − ȳ)x 就够了」→ 计算题考过程。三段链式每段都要能默写,尤其第一段的化简和第二段的 sigmoid 导数(p.15)。
4. L2 loss 为什么在分类上失效
人话定义:把损失换成平方差,梯度在 y = 0 和 y = 1 两端都归零,预测错得最离谱的时候反而学不动。
例子:同样走三步链式,第一段变成 dL/dy = 2(y − ȳ),其余不变,得到 dL/dw = 2(y − ȳ)·y(1 − y)·x(p.18)。课件为了画图把 x 取成 1,代入两种标签值:ȳ = 1 时是 −2y(y − 1)²,ȳ = 0 时是 −2y²(y − 1)。两个式子各有一个二重根和一个一重根,所以曲线在 y = 0 和 y = 1 两端都压到 0。
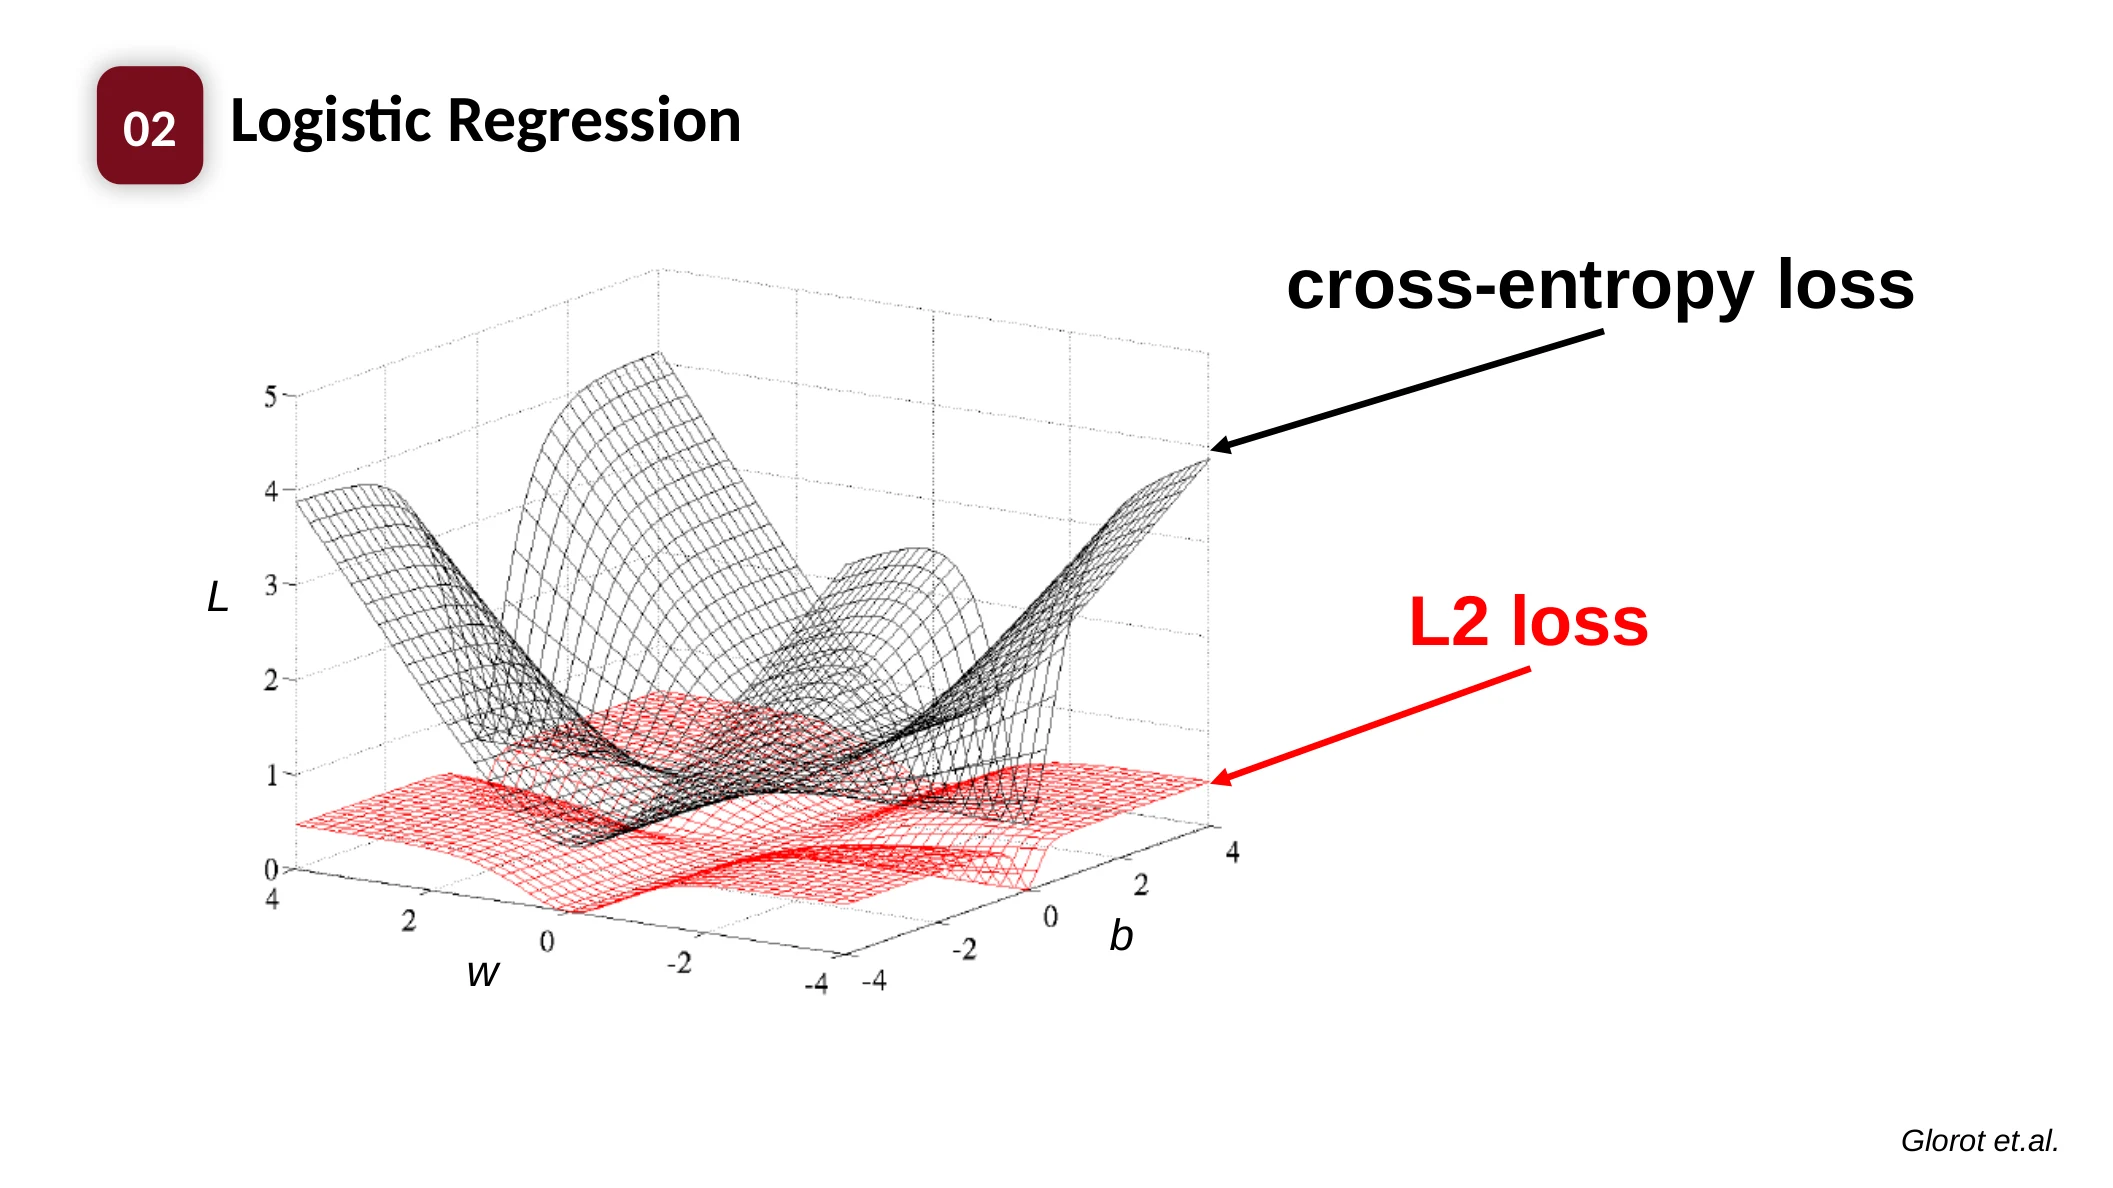
把数字代进去最直观:ȳ = 1 而当前预测 y = 0.01(错得最离谱),交叉熵梯度是 y − ȳ = −0.99,L2 梯度是 2(0.01 − 1)(0.01)(0.99) ≈ −0.0196,差了约 50 倍。课件还给了几何版本的同一句话(p.19):交叉熵的损失曲面起伏明显,一路能滑到谷底;L2 的曲面几乎是一张平板,梯度下降无处可下。
常见误解
「L2 loss 在分类上算出来的梯度是错的」→ 公式本身没算错,问题在取值形态:最该大的地方反而最小,训练因此卡住(p.18, p.20)。
5. 最大似然与交叉熵的等价
人话定义:从概率的角度写出「观测到这批训练数据的可能性」,取对数加负号,得到的式子与交叉熵只差一个 1/N 常数因子,最优点相同。
例子:模型输出「属于类别 1 的概率 p」,属于类别 0 的概率就是 1 − p(p.21)。全部 N 个点的似然写成连乘 p(y) = Πⁿ σ(tⁿ)^{ȳⁿ} · [1 − σ(tⁿ)]^{1 − ȳⁿ}。指数在这里当开关用:ȳⁿ = 1 时第二个因子的指数为 0、整项变 1,只剩 σ(tⁿ);ȳⁿ = 0 时反过来,一个连乘式就盖住两种情况。
连乘会下溢、求导也麻烦,取对数变连加,再加负号把最大化变成最小化,得到负对数似然 NLL = −Σⁿ [ȳⁿ ln σ(tⁿ) + (1 − ȳⁿ) ln(1 − σ(tⁿ))]。把 σ(t) 记作 y、整体除以 N,就是交叉熵。课件右下角那句 “Then use gradient descent !!!” 同样是考点:MLE 只负责推出目标函数,求解照样靠梯度下降。
常见误解
「梯度下降和最大似然是两种可选的求解方法」→ p.13 的排版容易让人这么读。MLE 推出的目标函数与交叉熵相同,最后一步仍是梯度下降,两条路在 p.22 汇成同一行。
6. 决策超平面与 softmax
人话定义:逻辑回归做的事情就是找一个线性超平面把点分开;类别多于两个时,把 sigmoid 换成 softmax。
例子:模型压成一行 y = σ(w'x + b)(p.22)。w'x + b = 0 的点落在超平面上,大于 0 和小于 0 的点落在两侧。课件的三维示意图里,蓝色平面是决策边界,平面上的点经 sigmoid 后映射到 y = 0.5,两侧的点分别靠近 0 和 1。「阈值取 0.5」「t = 0」「w’x + b = 0」是同一件事的三种说法。
多分类把 sigmoid 换成 softmax(p.23):p(y = c) = exp(w_c'x + b_c) / Σ_{c'} exp(w_{c'}'x + b_{c'})。分子的 exp 保证每项为正,分母求和保证全部输出加起来等于 1,两条合起来输出才有资格叫概率分布;C = 2 时它退化成 sigmoid。多分类交叉熵写成 −Σᵢ ȳᵢ ln yᵢ,由于 ȳ 是 one-hot,求和里只有正确类别那一项非零,实际计算退化成 −ln(y_正确类)。课件右侧的三分类决策区域图里,三块区域的边界全是直线——线性这个性质在多分类里照样成立。
7. 朴素贝叶斯分类器(NBC)
人话定义:训练时按类别数数、算均值方差,把先验和条件分布都估出来;测试时假设各特征独立,把条件概率连乘,再乘先验比大小。
例子:课件的训练集有四个特征(p.25–26):x₁、x₃、x₄ 是实值,x₂ 是类别型(A1、A2),标签取自 {c1, c2, c3}。先验靠数数,p(y = cᵢ) = count(cᵢ)/N。条件分布按特征类型分流:实值特征假设类内服从高斯,估每个「类别 × 特征」组合的 μ 和 σ²;类别型特征就在每个类别内部数各取值的比例。
课件在高斯那一行用红框标了 Assumption !!:实值特征类内高斯是一个额外假设,和名字里那个「朴素」(特征条件独立)是两个不同的假设。测试时对每个类别取出先验与各维特征概率,用独立性拆成连乘,后验正比于先验乘连乘(p.27)。归一化的分母对所有类别相同,只比大小时可省,要报概率数值时不能省。
常见误解
「独立性假设在现实中不成立,所以 NBC 没用」→ 假设不成立与方法没用是两回事。独立性把参数量从指数级压到线性级,实践中排序往往仍然可靠;代价是概率值走极端,四个小于 1 的数连乘很容易逼近 0 或 1(p.27, p.30)。
把它们串起来
主线是 p.9 那张分叉图。分类的 ground truth 变成 one-hot 向量、输出变成概率向量(p.8),于是上一讲的整套要重验一遍:模型形态加 sigmoid,损失换交叉熵,求解仍是梯度下降。中间四张卡片全在回答「为什么必须是交叉熵」——公式上是约分约得掉,几何上是曲面有坡度,概率上是最大似然推出同一个式子。
右边那条分叉是 NBC:学 P(y) 与 P(x|y),用两个额外假设把不可数的联合分布压成可数的参数。课件 p.29 给了四个自问(假设、关键步骤、优点、局限),p.30 与 p.31 各列一组优点:LR 赢在准确率、特征预处理和概率校准,NBC 赢在不用优化、能处理缺失特征、可按类别单独拟合、可用于无标签数据。这六条几乎每一条都能改写成一道判断题。
p.32 把两条路延伸到整门课:逻辑回归画成一个神经元,堆起来加隐藏层就是 L04 到 L08;NBC 的分布建模指向表示学习,延伸下去是 L09 到 L11 的 autoencoder、VAE、GAN 与对比学习。
课件里的坑
- [读图提醒] p.18 最后那个只含 y 的多项式展开,隐含把 x 取成了 1,否则化不成那个形式。这一步是为画图方便做的简化,x 作为正的比例因子不改变零点位置,但手推时别漏掉这个前提。
- [读图提醒] p.23 的多分类交叉熵写成 −Σᵢ³ ȳ·ln(yᵢ),ȳ 的下标 i 漏了,按定义应是 ȳᵢ。
- [读图提醒] p.28 汇总表最后一行用的是等号,严格的贝叶斯法则是 p(y|x) = p(y)·p(x|y) / p(x)。此处应理解为未归一化的后验分数,与 p.27 的口径一致;题目要求真实后验概率时分母不能漏。
- [读图提醒] p.16 与 p.15 内容相同,答案区被一块黑色矩形盖住——那是课堂上先想后揭晓用的遮罩,导出成 PDF 后变成实心黑块。完整推导看 p.15。
- [补充] p.10 左列第二个写作 Scalar Vector Machine,通行叫法是 Support Vector Machine(支持向量机)。
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先默写三条——sigmoid 与交叉熵的写法、三步链式推到 (y − ȳ)x、NBC 训练的两个分布怎么估;再做变式题;最后回查两处最易混——NBC 的两个假设别揉成一条,MLE 与梯度下降别当成并列解法。
必背
- 判别式建 P(y|x) 只估一套参数、测试时直接算;生成式建 P(y) 与 P(x|y) 要估两套、测试时用贝叶斯法则倒推。
- 逻辑回归 = 线性回归的第一步 t = w’x + b 加 sigmoid 再加交叉熵;t 叫 logit 或 pre-activation,交叉熵里 log 取底 e 或 2 只差一个常数因子。
- 交叉熵梯度三步链式:dL/dy = (y − ȳ)/[y(1−y)],dy/dt = y(1−y),dt/dw = x,化简得 dL/dw = (y − ȳ)x、dL/db = y − ȳ。
- L2 loss 用在分类上会失效(取 x=1):ȳ=1 时梯度为 −2y(y−1)²、ȳ=0 时为 −2y²(y−1),y=0 与 y=1 两端都趋于 0,预测错得最离谱时反而学不动。
- 最大似然等价于最小化交叉熵:似然连乘取对数加负号得到 NLL,把 σ(t) 记作 y 就得到交叉熵,只差一个 1/N 常数因子,最优点相同;MLE 只推出目标函数,求解仍用梯度下降。
- 逻辑回归本质是找一个线性超平面,w’x + b = 0 是决策边界,对应 sigmoid 输出 0.5 的阈值;softmax 分子 exp 保证为正、分母求和保证归一,C = 2 时退化成 sigmoid。
- NBC 训练学两件事:先验 p(y = cᵢ) = count(cᵢ)/N;条件分布按特征类型分流,实值特征假设类内高斯(这是额外假设),类别型特征用类内计数比例。
- NBC 测试用独立性假设把 p(x|y) 拆成各维连乘,后验正比于先验乘连乘;只比大小时归一化可省,要报告概率值时不能省。
完整例题
题面:一维逻辑回归,训练点 x = 0.8、ȳ = 1,当前参数 w = 0.5、b = 0,学习率 η = 0.5。求当前损失、交叉熵梯度,做一步更新并回算损失;再求同一点上 L2 loss 的梯度作对比。
步骤:t = 0.5 × 0.8 + 0 = 0.4,y = σ(0.4) = 1/(1 + e^{−0.4}) ≈ 0.598688。ȳ = 1,所以 L = −ln y ≈ 0.513015。
梯度直接套结论:dL/dw = (y − ȳ)x = (0.598688 − 1)(0.8) ≈ −0.321050,dL/db = y − ȳ ≈ −0.401312。
更新:w₁ = 0.5 − 0.5 × (−0.321050) ≈ 0.660525,b₁ = 0 − 0.5 × (−0.401312) ≈ 0.200656。回算 t₁ ≈ 0.729076,y₁ ≈ 0.674603,L₁ ≈ 0.393632,损失从 0.513 降到 0.394。
L2 对比:dL/dw = 2(y − ȳ)·y(1 − y)·x ≈ 2 × (−0.401312) × 0.240267 × 0.8 ≈ −0.154271,约为交叉熵梯度的 0.48 倍。这个点 y ≈ 0.6 仍在 sigmoid 的陡峭段,差距只有两倍出头;y 越靠近 0 或 1,差距越大。
答案:L ≈ 0.5130,梯度 (−0.3211, −0.4013),一步后 (w, b) ≈ (0.6605, 0.2007)、L ≈ 0.3936;同点 L2 梯度 ≈ −0.1543。
变式题(先自己做)
换一个点:x = −1.2、ȳ = 0,当前 w = 0.5、b = 0,η = 0.5。求当前损失与交叉熵梯度,做一步更新并回算损失;再求同一点上 L2 loss 的梯度,说出两者比值,并回答这个比值会在什么情况下急剧放大。
提示
ȳ = 0 时交叉熵只剩 −ln(1 − y) 那一项。梯度公式不分标签值,照样是 (y − ȳ)x,注意 x 为负会让梯度换号。L2 梯度在交叉熵梯度上多乘一个 y(1 − y)。
参考答案与自检(非官方评分标准)
自检要点:① ȳ = 0 时损失项只留 −ln(1 − y),别把两项都写上;② 梯度里的 x 是 −1.2,符号要跟着翻;③ 最后要说出比值放大的条件是 y 趋近 0 或 1,也就是 sigmoid 的饱和区。
- t = 0.5 × (−1.2) + 0 = −0.6,y = σ(−0.6) ≈ 0.354344。
- ȳ = 0,L = −ln(1 − y) = −ln(0.645656) ≈ 0.437488。
- dL/dw = (y − ȳ)x = 0.354344 × (−1.2) ≈ −0.425212;dL/db = y − ȳ ≈ 0.354344。注意两个分量符号相反。
- 更新:w₁ = 0.5 − 0.5 × (−0.425212) ≈ 0.712606,b₁ = 0 − 0.5 × 0.354344 ≈ −0.177172。
- 回算:t₁ ≈ −1.032299,y₁ ≈ 0.262639,L₁ ≈ 0.304677,损失从 0.4375 降到 0.3047。
- L2 梯度 = 2(y − ȳ)·y(1 − y)·x ≈ 2 × 0.354344 × 0.228759 × (−1.2) ≈ −0.194564,交叉熵梯度约为它的 2.19 倍。
- 比值就是 1 / [2y(1 − y)],y 越靠近 0 或 1 分母越小、比值越大;y = 0.5 时比值最小为 2,y = 0.01 时已放大到约 50。预测错得越离谱,L2 越学不动。
闪卡自测
1. 判别式与生成式在训练阶段各要估几套参数?测试阶段算后验的方式有什么不同?
判别式一套 w,生成式 w 与 w’ 两套;判别式直接算 P(y|x),生成式先算 P(y)·P(x|y) 再用贝叶斯法则倒推(p.9)。
2. t = w'x + b 的两个名字是什么?交叉熵里 log 的底取 e 还是 2 有区别吗?
logit 与 pre-activation;换底只相当于乘一个常数,不影响梯度方向和最优解位置(p.12)。
3. 交叉熵梯度的三步链式里,哪两项互相约掉了?换成 L2 还约得掉吗?
dL/dy 的分母 y(1 − y) 与 sigmoid 导数 y(1 − y) 约掉;L2 的 dL/dy = 2(y − ȳ) 没有分母,约不掉,y(1 − y) 被留在结果里(p.15, p.18)。
4. ȳ = 1 时 L2 loss 的梯度是什么?它在 y = 0 处等于多少,说明什么?
−2y(y − 1)²,在 y = 0 处等于 0;预测错得最离谱的时候梯度反而消失,参数几乎不动(p.18)。
5. 似然式里的指数 ȳⁿ 和 1 − ȳⁿ 起什么作用?ȳⁿ = 0 时这一项化简成什么?
当开关用,把两种标签情形写进同一个连乘式;ȳⁿ = 0 时只剩 1 − σ(tⁿ)(p.21)。
6. 阈值 0.5 对应到 y、t 和 w'x + b 分别是什么条件?决策边界是什么形状?
y = 0.5 ⇔ t = 0 ⇔ w’x + b = 0,三者等价;边界是线性超平面(p.22)。
7. softmax 的分子和分母各保证了什么?C = 2 时它变成什么?
分子 exp 保证每项为正,分母求和保证输出加起来为 1;C = 2 时退化成 sigmoid(p.23)。
8. ȳ 是 one-hot 时,多分类交叉熵 −Σᵢ ȳᵢ ln yᵢ 能化简成什么?
求和里只有正确类别那一项非零,化简成 −ln(y_正确类)(p.23)。
9. NBC 有几个假设?分别是什么?
两个:各特征条件独立(名字里的「朴素」),以及实值特征在每个类别内服从高斯。判断题最爱把它们揉成一条(p.26, p.27)。
10. 测试样本缺了一个特征值,NBC 与 LR 分别还能不能预测?
NBC 把连乘里那一项跳过、其余照算;LR 的 w’x 少一维就算不下去(p.31)。
11. NBC 测试阶段的归一化什么时候可以省?
只需要挑出概率最大的类别时可以省,因为分母对所有类别相同;要报告一个可用的概率数值时不能省(p.27)。
12. 为什么说逻辑回归就是一个神经元?这个类比通向哪几讲?
输入加权求和得到 t,再过一个 σ 输出,正是单个神经元的结构;堆成多层就是 L04 到 L08 的深度网络(p.32)。
下一讲
下一讲 Deep Neural Networks Part 1 从 p.32 左边那个单神经元出发,把它堆成多层。这一讲的 sigmoid、交叉熵、链式法则梯度会原样复用,新增的只有「梯度怎么在层与层之间往回传」;三步链式这一关没过,反向传播那一讲会直接卡住。
下一讲的通俗笔记上完课会补,先回 COMP5541 课程页。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。