L01 Introduction to ML + KNN:把整本成交簿子背下来的那个中介
机器学习的三层地图,外加一个把训练集本身当模型的算法。
一句话版
机器学习让机器自己从数据里写规则,KNN 最懒:它把数据本身当规则。
一个类比:两家卖二手房的中介
小区门口开着两家中介。
A 家的老板信公式。成交记录他全看过,看完只留下一张纸条:单价约等于 a×地段分 + b×面积 + c×楼龄。客户来问价,他量三个指标,代入,报数,原始记录早扔了。
B 家的老板信记录。每一笔成交都抄进一本厚簿子,一条不删。客户来问,他把几千条记录逐条和眼前这套比一遍「像不像」,挑出最像的三套,取成交价的平均数报出去。他从不总结规律,全部本事就是这本簿子。
两家都在做机器学习。看记录、攒本事的那段时间叫 Learning,输入是带标签的数据、输出是一个能干活的程序;客户上门、当场给出报价的那一下叫 Inferring,输入是一个没见过的房子、输出是预测(p.40)。区别只在本事存放的位置:A 存在三个系数里,B 存在整本簿子里。B 就是 KNN。
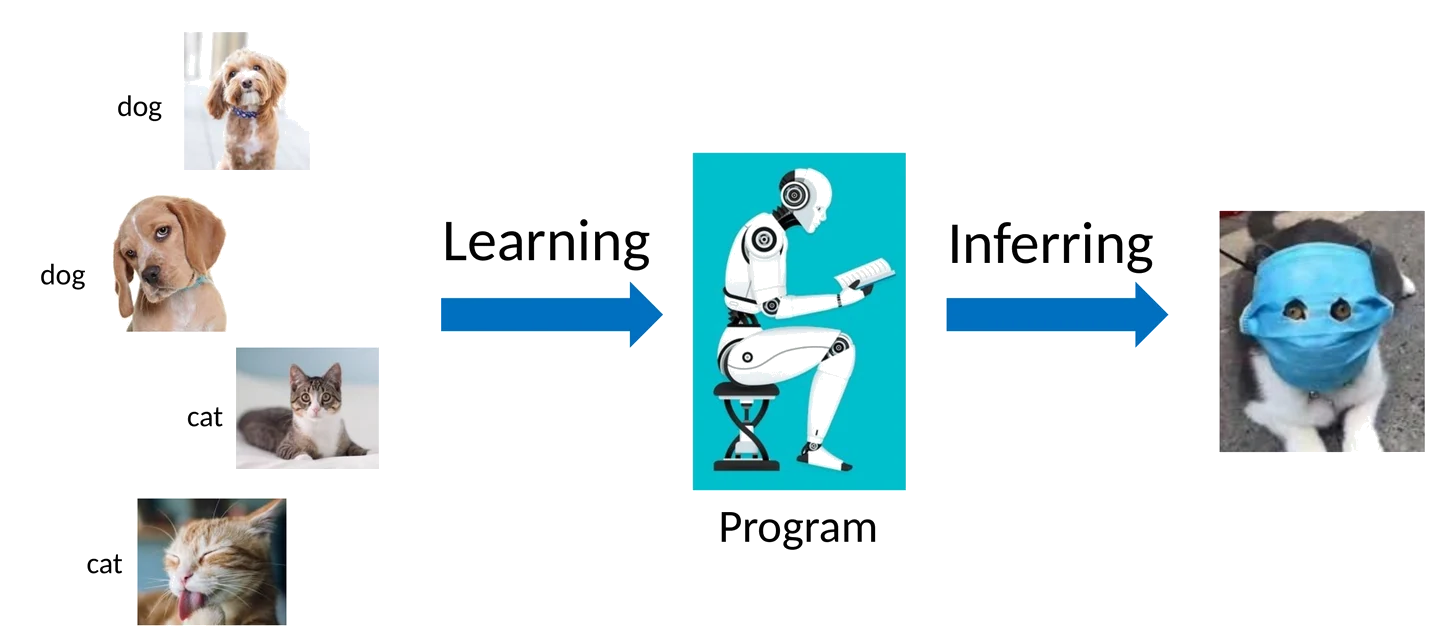
顺着这个场景能一次看清三件事。A 的纸条上永远是三个系数,喂 100 条记录还是 100 万条都一样,参数个数在看到数据之前就定死了;B 的簿子越记越厚,模型大小跟着数据量涨,这就是课件说的 non-parametric(p.43)。A 报价快、B 报价慢,因为 B 每接一单都要把整本簿子翻一遍(p.49)。
类比在哪里失效。第一,真中介翻簿子会先按小区缩范围,课件的朴素 KNN 不使用索引捷径,每预测一个样本都要和全部 N 个训练点各算一次距离,代价全压在预测阶段。第二,中介心里的「像」自带常识,算法只认你写下的那条距离公式,课件 p.50 特意写了 Distance Metric; You define it!——公式里把总价和楼龄直接相减求和,它照样一本正经算完给你一个答案。第三,中介被问「值多少钱」和「这是不是学区房」,脑子里没什么区别,对算法却是两种收尾方式:一种取均值,一种投票,类别标签不能取均值(p.51)。
概念卡
1. ML 的三层坐标(Paradigm / Tasks / Algorithms)
人话定义:课件把机器学习按三层组织——Paradigm 说的是「拿到的是什么样的数据」,Tasks 说的是「要输出什么」,Algorithms 说的是「用什么工具做」。
例子:三行填满就是这张地图(p.42)。
| Paradigm | Tasks | Algorithms |
|---|---|---|
| Supervised Learning | Classification、Regression | KNN, linear models, DNNs … |
| Semi/Unsupervised Learning | Clustering、Semi-sup Learning、Generative Model | K-means, PCA, DNNs … |
| Reinforcement Learning | 课件留空,L12 展开 |
常见误解
按算法难度或数据量划分范式 → 依据是监督信号的形式:标签齐全是监督,没有标签是无监督,部分有标签是半监督,只有延迟奖励是强化学习。另一个陷阱是把算法和范式绑死,注意 DNNs 在监督和无监督两栏里都出现了——同一个神经网络配上标签就是监督学习,配上重构目标就是自编码器(p.42)。
2. Parametric 与 Non-parametric
人话定义:课件的原话是 Parametric 有 finite set of parameters,Non-parametric 有 infinite set of parameters。后半句需要翻译才记得住,它的实际含义是模型复杂度不固定、随训练数据量增长。
例子:两栏的分界只有一条——数据变多时,模型跟不跟着变大(p.43)。
常见误解
以为 K 就是 KNN 的参数 → K 是超参数(由人选定,不是从数据里学出来的),KNN 真正的「模型」是那份被完整存下来的训练集。这个区别决定了两类模型的代价结构正好相反:本讲用线性模型与朴素 KNN 对比训练、存储和预测成本,不能推广到所有非参数方法,例如高斯过程也有训练开销(p.43)。
3. KNN 的四个步骤
人话定义:算距离 → 距离升序排序 → 取前 K 个训练点及其标签 → 汇总这 K 个标签。分类和回归只在第 4 步分道。
例子:课件把四步和一个图像分类的例子摆在同一页上(p.49)。
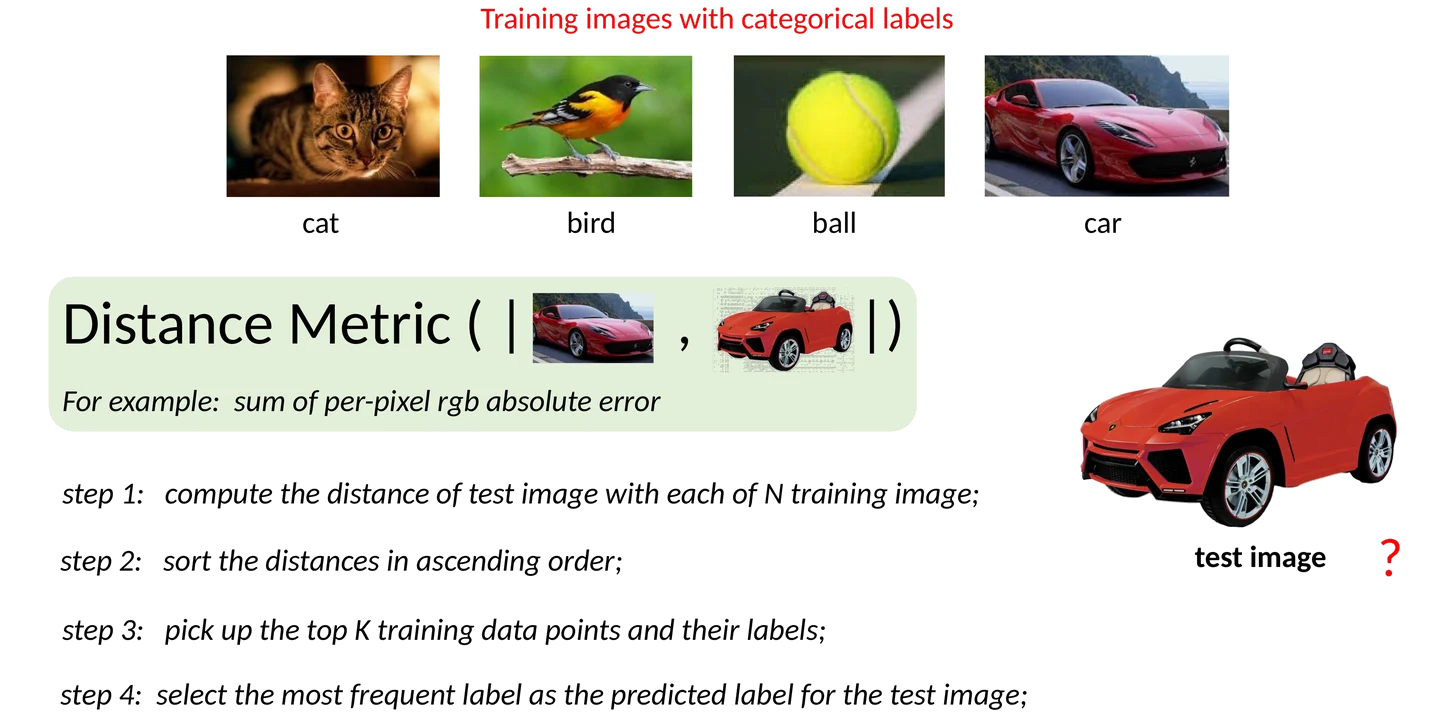
做回归时前三步一字不改,第 4 步换成取 K 个邻居标签的均值或加权均值,因为标签类型从 categorical 变成了 continuous(p.50)。
常见误解
以为回归版 KNN 是另一个算法 → 四步里有三步完全相同,区别只在汇总方式。另一个容易漏的是 step 1 的复杂度:每预测一个样本都要遍历全部 N 个训练点,训练阶段几乎不花时间,代价全压在预测阶段,这是本例与线性模型的对比,不是所有模型的通则(p.49)。
4. KNN 的假设、关键步骤、优点、局限
人话定义:课件把 Assumption / Key step / Advantages / Limitations 四个问题留成了空白,这四问是辨析题的直接来源。
例子:假设是「特征空间里离得近的点性质相似」,课件原话 The nearest data points in feature space have similar properties.(p.48)。关键步骤是距离度量的选择——四步里排序、取前 K、投票都是机械的,唯独距离由使用者定义,它决定了谁算邻居,也就决定了全部结果(p.50、p.52)。优点是简单、训练开销几乎为零、不对数据分布做任何假设、新数据可随时加入而不必重训。局限是预测慢(每次都要遍历 N 个样本)、存储大、对特征尺度和无关特征敏感、维度灾难、类别不平衡时投票偏向多数类(p.52)。尺度那条画出来最直观:
常见误解
把「不对数据分布做假设」理解成「没有假设」 → 相邻点性质相似这条假设一直在,而且它隐含要求各维度尺度可比。一维是年龄(0–100)、另一维是收入(0–1000000)时,欧氏距离会被收入完全主导,假设当场失效,所以 KNN 之前通常必须做特征归一化(p.52)。
把它们串起来
这一讲是全课的地图,正课只做两件事:给出机器学习的分类坐标系,再用 KNN 把「什么叫学习」落到地面。
坐标系是三层加一层。横着看是 Paradigm / Tasks / Algorithms(p.42),竖着还要再切一刀,就是 Parametric 与 Non-parametric(p.43)。KNN 在这张地图上的位置很特殊:它是全课唯一一个非参数模型,后面十一讲讲的全是参数模型。有了这个对照,「训练到底在训练什么」才有答案:线性回归在调 w 和 b,KNN 只是把数据存下来。
KNN 自身的链条也只有一条:核心假设(相邻点性质相似)决定了必须先定义距离 → 四步里前三步全是机械动作 → 第 4 步按标签类型分岔,类别只能投票、连续可以取均值 → 能不能取均值这件事,回到 p.51 那条度量与序的区别上。假设、关键步骤、优点、局限这四问(p.52)的答案,全部能从这条链上推出来,不用单独背。
课件里的坑
本讲课件未发现错误。有三处是有意留白、需要自己补上的地方,别当成遗漏:
- [课件留白] p.42 的 Reinforcement Learning 一行 Tasks 与 Algorithms 两栏都是空的,留到 L12 展开
- [课件留白] p.52 的 Assumption / Key step / Advantages / Limitations 四问只有题面没有答案,这是课堂讨论题,我猜也是辨析题的素材(课件没标重点)
- [课件留白] p.43 只给了 finite / infinite set of parameters 这个定义,没解释 infinite 指什么,答题时要翻译成「模型复杂度随数据量增长」
- [补充] p.49 的四步是朴素暴力搜索。「每次遍历全部 N 点」是这个实现的性质,不是 KNN 的定义——实际库改用 KD-tree、Ball-tree 等索引加速。答题按课件写,但别把它当算法的固有下限
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先默写三条——Paradigm / Task / Model 三层坐标、划分范式看监督信号的形式、KNN 四步;再把下面的「变式题」做一遍;最后回查两个最容易错的地方——以为 K 是 KNN 的参数、把「不对数据分布做假设」读成「没有假设」。三步做完再往下看答案。
必背
- Learning 的输入是带标签的训练数据、输出是一个模型,别名 training / fitting;Inferring 的输入是没见过的样本、输出是预测标签,别名 testing / prediction。
- ML 的三层坐标是 Paradigm(范式)/ Tasks(任务)/ Algorithms(算法);三个范式是 Supervised、Semi/Unsupervised、Reinforcement。
- 划分范式的依据是监督信号的形式,不按算法难度也不按数据量;同一个 DNN 在监督与无监督两栏里都出现。
- Parametric 是有限个参数(Linear Regression、PCA、NN),Non-parametric 是参数集合无界(KNN、Gaussian Processes),实质区别是模型复杂度是否随数据量增长。
- 参数模型的参数维数预先固定;非参数模型的复杂度可随数据增长,KNN 保留训练数据;KNN 训练开销约等于零,预测时要和全部 N 个训练点各算一次距离(课件给的朴素实现)。
- KNN 四步:算距离 → 距离升序排序 → 取前 K 个点及其标签 → 汇总;分类取最频繁的标签(投票),回归取 K 个邻居标签的均值或加权均值,只差第 4 步。
- 本例类别标签是无序类别,不能直接平均其编号;KNN 回归可取数值均值,分类可投票或汇总类别概率。
- KNN 的关键步骤是距离度量的选择,它由使用者定义;四大局限是预测慢、存储大、对特征尺度敏感必须归一化、维度灾难。
完整例题
期末闭卷 3 小时,考选择题加数学计算题。这一讲能动笔算的只有 KNN 本身,配套 demo 里那道四点小题是标准形态。
题面:训练集四个点——[2,2,2,2]→cat、[4,4,4,4]→dog、[1,2,1,1]→cat、[0,3,3,3]→dog。测试点 [5,5,5,5],欧氏距离。K = 2、K = 3、K = 1 分别预测什么?
- 逐点算距离(欧氏距离 = 各维差的平方和开根号)。到
[4,4,4,4]:四维各差 1,√(1+1+1+1) = 2,标签 dog。 - 到
[2,2,2,2]:四维各差 3,√(9+9+9+9) = √36 = 6,标签 cat。 - 到
[0,3,3,3]:差 5、2、2、2,√(25+4+4+4) = √37 ≈ 6.08,标签 dog。 - 到
[1,2,1,1]:差 4、3、4、4,√(16+9+16+16) = √57 ≈ 7.55,标签 cat。 - 升序排序:dog(2) < cat(6) < dog(6.08) < cat(7.55)。
- K = 1:只看 dog(2),预测 dog。
- K = 3:取前三个,dog、cat、dog,票数 2:1,预测 dog。
- K = 2:取前两个,dog、cat,票数 1:1 打平。demo 代码靠排序的稳定性隐式选了排在前面的 dog,这不是有意设计的规则。
- 这个平票正好暴露 KNN 的一个实际问题:K 取偶数时二分类会出现平局,所以实践中习惯取奇数 K。
变式题(先自己做)
同样四个训练点,把测试点换成 [1,1,1,1],仍用欧氏距离。(1) K = 1、K = 2、K = 3 分别预测什么?(2) K 加到 4 会发生什么?
提示
四个距离重算一遍,排序时留意这次的顺序和例题不一样。第二问不用算,回头看排序里两类各有几个。
参考答案与自检(非官方评分标准)
自检要点:① 展示四个距离及排序,以便核对不同 K 的邻居集合;② 三个 K 值要分别作答;③ 第二问要答出平票,并说出”偶数 K 不一定平票、但 K 加到 N 就退化成整体多数类”。
- 到
[1,2,1,1]:差 0、1、0、0 ⟹ √1 = 1,cat。 - 到
[2,2,2,2]:四维各差 1 ⟹ √4 = 2,cat。 - 到
[0,3,3,3]:差 1、2、2、2 ⟹ √13 ≈ 3.61,dog。 - 到
[4,4,4,4]:四维各差 3 ⟹ √36 = 6,dog。 - 升序:cat(1) < cat(2) < dog(3.61) < dog(6)。
- K = 1 → cat;K = 2 → cat、cat ⟹ cat,这次没有平票;K = 3 → cat、cat、dog,票数 2:1 ⟹ cat。
- K = 4 → cat、cat、dog、dog,2:2 平票。对比例题:偶数 K 只是可能平票,不是必然;但 K 一直加到训练集规模 N,投票就退化成”训练集里哪类多选哪类”,测试点的位置完全不起作用了。这就是 K 过大时欠拟合的极端形态。
闪卡自测
1. Learning 和 Inferring 的输入输出分别是什么?为什么训练集上的准确率不能拿来评价模型?
Learning:输入训练数据(图 + 标签),输出一个程序 / 模型,别名 training、fitting。Inferring:输入一个没见过的样本,输出预测标签,常称 inference、prediction;testing 另指评估环节。补充:inference 指运行模型生成预测,也可用于训练样本;评估泛化时才必须使用未参与训练和选择的数据(p.40)。
2. 三层坐标是哪三层?为什么 DNNs 会同时出现在监督和无监督两栏里?
Paradigm(拿到什么数据)/ Tasks(要输出什么)/ Algorithms(用什么工具)。算法和范式是两个独立维度,同一个神经网络配上标签就是监督学习,配上重构目标就是自编码器(p.42)。
3. 划分监督 / 半监督 / 无监督 / 强化学习的依据是什么?
监督信号的形式:标签齐全是监督,部分有标签是半监督,没有标签是无监督,只有延迟的奖励信号是强化学习。不按算法难度、也不按数据量分(p.42)。
4. 「非参数模型有无限个参数」该怎么理解?KNN 的「参数」到底是什么?
实际含义是模型复杂度不固定、随训练数据量增长。KNN 没有训练出来的参数,它把整个训练集背下来当模型本身,数据越多模型越大,所以参数集合无界(p.43)。
5. 各举两个 Parametric 和 Non-parametric 的例子,并说出两类模型的代价结构差别。
Parametric:Linear Regression、PCA、NN。Non-parametric:KNN、Gaussian Processes。本讲用线性模型与朴素 KNN 对比训练、存储和预测成本,不能推广到所有非参数方法,例如高斯过程也有训练开销(p.43)。
6. 写出 KNN 分类的四个步骤。做回归时哪一步要改,改成什么?
算距离(和全部 N 个训练点) → 距离升序排序 → 取前 K 个点及其标签 → 投票取最频繁的标签。做回归只改第 4 步,换成取 K 个邻居标签的均值或加权均值(p.49、p.50)。
7. 为什么可以对回归的标签取均值,却不能对分类的标签取均值?
连续标签所在的空间有度量与序,|1−5| < |1−10| 成立;类别标签之间只有等价关系,car 离 dog 更近还是离 chair 更近这句话本身没有意义,对 car 和 dog 求平均自然也没有意义(p.51)。
8. KNN 的核心假设是什么?它对特征提出了什么隐含要求?
假设是特征空间里离得近的点性质相似(p.48)。隐含要求是各维度尺度可比:一维年龄 0–100、另一维收入 0–1000000 时,欧氏距离被收入完全主导,假设立刻失效,所以必须先做特征归一化(p.52)。
9. KNN 的关键步骤是哪一步?为什么是它?
距离度量的选择。四个步骤里排序、取前 K、投票都是机械动作,唯独距离由使用者定义,课件原话是 Distance Metric; You define it!,它决定了谁算邻居,也就决定了全部结果(p.50、p.52)。
10. K 取得过小和过大分别有什么问题?二分类时为什么建议 K 取奇数?
K 太小对噪声敏感,K 太大会把远处不相关的点也拉进来(p.52)。K 取偶数时二分类可能出现票数打平,demo 里 K = 2 就打成了 1:1,只能靠排序顺序隐式决定,所以习惯取奇数(p.55)。
11. 为什么 KNN 在高维数据上会失效?
维度灾难:维度一高,所有点之间的距离趋于相等,「最近」这个概念失去区分力,靠距离挑邻居也就失去意义(p.52)。
12. KNN 的训练时间和预测时间各是什么量级?和线性回归相比是怎样的对照?
KNN 训练开销约等于零(只是把数据存下来),预测时要和全部 N 个训练点各算一次距离。线性回归正好相反,训练要做优化、预测只是代入公式(p.43、p.49)。
下一讲
下一讲 Linear Regression 走到参数模型那一侧:f 被固定成一条直线,本事从整本簿子压缩成几个系数,训练和预测的开销跟着调个个儿。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。