L07b-1 RNN:读一句话时,脑子里那张越写越满的便签
序列任务的五种形状、RNN 的递推公式与参数共享(逐个时间步手算一遍)、展开成计算图后损失和梯度怎么加,以及 seq2seq 和看图说话怎样拼出来。
一句话版
序列长短不一、前后相关。RNN 用同一个单元一步步读,每一步把旧记忆和新输入揉成新记忆。
参数从头到尾共用一组,所以序列多长,参数量都不变。
前置:读之前最好先懂反向传播,见 L06e。参数共享的想法和卷积一样,见 L07a-1。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 序列 | sequence | 有先后顺序的一串数据,比如一句话里的词、视频里的帧 |
| RNN | Recurrent Neural Network,循环神经网络 | 每一步复用同一组参数、逐个读序列的网络 |
| hₜ | 读「h 下标 t」,隐藏状态 | 第 t 步时网络的「记忆」,是一组数 |
| 时间步 | time step | 读序列的第几步,下标 t |
| tanh | 读「双曲正切」 | 把任意数压到 −1 到 1 之间的激活函数 |
| 编码器 / 解码器 | encoder / decoder | 前者把整串输入压成一个向量,后者从这个向量写出一串输出 |
| BPTT | Backpropagation Through Time,随时间反向传播 | 把 RNN 按时间展开后做的反向传播 |
一个类比:边听边记的一张便签
朋友给你讲一个很长的故事,你手里只有一张便签,每听一句就改写一次。
规则固定:把旧便签和刚听到的这句话揉在一起,写成新便签。故事再长,便签也就这么大,改写规则从头到尾一样。
这就是 RNN:便签是隐藏状态 h,改写规则是那组共享参数 W。
这个类比还带出三件事。便签大小固定,故事越长,开头的细节越容易被挤掉。有的任务听完才说一句评价,有的每听一句就要回一句。翻译时可以换一个人:一人听完把要点写在便签上,另一人只看便签往外讲,这就是编码器和解码器。
类比在哪里失效:
- 改写规则不是人定的,是从数据里学出来的。
- 便签上是一组数,不是文字,人读不懂里面记了什么。
从零讲起
1. 五种序列结构
它解决什么问题
普通全连接网络和 CNN 都是一个输入对一个输出,输入大小还得固定。可很多任务的输入或输出是一串:一句话、一段视频、一段语音。动手前先得判断:这个任务是几个进、几个出?
直觉
画一排方块代表时间步。每个任务只是在这排方块的不同位置接输入、接输出。
判断时问三句话:输入几个?输出几个?要不要等全部读完才开始输出?
一步一步看
目标:用五个任务例子对照五种序列结构,看每种结构各进几个、出几个,什么时候输出。
-
一进一出(one to one):普通图像分类,没有序列。
-
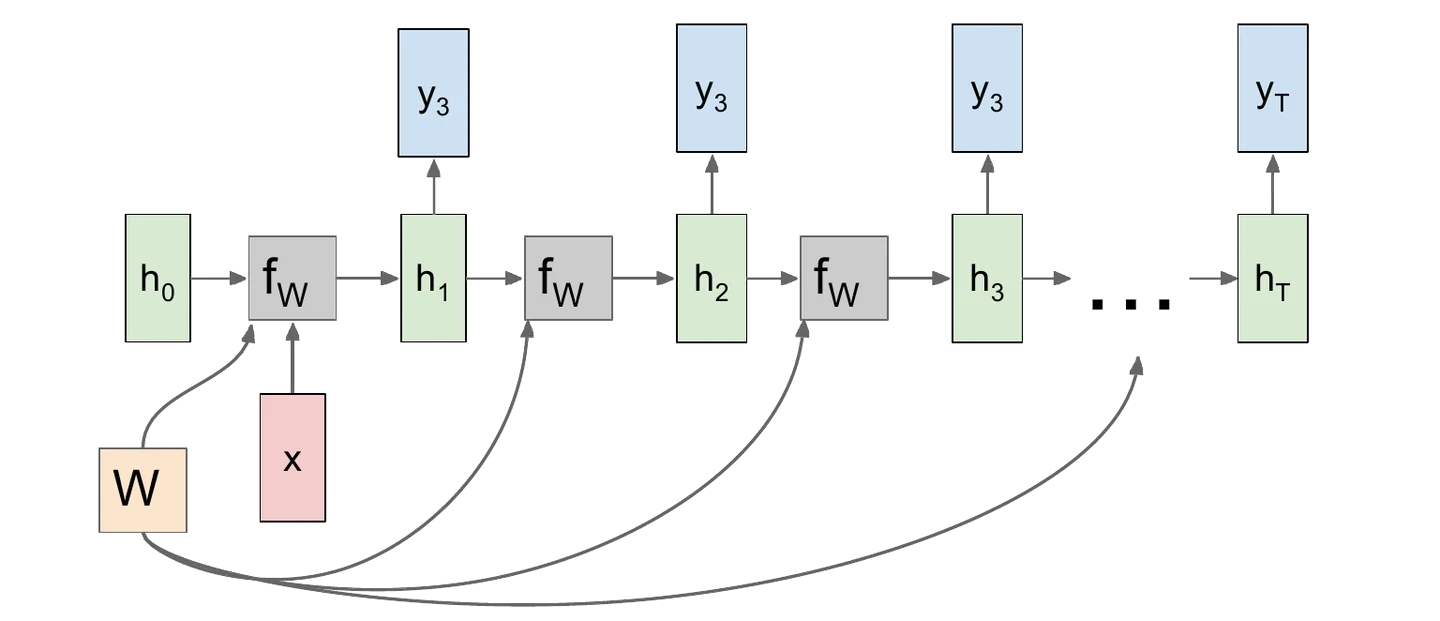
一进多出(one to many):看图说话,一张图写出一串词。
-
多进一出(many to one):情感分类,读完一句话给一个评价。
-
延迟式多进多出(many to many):机器翻译,读完整句再逐词输出。
-
同步式多进多出:逐帧视频分类,每读一帧就给一个标签。
怎么判断
先数输入和输出的个数,再看输出要不要等输入读完。
翻译要等,因为两种语言的词序不一定对得上。逐帧分类不用等,第 t 帧的标签只看前 t 帧就够。
常见误解
把机器翻译当成同步式 many to many
两种语言的词序不一定对应,读到一半没法翻。要先读完再生成,所以是延迟式。课件后面用 seq2seq 把它拆成编码器加解码器。
试一下
语音识别(一段音频转成一段文字)更像哪种结构?
输入是一串,输出也是一串,长度不同,词和音频帧也对不齐,更像延迟式 many to many。
2. 递推:每一步用同一个公式更新记忆
它解决什么问题
序列长度不定,网络却得是固定大小的。办法是把一个小网络反复调用:每读一个输入,就用它和上一步的记忆算出新记忆。
从哪来(补充)
早期的简单循环网络有两种:Jordan 1986 年提出的 Jordan network,和 Elman 1990 年提出的 Elman network。Elman 网络把隐藏层上一步的值存进一组 context units,下一步再读回来,这就是「隐藏状态」的雏形。
出处:Wikipedia: Recurrent neural network
直觉
新记忆 = 函数(旧记忆, 本步输入)。每一步用的是同一个函数、同一组参数 W。
最简单的版本叫 Vanilla RNN:旧记忆乘一个矩阵,本步输入乘另一个矩阵,相加后过 tanh 压到 −1 到 1 之间。
一步一步看
目标:用标量版 RNN 手算三步,看同一组权重反复用,只有记忆 h 在变,没有新输入时逐步衰减。
用一个标量版手算:W_hh = 0.5,W_xh = 1,h₀ = 0,输入序列 x = (1, 0, 0)。
-
第 1 步:读到 x₁ = 1,旧记忆是 0。
-
第 2 步:读到 x₂ = 0,旧记忆是 0.7616,没有新输入,记忆只剩一半多一点。
-
第 3 步:读到 x₃ = 0,记忆再减半。
-
三帧里的单元是同一个,W_hh 和 W_xh 一直没变。变的只是 h。
怎么算
hₜ = tanh(W_hh hₜ₋₁ + W_xh xₜ),yₜ = W_hy hₜ。
意思是:W_hh 把旧状态变到新状态,W_xh 把输入映射进状态,W_hy 把状态映射成输出。下标从后往前读:W_xh 是 x 到 h。
向量版里,三个矩阵的形状按「输出维 × 输入维」写:W_hh 是状态维 × 状态维,W_xh 是状态维 × 输入维,W_hy 是输出维 × 状态维。
常见误解
把「参数共享」理解成各时间步的状态一样
共享的是 W,每一步的 hₜ 当然不同。上面的例子里 W 从头到尾不变,h 从 0.7616 变到 0.3634 再到 0.1797。
试一下
同样的设定,输入改成 x = (1, 1, 0),h₂ 是多少?
h₂ = tanh(0.5 × 0.7616 + 1 × 1) = tanh(1.3808) ≈ 0.8811。新输入加进 tanh 里面,记忆被刷新。
3. 展开成计算图:损失和梯度都是加起来的
它解决什么问题
RNN 的单元自己连自己,看着像个环,没法直接套反向传播。把环按时间摊开,它就变成一个层数等于序列长度的普通网络,可以照常训练。
直觉
展开后,每个时间步一格,格与格之间用 h 连起来。每一格都用同一个 W。
many to many 时,每一步输出 yₜ 都和标签比一次,得到一个损失 Lₜ。总损失把它们加起来。W 出现了 T 次,它的梯度就是这 T 处梯度之和。在展开图上做的反向传播叫 BPTT。
一步一步看
目标:把 RNN 按时间展开后走一遍前向和反向,看总损失和 W 的梯度都是各步加起来的。
-
前向:从 h₀ 出发,依次算 h₁、h₂ 直到 hT,把每一步的 hₜ 都存下来。
-
每一步算输出 yₜ 和损失 Lₜ。
-
加总:L = L₁ + L₂ + … + LT。
-
反向:从 LT 开始往回传,每经过一格,就把这一格对 W 的梯度记一笔。
-
把每一笔加起来,得到 W 的总梯度,更新一次 W。
怎么算
L = Σₜ Lₜ,∂L/∂W = Σₜ ∂Lₜ/∂W。
意思是:总损失是每步损失之和;W 在每一步都出现,所以它的梯度也是每一步贡献之和。
常见误解
以为每个时间步各有一个 W 要更新
只有一个 W,它在计算图里出现了 T 次,梯度是这 T 处梯度之和,更新一次。时间步越早,梯度要穿过的计算越多,下一页的问题就出在这里。
试一下
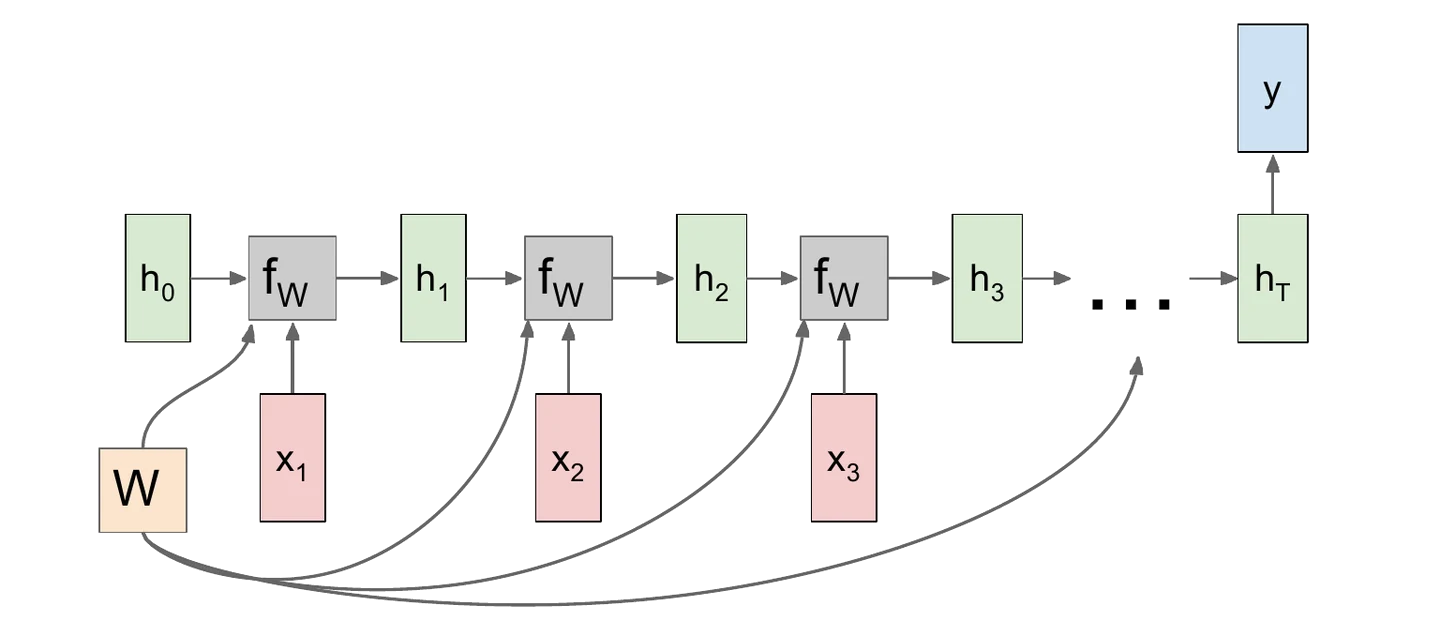
many to one 的展开图里,总损失由几项组成?
只有最后一步有输出,所以只有一项 LT。梯度仍然要从最后一步一路传回第 1 步。
4. seq2seq 与看图说话:把两种形状拼起来
它解决什么问题
翻译这类任务输入一串、输出另一串,长度还不一样。单靠一种形状接不住,就把两种拼起来。
从哪来(补充)
编码器—解码器结构的两篇源头论文是 Sutskever 等人和 Cho 等人在 2014 年的工作。整句压进一个向量是瓶颈,同年 Bahdanau 等人提出注意力机制来缓解。
直觉
编码器是 many to one,把整句读成一个向量 hT。解码器是 one to many,从这个向量出发逐步写出输出。
两段各用自己的参数:编码器用 W₁,解码器用 W₂。每段内部在时间上共享,两段之间不共享。
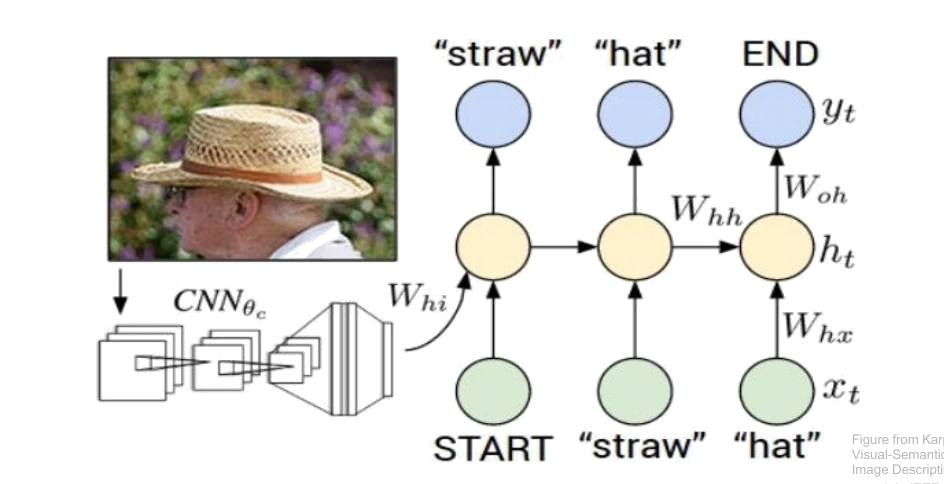
看图说话把编码器换成 CNN:图像特征接到 RNN 的第一个时间步,RNN 负责逐词写句子。
一步一步看
目标:跟着看图说话生成 straw hat,看 CNN 特征怎样接进 RNN,每步的输出又怎样当下一步输入。
课件的看图说话例子,生成「straw hat」:
-
图片先过 CNN,取出一组特征。
-
特征接到 RNN 的第一个时间步。
-
逐步生成,每一步把上一步输出的词当下一步输入:
时间步 输入 输出 1 START straw 2 straw hat 3 hat END -
输出 END,停止。
怎么判断
拿到一个「一串进、一串出」的任务,先问输入和输出能不能逐个对齐。对不齐就用编码器加解码器;对得齐就用同步式 many to many。
常见误解
以为编码器和解码器共用一组参数
课件写的是 W₁ 和 W₂,两段各自在时间上共享,彼此不共享。另外,整句原文只能通过一个向量传给解码器,句子很长时这个向量装不下。
试一下
看图说话属于五种结构里的哪一种?
one to many:只有一张图作为输入,输出一串词。CNN 当编码器,RNN 当解码器。
把它们串起来
序列长短不一、前后相关,全连接网络的输入维度在建网时就写死了,接不住。于是用同一个单元在每一步复用参数,隐藏状态当记忆。
任务的形状由三个问题决定:输入几个、输出几个、要不要先读完。五种结构只是在展开图的不同位置接输入和输出。
展开成计算图后,RNN 就是一个很深的普通网络,可以用反向传播训练。各步损失加成总损失,同一个 W 的梯度是各步梯度之和。
和 L07a 对照着记。CNN 在空间上共享滤波器,RNN 在时间上共享 W,两者都让参数量不随输入变大而增长。看图说话把两半接在一起:CNN 读图,RNN 逐词写句子。
课件里的坑
- [读图提醒] one to many 的展开图里输出标成 y3、y3、y3、yT,前两个应为 y1、y2,是标号笔误(p.69)。
- [读图提醒] 看图说话那页的矩阵写作 W_hx、W_oh,和 vanilla RNN 页的 W_xh、W_hy 是同一类东西,下标顺序不同(p.60、p.72)。
- [读图提醒] p.57 写的是在「某些」时间步输出,不必每步都输出,这句话对应前面不同的结构(p.57)。
- [课件留白] 延迟式 many to many 的图里前 3 步只有输入、第 3 到第 5 步才有输出,课件没有说明输出从哪一步开始由什么决定(p.54)。
课后 10 分钟:考点复习
这 10 分钟怎么用:前 3 分钟读必背 6 条,第 2、3 条要能默写公式;中间 4 分钟做课件例题和完整例题,看着 h 一步步变小;最后 3 分钟做变式题。
必背
- 序列任务五种形状:one to one、one to many(看图说话)、many to one(情感分类)、延迟式 many to many(机器翻译)、同步式 many to many(逐帧视频分类)
- RNN 递推 hₜ = f_W(hₜ₋₁, xₜ),每个时间步用同一个函数和同一组参数 W
- Vanilla RNN:hₜ = tanh(W_hh hₜ₋₁ + W_xh xₜ),yₜ = W_hy hₜ
- 展开成计算图后,总损失是各时间步损失之和,W 的梯度是各时间步对 W 的梯度之和
- seq2seq = 编码器(many to one,把输入压成一个向量)+ 解码器(one to many,从这个向量逐步生成),两段参数不同
- 看图说话:CNN 读图,特征接到 RNN 第一个时间步,从 START 开始逐词生成,上一步输出当下一步输入,直到 END
课件例题
例 1(课件 p.51–55):五个任务各属于哪种序列结构?
题面:普通图像分类、看图说话、情感分类、机器翻译、逐帧视频分类。
解答
依次是 one to one、one to many、many to one、延迟式 many to many、同步式 many to many。判断时问三句:输入几个、输出几个、要不要等读完。翻译要等整句读完;逐帧分类第 t 帧的输出只依赖前 t 帧,读到哪判到哪。
例 2(课件 p.58–59):为什么 RNN 能处理任意长的序列,参数量却不变?
题面:课件写 hₜ = f_W(hₜ₋₁, xₜ),并强调每个时间步用同一个函数和同一组参数。
解答
每一步都调用同一个 f_W,参数只有一份,与序列长度无关;隐藏状态 h 是固定长度的向量,读 3 个词还是 300 个词维度都一样,后面的层才接得上。代价是长序列被压进同样大的空间,早的输入容易被挤掉。
例 3(课件 p.60):vanilla RNN 里三个矩阵各管什么?
题面:hₜ = tanh(W_hh hₜ₋₁ + W_xh xₜ),yₜ = W_hy hₜ。
解答
W_hh 把旧状态变到新状态,W_xh 把输入映射进状态,W_hy 把状态映射成输出。下标从后往前读:W_xh 是 x → h。
例 4(课件 p.61–67):many to many 展开图里,总损失怎么来?W 的梯度怎么算?
题面:每步输出 yₜ 对应一个损失 Lₜ,同一个 W 连到每一个 f_W。
解答
L = L₁ + L₂ + … + LT。W 在计算图里出现 T 次,梯度是各时间步对 W 的梯度之和。前向从 h₀ 算到 hT 并存下每步的 hₜ,反向从最后一步往前传。
例 5(课件 p.68–69):many to one 和 one to many 的输出分别接在哪里?
题面:情感分类用 many to one;one to many 只在开头给一个输入。
解答
many to one 只在最后一步 hT 输出一个 y,整条序列的信息都得挤进 hT;句子越长,开头的词要经过越多次更新才能影响结果。one to many 只在第一步有输入 x,之后每步都输出一个 y,图上前两个 y3 应读作 y1、y2。
例 6(课件 p.70–71):机器翻译为什么拆成编码器和解码器?两段共享参数吗?
题面:seq2seq = many to one + one to many。
解答
编码器(many to one)先读完整句,压成向量 hT;解码器(one to many)从 hT 出发逐步生成译文,图上没有外部输入 x。编码器用 W₁、解码器用 W₂,各自在时间上共享,彼此不共享。
例 7(课件 p.72–73):看图说话系统怎样生成 straw hat 这句话?
题面:CNN 参数 θc,图像特征经 W_hi 接到 RNN;RNN 的矩阵有 W_hh、W_hx、W_oh。
解答
图像先过 CNN 取特征,接到 RNN 第一个时间步。第一步输入 START,输出 straw;下一步把 straw 当输入,输出 hat;再下一步输出 END 结束。CNN 是编码器,RNN 是解码器,属于 one to many。
完整例题
题面(自编情境):标量 vanilla RNN,W_hh = 0.5,W_xh = 1,h₀ = 0,输入序列 x = (1, 0, 0)。(a) 求 h₁、h₂、h₃。(b) 若改成向量版:输入 50 维、状态 100 维、输出 10 维,不计偏置共有多少权重?
解法:
- h₁ = tanh(0.5 × 0 + 1 × 1) = tanh(1) ≈ 0.7616。
- h₂ = tanh(0.5 × 0.7616 + 0) = tanh(0.3808) ≈ 0.3634。
- h₃ = tanh(0.5 × 0.3634 + 0) = tanh(0.1817) ≈ 0.1797。
- 矩阵形状:W_hh 为 100×100,W_xh 为 100×50,W_hy 为 10×100。
- 权重总数:10000 + 5000 + 1000 = 16000。
要点:(a) 里第 1 步的输入在后面没有新输入时每步大约减半,记忆在衰减,反向传播时梯度也会以类似方式衰减,下一页会讲这一点。(b) 的数和序列长度无关,序列长 5 还是 500 都是 16000。
答题格式:每一步写出代入后的完整式子再给数值;矩阵形状按「输出维 × 输入维」写,先列形状再相乘。
变式题(先自己做)
自编情境:标量 vanilla RNN,W_hh = 0.5,W_xh = 1,h₀ = 0。
(a) 输入序列改成 x = (1, 1, 0),求 h₁、h₂、h₃。 (b) 向量版输入 20 维、状态 30 维、输出 5 维,不计偏置共有多少权重? (c) 情感分类和逐帧视频分类,哪个只需要在最后一步接输出?
提示
(a) 第 2 步多了一个输入 1,要加进 tanh 里面。(b) 三个矩阵形状分别是 状态×状态、状态×输入、输出×状态。(c) 想想每个任务要几个标签。
判分点与答案(非官方评分标准)
判分点:① h₂ 的 tanh 里同时有旧状态和新输入;② (b) 写出三个矩阵形状;③ (c) 说出结构名。
(a) h₁ = tanh(1) ≈ 0.7616;h₂ = tanh(0.5 × 0.7616 + 1) = tanh(1.3808) ≈ 0.8811;h₃ = tanh(0.5 × 0.8811) = tanh(0.4406) ≈ 0.4141。
(b) W_hh 30×30 = 900,W_xh 30×20 = 600,W_hy 5×30 = 150,共 1650。
(c) 情感分类,many to one,只在 hT 接输出;逐帧视频分类是同步式 many to many,每步都输出。
闪卡自测
1. 机器翻译、情感分类、看图说话、逐帧视频分类各是哪种结构?
延迟式 many to many、many to one、one to many、同步式 many to many(p.52–55)。
2. RNN 的递推公式是什么?课件强调哪一点?
hₜ = f_W(hₜ₋₁, xₜ);每个时间步用同一个函数 f_W 和同一组参数 W(p.58、p.59)。
3. 写出 vanilla RNN 的状态更新和输出公式。
hₜ = tanh(W_hh hₜ₋₁ + W_xh xₜ),yₜ = W_hy hₜ(p.60)。
4. many to many 展开图里,总损失怎么来?W 的梯度怎么算?
各步损失 Lₜ 相加得 L;W 在每一步都出现,梯度是各步梯度之和(p.64–67)。
5. seq2seq 由哪两部分组成?两部分共享参数吗?
编码器(many to one,把输入压成一个向量)和解码器(one to many,从这个向量逐步生成);两部分用不同参数 W₁、W₂(p.70、p.71)。
6. 看图说话里 RNN 第一步的输入是什么?什么时候停?
第一步输入特殊符号 START,之后每步把上一步的输出词当输入,输出 END 时停止(p.72)。
下一讲
L07b-2 接着回答这页留下的问题:梯度要穿过同一个 W 很多次,为什么会爆炸或消失,裁剪又能治哪一种。去之前把完整例题的 h₁ 到 h₃ 再算一遍,记住每步大约减半。
上一讲是 L07a-3:参数量与池化。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。