L06d softmax、损失函数与梯度下降:训练在优化什么
多分类时输出层怎样用 softmax 把分数变成概率;回归和分类各用什么损失,交叉熵为什么必须带负号;梯度下降为什么朝斜率的反方向走。
一句话版
训练网络要回答三个问题:输出怎么变成概率、预测错了罚多少、参数往哪个方向改。
多分类时,输出层用 softmax 把每类的分数变成加起来等于 1 的概率。回归的损失用平方误差,分类用交叉熵。参数的改法是梯度下降:算出损失对参数的斜率,朝相反方向走一小步。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| softmax | 读「软max」 | 把一串分数变成一串加起来等于 1 的概率 |
| one-hot | 读「万哈特」 | 真实标签的写法:正确类记 1,其余全记 0 |
| 损失 / 目标函数 | loss / objective | 预测和正确答案差多远的一个数,训练就是让它变小 |
| 交叉熵 | cross-entropy,即负对数似然 | 分类用的损失,给正确类的概率越低罚得越重 |
| 梯度 | gradient | 损失对每个参数的斜率 |
| 学习率 η | learning rate,读「伊塔」 | 每一步走多远 |
一个类比:蒙眼下山
蒙着眼站在山坡上,要走到山谷最低处。看不见全貌,只能用脚感受脚下往哪边倾斜。
脚下往右低,就往右迈一步;往左低,就往左迈。每迈一步重新感受一次。坡越陡,说明离谷底可能还远;快到谷底时地面变平,步子自然变小。
这就是梯度下降。山的高度是损失,你站的位置是参数,脚下的倾斜就是斜率。
类比在哪里失效:
- 真实的山是二维的。网络的参数有成千上万个,梯度下降是在每个方向上同时按各自的斜率走。
- 下山时你能决定步子大小。梯度下降的步长由学习率乘斜率决定,步长太大会直接迈过谷底。
从零讲起
1. softmax:多分类的输出层
它解决什么问题
前几页的网络只有一个输出 y,用 sigmoid 给出「属于正类」的概率,只能做二分类。如果要分 K 类,比如手写数字 0 到 9,就要 K 个输出,每类一个。它们必须都是正数,而且加起来等于 1,才能当概率用。
从哪来(补充)
softmax 的公式最早出现在统计力学里:Ludwig Boltzmann 在 1868 年用它描述粒子处在不同能量状态的概率,所以也叫 Boltzmann 分布。「softmax」这个名字是 John S. Bridle 在 1989 年的两篇会议论文里起的,论文于 1990 年发表。
出处:Wikipedia: Softmax function
直觉
每类先算一个分数,分数可正可负。要变成概率,分两步:先取 exp,把所有分数变成正数;再除以总和,让它们加起来等于 1。
exp 还有一个效果:分数之间的差距会被放大。分数最高的那类拿走的份额,比它在原始分数里的占比更大。
一步一步看
目标:拿三类分数走一遍取 exp、求和、相除,看结果全为正、加起来是 1,最高分拿到最大概率。
拿三类分数 b = (2.0, 1.0, 0.1) 算一遍。
-
取 exp:e^2.0 = 7.3891,e^1.0 = 2.7183,e^0.1 = 1.1052。三个都是正数。
-
求和:7.3891 + 2.7183 + 1.1052 = 11.2125。
-
每个除以总和:7.3891 / 11.2125 = 0.659,2.7183 / 11.2125 = 0.2424,1.1052 / 11.2125 = 0.0986。
-
检查:0.659 + 0.2424 + 0.0986 = 1。分数最高的第 1 类拿到最大的概率。
怎么算
输出层先为每类算一个分数:bₖ = Σⱼ βₖⱼ zⱼ
意思是:K 个输出节点各有一组自己的权重,所以 β 从向量变成矩阵 βₖⱼ,每类各自对隐藏层做一次加权求和。
再过 softmax:yₖ = exp(bₖ) / Σₗ₌₁ᴷ exp(bₗ)
意思是:第 k 类的概率 = 它的 exp 分数占所有 exp 分数之和的比例。
K = 2 时,softmax 退化成 sigmoid。两类分数 b₁、b₂ 的 softmax 第一项 = 1 / (1 + exp(b₂ − b₁)) = σ(b₁ − b₂)。
常见误解
以为 softmax 就是把分数除以分数之和
不能直接除,分数可能是负数,直接除得不到合法概率。要先取 exp 变成正数再除。
以为 softmax 会改变分数的排名
不会。exp 是单调递增的,分数高的类概率也高。softmax 改变的是差距的大小,排名不变。
试一下
三类分数都是 0,softmax 输出是多少?
e⁰ = 1,三个都是 1,总和 3,每类 1/3 ≈ 0.3333。分数一样,概率就平分。
2. 损失函数:平方损失与交叉熵
它解决什么问题
模型给出了预测,要有一个数衡量它错得多厉害,训练才知道往哪改。课件的规则是:回归用平方损失,和线性回归一样;分类用交叉熵,和逻辑回归一样。
直觉
平方损失看预测值和真实值差多少,差得越多罚得越重,按平方增长。
交叉熵只看模型给正确类的概率 p,损失是 −log p。p 接近 1,损失接近 0;p 接近 0,损失飙升。模型越自信地给错答案,罚得越狠。
一步一步看
目标:同一个预测分别算平方损失和交叉熵,看正确类概率越低,交叉熵罚得越重。
-
平方损失:预测 y = 0.8,真实 y* = 1。J = ½ × (0.8 − 1)² = ½ × 0.04 = 0.02。
-
交叉熵,同样 y = 0.8、y* = 1:J = −log 0.8 = 0.2231。
-
交叉熵,模型只给正确类 0.2:J = −log 0.2 = 1.6094,罚得重了很多。
-
多分类:上面 softmax 的例子,若真实类是第 1 类,J = −log 0.659 = 0.417。
-
把两种损失放进一张表:
| 损失 | J | dJ/dy | 用在 |
|---|---|---|---|
| 平方损失 | ½(y − y*)² | y − y* | 回归 |
| 交叉熵(二分类) | −[y* log y + (1 − y*) log(1 − y)] | −y*/y + (1 − y*)/(1 − y) | 分类 |
怎么算
平方损失:J = ½(y − y*)²
意思是:预测减真实值,平方,再乘一半。乘 ½ 是为了求导后把平方带下来的 2 消掉,导数正好是 y − y*。
多分类交叉熵:J = −Σₖ yₖ* log yₖ
意思是:y* 是 one-hot 向量,只有正确类那一项是 1,所以求和只剩一项,J = −log(模型给正确类的概率)。
二分类交叉熵:J = −[y* log y + (1 − y*) log(1 − y)]
意思是:y* = 1 时只剩 −log y;y* = 0 时只剩 −log(1 − y)。两种情况都是「−log 模型给正确答案的概率」。
前面的负号必不可少。log p 在 p ≤ 1 时总是 ≤ 0,越大越好,这叫对数似然;加上负号变成 ≥ 0、越小越好,才能当损失去最小化。
常见误解
照抄课件的交叉熵公式
课件多分类那页的 (F) 和损失表里,交叉熵都写成 J = Σ y* log y,前面少了负号。不带负号的是对数似然,值 ≤ 0、越大越好;用梯度下降去最小化它,会把正确类的概率往小推。课件同页文字写着「negative log likelihood」,「negative」就是这个负号。
以为分类也可以随便用平方损失
课件的规则是分类用交叉熵。交叉熵需要概率,所以要在网络末端加 softmax 层(二分类就是 sigmoid)。
试一下
二分类,y* = 0,模型输出 y = 0.9。交叉熵是多少?
y* = 0 时只剩 −log(1 − y) = −log 0.1 ≈ 2.3026。模型很自信地答错,罚得很重。
3. 梯度下降:朝斜率的反方向走
它解决什么问题
有了损失,下一步是找让损失最小的参数。网络的参数太多,没法直接解方程。课件先拿一个参数 w 来看:给定当前的 w,应该调大还是调小?
从哪来(补充)
梯度下降一般归功于 Augustin-Louis Cauchy,他在 1847 年首次提出这个方法。Jacques Hadamard 在 1907 年独立提出了类似的方法。
出处:Wikipedia: Gradient descent
直觉
斜率告诉你:w 往右挪一点,损失会变大还是变小。斜率为负,往右损失下降,就把 w 调大;斜率为正,往左损失下降,就把 w 调小。
所以每一步都朝斜率的反方向走。走多远由学习率 η 乘斜率决定,斜率越大步子越大,越接近谷底斜率越小、步子越小。
一步一步看
目标:在 (w − 3)² 上从 w = 0 走三步梯度下降,看斜率和步子一起变小,w 逐步逼近 3。
损失 Loss(w) = (w − 3)²,最低点在 w = 3。从 w¹ = 0 出发,学习率 η = 0.1。
-
在 w¹ = 0:斜率 2(w − 3) = 2 × (0 − 3) = −6。斜率为负,往右走:w² = 0 − 0.1 × (−6) = 0.6。
-
在 w² = 0.6:斜率 2 × (0.6 − 3) = −4.8,w³ = 0.6 − 0.1 × (−4.8) = 1.08。
-
在 w³ = 1.08:斜率 2 × (1.08 − 3) = −3.84,w⁴ = 1.08 + 0.384 = 1.464。
-
三步的损失依次是:
| 步 | w | 斜率 | Loss |
|---|---|---|---|
| 1 | 0 | −6 | 9 |
| 2 | 0.6 | −4.8 | 5.76 |
| 3 | 1.08 | −3.84 | 3.6864 |
- 斜率越来越小,步子也越来越小,w 一点点逼近 3。
怎么算
单个参数:w ← w − η × dLoss/dw
意思是:新 w = 旧 w 减去「学习率乘斜率」。减号就是「反方向」:斜率为负时减一个负数,w 变大。
课件的 SGD 写法:θ⁽ᵗ⁺¹⁾ = θ⁽ᵗ⁾ − η_t ∇ℓ(f_θ(xᵢ), yᵢ)
意思是:所有参数排成向量 θ,同时按各自的斜率更新。η_t 的下标 t 表示学习率可以随步数变。∇ℓ 只用一个样本 i 的损失,这就是「随机」的含义,所以单步不保证总损失一定下降。
常见误解
以为斜率为负就该把 w 调小
反了。斜率为负说明往右走损失下降,w 要变大。更新式里的减号已经处理了方向:w − η × (负数) = w 变大。
以为梯度下降一定能走到最低点
课件的曲线在最低点右侧还有一段平台再上升,说明一般的损失不是碗形,梯度下降可能停在平台或局部低谷。课件只画出了形状,没有展开。
试一下
同样 Loss = (w − 3)²,从 w = 0 出发,把学习率改成 η = 0.5,一步走到哪?改成 η = 1 呢?
η = 0.5:w = 0 − 0.5 × (−6) = 3,一步到谷底。η = 1:w = 0 − 1 × (−6) = 6,斜率变成 2 × (6 − 3) = 6,下一步 w = 6 − 6 = 0,在 0 和 6 之间来回跳,永远到不了 3。学习率太大会迈过谷底。
把它们串起来
二分类的网络输出一个 sigmoid 概率。多分类时,输出层给每类算一个分数,再用 softmax 先取 exp 再除以总和,得到一组为正、加起来等于 1 的概率。
预测好不好用损失来量:回归用平方损失,分类用交叉熵。交叉熵就是 −log(模型给正确类的概率),前面的负号必不可少,课件有几处漏了。
训练就是让损失变小,方法是梯度下降:算出损失对参数的斜率,朝相反方向走一小步,步长是学习率乘斜率。SGD 每步只用一个样本的损失。
单个参数的斜率好算。网络里每个权重的斜率怎么算,是下一页反向传播的内容。
课件里的坑
- [⚠️ 课件有误] 多分类 (F) 写成 J = Σₖ yₖ* log(yₖ),前面少了负号,应为 J = −Σₖ yₖ* log(yₖ)(p.30)
- [⚠️ 课件有误] 损失表的交叉熵 J = y* log(y) + (1 − y*) log(1 − y) 少了负号,和同页「negative log likelihood」的文字矛盾;表里的导数和原式是配套的,换成带负号的 J 后导数也要变号(p.43)
- [读图提醒] 梯度下降动画的曲线在最低点右侧还有一段平台,一般损失不是碗形,课件没展开(p.44–46)
- [符号提醒] 多分类那页的网络图把隐藏节点标成 a₁…a_D,和五步公式里的 z 指同一层(p.30)
课后 10 分钟:考点复习
这 10 分钟怎么用:先默写 softmax 和交叉熵的公式,交叉熵一定写负号;再用 (2.0, 1.0, 0.1) 算一遍 softmax;然后在纸上走三步梯度下降;最后做课件例题和变式题。
必背
- 多分类输出层用 softmax:yₖ = exp(bₖ) / Σₗ exp(bₗ),每个输出为正,K 个加起来等于 1
- 交叉熵损失要带负号:J = −Σₖ yₖ* log yₖ;课件 (F) 和损失表漏了负号,按原式做梯度下降方向会反
- 回归用平方损失 J = ½(y − y*)²,导数 y − y*;分类用交叉熵(负对数似然),需要在网络末端加 softmax
- 梯度下降朝斜率的反方向走:斜率为负就把 w 调大,斜率为正就把 w 调小
- SGD 更新:θ⁽ᵗ⁺¹⁾ = θ⁽ᵗ⁾ − η_t ∇ℓ,每次只用一个样本的损失
课件例题
例 1(课件 p.29–30):输出改成 K 类时,(D)(E)(F) 三步怎么改?
题面:每个类别一个输出节点,β 从向量变成矩阵 βₖⱼ。
提示
(D) 每类一个分数;(E) 换掉 sigmoid;(F) 是新增的损失,注意符号。
解答
(D) bₖ = Σⱼ βₖⱼzⱼ,每类一个分数;(E) yₖ = exp(bₖ)/Σₗ exp(bₗ),输出为正且总和为 1;(F) J = −Σₖ yₖ* log yₖ,y* 是真实标签的 one-hot 向量。课件 (F) 漏了负号,按带负号的写。
例 2(课件 p.43):回归和分类各用什么损失?表里交叉熵那一行哪里不对?
题面:表中 Quadratic:J = ½(y − y*)²,dJ/dy = y − y*;Cross Entropy:J = y* log y + (1 − y*) log(1 − y)。
提示
对照同页文字「negative log likelihood」,看公式里缺了什么。
解答
回归用平方损失,½ 是为了求导后消掉 2。分类用交叉熵,需要概率,所以末端加 softmax。表里交叉熵少了负号,应为 J = −[y* log y + (1 − y*) log(1 − y)],对应 dJ/dy = −y*/y + (1 − y*)/(1 − y)。
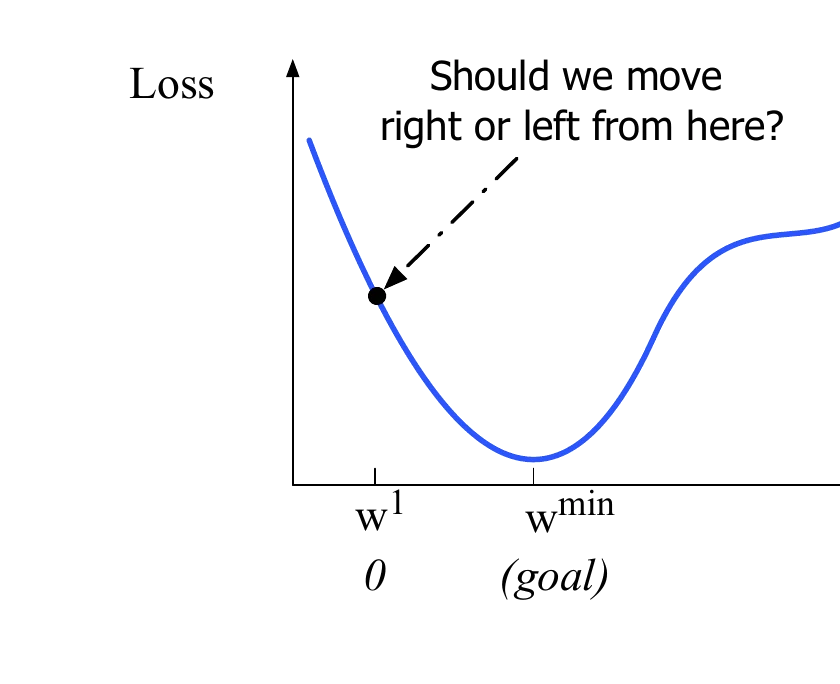
例 3(课件 p.44–46):当前 w 处斜率为负,w 该调大还是调小?
题面:曲线是 Loss 关于 w 的函数,起点 w¹ = 0,目标是最低点。
提示
斜率为负,意味着往右走损失怎样变化?
解答
调大。朝斜率的反方向移动:斜率为负,就往正方向走一步,损失变小。课件蓝字总结:在当前点求损失的梯度,然后朝相反方向走。
例 4(课件 p.15):SGD 的更新式里每个符号是什么意思?
题面:θ⁽ᵗ⁺¹⁾ = θ⁽ᵗ⁾ − η_t ∇ℓ(f_θ(xᵢ), yᵢ),课件括号里写着「朝梯度的反方向走小步」。
提示
分别说 t、η_t、∇ℓ、下标 i 的含义,再说「随机」体现在哪。
解答
θ⁽ᵗ⁾ 是第 t 步的参数,η_t 是学习率(可以随步数变),∇ℓ 是单个样本 i 的损失对参数的梯度,减号表示朝反方向走。每步只用一个样本,这就是「随机」,所以单步不保证总损失下降。
完整例题
题面(改编自课件 p.30 和 p.43):一个三分类网络的输出层分数是 b = (2.0, 1.0, 0.1)。(a) 求 softmax 输出。(b) 真实类别是第 1 类,求交叉熵。(c) 真实类别若是第 2 类,交叉熵是多少?(d) 若照抄课件不带负号的公式,(b) 会得到什么,为什么不能拿它当损失?
解法:
- (a) 取 exp:(7.3891, 2.7183, 1.1052),总和 11.2125。
- (a) 除以总和:y = (0.659, 0.2424, 0.0986),加起来等于 1。
- (b) one-hot y* = (1, 0, 0),求和只剩第 1 项:J = −log 0.659 = 0.417。
- (c) y* = (0, 1, 0):J = −log 0.2424 = 1.417,模型给正确类的概率低,罚得重。
- (d) 不带负号:J = log 0.659 = −0.417。它总是 ≤ 0,越大说明预测越好;对它做梯度下降(求最小),会把正确类的概率往小推,方向反了。
要点:交叉熵 = −log(正确类的概率),one-hot 让求和只剩一项。
答题格式:先写 exp 和总和,再写各类概率,最后写「J = −log(正确类概率)= 数值」,并注明带负号。
变式题(先自己做)
(1) 自编情境:三类分数 (1, 1, 0),求 softmax 输出;真实类为第 3 类时交叉熵是多少? (2) 改编自课件 p.43:y = 0.8,分别求 y* = 1 时的平方损失和交叉熵,以及两者对 y 的导数。 (3) 改编自课件 p.44–46:Loss(w) = (w − 3)²,从 w = 5 出发,η = 0.1,走一步到哪?往哪个方向?
提示
(1) 前两类分数相同,概率也相同。(2) 交叉熵导数用 −y*/y + (1 − y*)/(1 − y)。(3) 先算斜率的正负。
判分点与答案(非官方评分标准)
判分点:① softmax 三个概率之和为 1;② 交叉熵带负号、结果为正;③ 梯度下降的方向与斜率相反。
(1) exp 为 (2.7183, 2.7183, 1),总和 6.4366,softmax = (0.4223, 0.4223, 0.1554)。J = −log 0.1554 = 1.862。
(2) 平方损失 J = ½ × (0.8 − 1)² = 0.02,导数 y − y* = −0.2。交叉熵 J = −log 0.8 = 0.2231,导数 −1/0.8 = −1.25。两个导数都为负,都要把 y 往大推。
(3) 斜率 2 × (5 − 3) = 4,为正,往左走:w = 5 − 0.1 × 4 = 4.6。
闪卡自测
1. softmax 的公式?它保证了什么?
yₖ = exp(bₖ)/Σₗ exp(bₗ);每个输出为正、K 个加起来等于 1(p.30)。
2. 多分类时 β 的形状怎么变?
从向量变成矩阵 βₖⱼ,每个输出类各有一组权重(p.29)。
3. 回归和分类各用什么损失?
回归用平方损失 ½(y − y*)²;分类用交叉熵,末端加 softmax(p.43)。
4. 课件的交叉熵公式错在哪?
少了负号。不带负号的是对数似然,最小化它方向会反(p.30、p.43)。
5. 平方损失前面为什么乘 ½?
求导时把平方带下来的 2 消掉,导数正好是 y − y*(p.43)。
6. 斜率为负时 w 往哪调?
调大。梯度下降朝斜率的反方向走(p.44–46)。
7. SGD 里的「随机」指什么?
每步只用一个样本的损失算梯度,所以单步不保证总损失下降(p.15)。
下一讲
梯度下降要用到每个权重的斜率。网络里几百个权重的斜率怎样一次算出来,见 L06e。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。