L06a 逻辑回归:一个 sigmoid 神经元
从「判别式分类器」的四个部件讲起,弄懂 sigmoid 怎样把任意分数压成概率,再一步一步算一遍逻辑回归,看清它为什么就是神经网络里的一个神经元。
一句话版
逻辑回归先把每个特征乘上自己的权重再加起来,得到一个分数;再用 sigmoid 函数把这个分数压成 0 到 1 之间的数,当作「属于正类」的概率。
把这两步画成图,就是神经网络里的一个神经元。这一讲后面的隐藏层、激活函数、反向传播,都是在这个神经元上加东西。所以这一页先把它从零讲透。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 特征 x | feature | 描述一个样本的一串数,比如「评论里有没有出现 awesome」 |
| 权重 θ | weight,读「西塔」 | 每个特征有多重要、往哪个方向推 |
| 偏置 | bias,课件写成 θ₀ 配一个恒为 1 的 x₀ | 不看任何特征时的起始分 |
| 加权和 z | weighted sum,也写 θᵀx | 特征乘权重再加起来得到的分数 |
| sigmoid σ | 读「西格玛」,又叫 logistic 函数 | 把任意分数压成 0 到 1 之间的函数 |
| 判别式模型 | discriminative model | 只学「给定 x,y 是哪类」,不管每类数据长什么样 |
| 交叉熵 | cross-entropy | 衡量预测概率和真实标签差多远的损失 |
一个类比:面试打分表
公司招人,面试官手上有一张打分表:学历加几分,相关经验加几分,迟到扣几分。每一项的分值不同,重要的项分值大,减分的项是负数。把一个人各项的得分加起来,就是他的总分。
总分可以是 37,也可以是 −5,本身不是概率。于是人事部再拿一张换算表:总分很高的,录用可能性接近 1;总分很低的,接近 0;总分在中间的,五五开。
逻辑回归就是这两张表。打分表是加权求和,换算表是 sigmoid。
类比在哪里失效:
- 面试官的分值是人定的。逻辑回归的权重是从数据里学出来的,下一讲到的梯度下降就是在调这些分值。
- 换算表可以随便画。sigmoid 的形状是固定的 S 形,只有一种。
从零讲起
1. 判别式分类器长什么样
它解决什么问题
给一张图片,判断是猫还是狗。这种「把东西分进几个类」的任务叫分类。解分类题有两大思路,逻辑回归和神经网络都属于其中一种。先弄清是哪一种,后面才知道它到底在学什么。
直觉
生成式的做法是先学会「猫长什么样」「狗长什么样」,各画一幅画像。来一张新图,拿去和两幅画像比,更像哪个就判哪个。
判别式不画画像,只找区分两类的规则。课件举的例子是「狗戴项圈」:看到项圈就判狗,其他都不管。它省事,因为不用把每类的样子全学会。
一步一步看
目标:把生成式和判别式并排比,看判别式只画一条分界线,再看逻辑回归在四个部件上各选了什么。
-
生成式:给每一类各建一个模型,描述这一类的数据长什么样;来了新样本,看哪个模型更能解释它。
-
判别式:只画一条分界线,新样本落在线的哪一边就判哪一类。
-
把两种思路并排放进一张表:
| 判别式 | 生成式 | |
|---|---|---|
| 学什么 | p(y|x):给定 x,是哪一类 | p(x, y):x 和 y 一起怎么出现,再推出 p(y|x) |
| 代表模型 | 逻辑回归、SVM | 朴素贝叶斯 |
| 擅长 | 数据分布很复杂时(文本、图像) | 处理缺失变量、容易加先验知识 |
- 判别式分类器都由四个部件拼成。逻辑回归在每个部件上的具体选择:
| 部件 | 逻辑回归的选择 |
|---|---|
| 特征表示 | x = [x₁, …, xₙ],比如「评论里有没有某个词」 |
| 分类函数 | sigmoid(二分类)或 softmax(多分类) |
| 目标函数 | 交叉熵损失 |
| 优化算法 | 随机梯度下降 SGD |
怎么判断
拿到一个模型,问一句:它有没有去学「每一类的数据长什么样」?
- 学了,能反过来生成一个像猫的样本,就是生成式。朴素贝叶斯先学 p(x|y) 和 p(y),用贝叶斯公式才得到 p(y|x)。
- 没学,直接从 x 算出 y 的概率,就是判别式。逻辑回归一上来就算 p(y=1|x)。
神经网络也是判别式。放进上面那张四部件表,它只换掉「分类函数」这一行:从一层 sigmoid 换成多层加权求和加非线性。目标函数和优化算法照旧。
常见误解
以为判别式总比生成式好
课件只说判别式在数据分布复杂时通常表现好。生成式也有自己的长处:能处理缺失变量,也容易把先验知识加进去。考试问对比,两边的优点都要写。
以为「狗戴项圈」只是个省事的好例子
它也暗示了判别式的风险。如果训练集里恰好只有狗戴项圈,模型学到的是「项圈」,换一批不戴项圈的狗就会认错。
试一下
一个垃圾邮件过滤器先分别统计「垃圾邮件里常见哪些词」「正常邮件里常见哪些词」,再看新邮件更像哪一类。它是判别式还是生成式?
生成式。它对每一类分别建了模型,描述这一类邮件长什么样,再比较新邮件和哪一类更像。朴素贝叶斯垃圾邮件过滤就是这样做的。
2. sigmoid:把分数压成概率
它解决什么问题
加权和 z = θᵀx 是一个实数,可以是 37,也可以是 −5。分类要的是概率,必须落在 0 到 1 之间。需要一个函数,吃进任意实数,吐出 0 到 1 之间的数,而且分数越高概率越大。
从哪来(补充)
sigmoid 在统计里叫 logistic 函数,最早用来描述人口增长。比利时数学家 Pierre François Verhulst 在 1838 到 1847 年的三篇论文里提出它:人口一开始近似按指数增长,越接近上限增长越慢,最后停在上限附近,画出来正好是一条 S 形曲线。logistique 这个名字是他在 1845 年发表的论文里起的。
出处:Wikipedia: Logistic function
直觉
z 很大,e^(−z) 几乎是 0,1/(1 + 0) 接近 1。z 很小(很负),e^(−z) 是个巨大的数,1 除以它接近 0。z = 0 时,e⁰ = 1,结果正好是 1/2。
所以 sigmoid 中间一段接近直线,两头被压平。分数离 0 越远,概率越贴近 0 或 1,但永远到不了。
一步一步看
目标:代入几个 z 看 σ(z) 和斜率怎么变,看出 z = 0 处最陡、两头越来越平,而且左右对称。
- 代入几个 z,看输出怎么变:
| z | −4.6 | −2 | 0 | 2 | 4 | 6 |
|---|---|---|---|---|---|---|
| σ(z) | 0.0100 | 0.1192 | 0.5 | 0.8808 | 0.9820 | 0.9975 |
| 斜率 σ(1 − σ) | 0.0099 | 0.105 | 0.25 | 0.105 | 0.0177 | 0.0025 |
-
把这些点连起来,就是下面这条 S 形曲线。青绿虚线是 z = 0 处的切线,斜率 0.25,是整条曲线最陡的地方。
-
看斜率那一行:z = 2 时斜率已降到 0.105,z = 6 时只剩 0.0025。z 再变大,输出几乎不动。
-
左右对称:σ(−2) 和 σ(2) 加起来正好是 1。一般地,σ(−z) = 1 − σ(z)。
怎么算
σ(z) = 1 / (1 + e^(−z))
意思是:先把 z 取负再做指数,加 1,最后取倒数。z 越大,分母越接近 1,结果越接近 1。
它的导数可以用它自己表示:
σ′(z) = σ(z) × (1 − σ(z))
意思是:知道了输出 σ,不用重新求导,直接拿 σ 乘 (1 − σ) 就是斜率。z = 0 时 σ = 0.5,斜率 = 0.5 × 0.5 = 0.25,这是最大值。反向传播时这个式子会反复出现。
二分类时,属于正类的概率是 p(y=1|x) = σ(z),属于负类的概率是 p(y=0|x) = 1 − σ(z)。
常见误解
以为 sigmoid 输出能等于 0 或 1
不能。e^(−z) 永远大于 0,所以 σ(z) 永远严格落在 0 和 1 之间。σ(10) ≈ 0.99995 已经很接近 1,但不是 1。
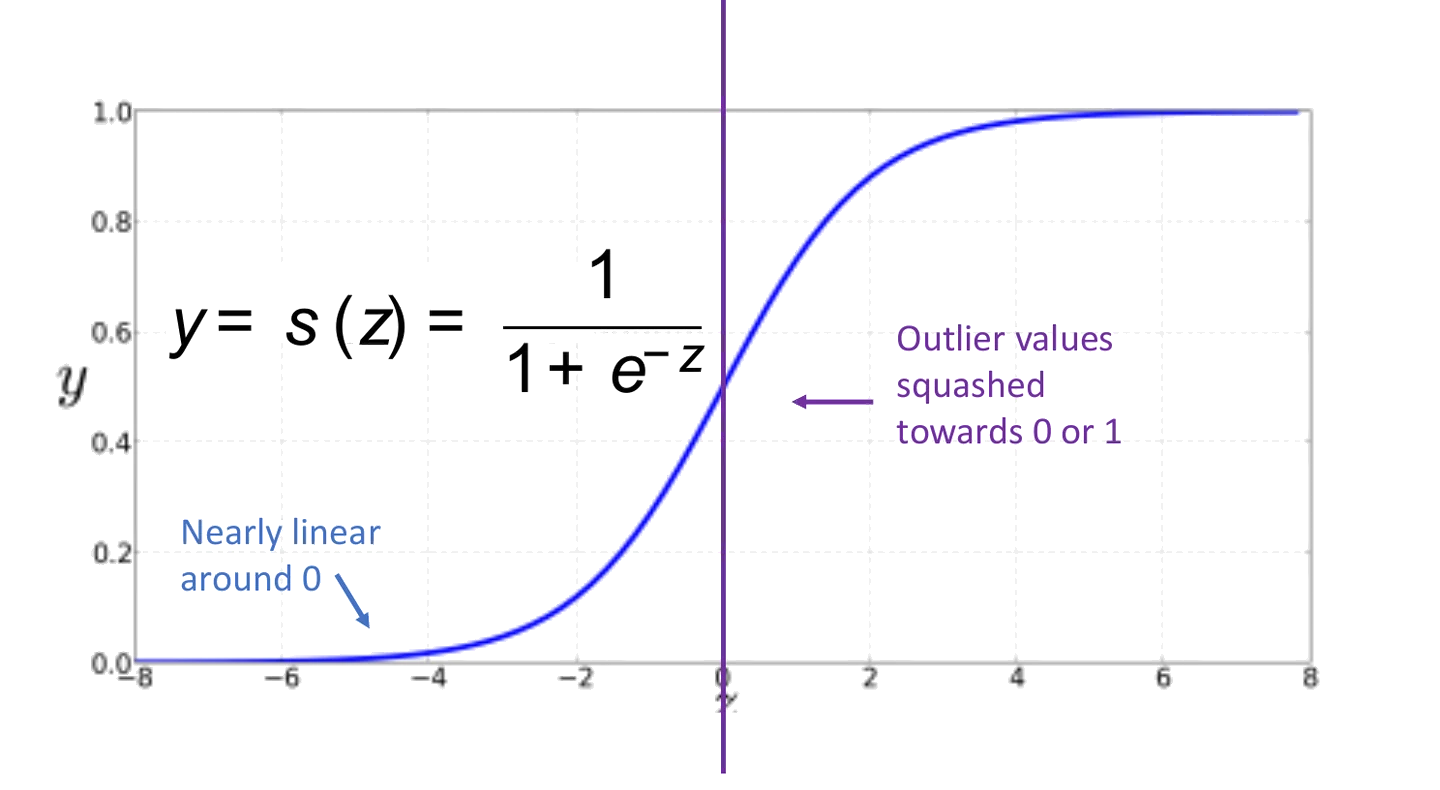
以为课件图上「Nearly linear around 0」的箭头指的地方就是线性段
那支箭头指向左下 z ≈ −4.6 附近的平坦段,位置画错了。近似线性的一段在 z = 0 附近,按文字的意思理解。
试一下
σ(3) ≈ 0.9526。不用计算器,σ(−3) 是多少?z = 3 处的斜率是多少?
σ(−3) = 1 − σ(3) ≈ 1 − 0.9526 = 0.0474。斜率 = σ(1 − σ) ≈ 0.9526 × 0.0474 ≈ 0.0452,比 z = 0 处的 0.25 小得多,已经开始变平。
3. 逻辑回归:一个神经元
它解决什么问题
有了特征和 sigmoid,就能拼出一个完整的分类器:输入一个样本的特征,输出它属于正类的概率。这一节把它算一遍,再画成网络图。这张图就是后面整个神经网络的积木。
从哪来(补充)
逻辑回归作为通用的统计模型,主要由 Joseph Berkson 发展和推广,从他 1944 年的论文开始;logit 这个词也是他在这篇论文里造的。
把它画成「神经元」的思路更早。Warren McCulloch 和 Walter Pitts 在 1943 年提出了人工神经元的数学模型;Frank Rosenblatt 1957 年在 IBM 704 上模拟了感知机。课件时间线上 1943 和 1958 两格说的就是这一段。
出处:Wikipedia: Logistic regression、Wikipedia: Perceptron
直觉
逻辑回归只有两步:加权求和,再过 sigmoid。
画成图,左边一排输入,每个输入连一条边到中间的求和节点,边上写着权重。求和的结果送进 sigmoid,出来的就是概率 y。
线性回归也能画成同一张图,只是最后一步不过 sigmoid,求和结果直接输出。两者的差别只在输出端那个函数。
一步一步看
目标:拿一组具体的输入和权重算加权求和、sigmoid 和交叉熵,看一个神经元怎样给出概率并判类。
拿一组具体的数算一遍。三个输入 x = (1, 2, 1),其中第一个 1 是恒为 1 的偏置输入 x₀;权重 θ = (0, 0.5, −0.5);这个样本的真实标签 y* = 1。
-
每条边算权重乘输入:0 × 1 = 0,0.5 × 2 = 1,−0.5 × 1 = −0.5。
-
求和节点把三项加起来:a = 0 + 1 − 0.5 = 0.5。
-
过 sigmoid:y = σ(0.5) = 0.6225。模型认为这个样本有 62% 左右的可能是正类。和真实标签 1 比,交叉熵损失 J = −log 0.6225 = 0.4741。
-
要判类别时,y 大于 0.5 判正类,小于 0.5 判负类。这里 0.6225 大于 0.5,判正类,判对了;损失 0.4741 说明它还不够有把握。
怎么算
a = θᵀx = θ₀x₀ + θ₁x₁ + … + θₙxₙ,其中 x₀ = 1
意思是:每个特征乘自己的权重,全部加起来;θ₀ 乘的是恒为 1 的 x₀,所以 θ₀ 就是偏置,相当于起始分。
y = σ(a) = 1 / (1 + e^(−a))
意思是:把分数 a 压成 0 到 1 之间的概率。
判类别时看 y 是否大于 0.5。σ(a) > 0.5 等价于 a > 0,所以分界线就是 θᵀx = 0 这个超平面。逻辑回归的分界线是直的,弯曲的边界要靠后面的隐藏层。
损失用交叉熵:J = −[y* log y + (1 − y*) log(1 − y)]
意思是:真实标签是 1 时只剩 −log y,模型给正类的概率越低,罚得越重;真实标签是 0 时只剩 −log(1 − y)。训练就是调 θ 让 J 变小,怎么调放在本讲最后一页讲。
常见误解
以为逻辑回归是回归模型
名字里有「回归」,做的是分类。它先回归出一个概率,再用 0.5 这条线判类别。
以为权重大的特征一定更重要
只有在各个特征的量纲差不多时才能这样比。年龄是几十,性别编码是 1 或 2,同样的权重乘上去贡献差很多。比权重大小之前,要先确认输入已经标准化。
试一下
θ = (−1, 2),输入只有一个特征 x₁ = 1(加上 x₀ = 1)。算出 a 和 y,判哪一类?
a = −1 × 1 + 2 × 1 = 1,y = σ(1) ≈ 0.7311,大于 0.5,判正类。
同一组权重,x₁ 取多少时模型正好拿不准(y = 0.5)?
y = 0.5 时 a = 0,即 −1 + 2x₁ = 0,x₁ = 0.5。x₁ 大于 0.5 判正类,小于 0.5 判负类,这个点就是分界线。
把它们串起来
分类有两大思路。生成式先学每一类长什么样,判别式只学怎么把类分开。逻辑回归和后面的神经网络都是判别式,学的是 p(y|x)。
判别式分类器有四个部件:特征、分类函数、目标函数、优化算法。逻辑回归的分类函数是两步:先算加权和 a = θᵀx,再用 sigmoid 把 a 压成概率。sigmoid 中间陡、两头平,在 a = 0 处输出 0.5、斜率最大为 0.25。
把这两步画出来,就是一个神经元:一排输入、一组权重、一个求和、一个 sigmoid。线性回归是同一张图,只是不过 sigmoid。
一个神经元只能画出一条直的分界线。下一页把几个神经元并排放成一层,再接一个输出神经元,就得到了最简单的神经网络。
课件里的坑
- [读图提醒] sigmoid 图上「Nearly linear around 0」的箭头指向左下 z ≈ −4.6 的平坦段,近似线性的区段实际在 z = 0 附近(p.19)
- [读图提醒] 判别式「狗戴项圈」的例子暗示了风险:训练集里若只有狗戴项圈,模型学到的是项圈,课件没有展开(p.11)
- [符号提醒] 线性回归那页也写 y = σ(θᵀx),那里的 σ(a) = a 是恒等函数,不是 sigmoid(p.17)
- [页码提醒] 插入页 p.5、p.12 没有页脚,之后的页脚比页序小 1 到 2,按页脚找页会差一两页。本页引用的页码都按 PDF 页序(p.13)
课后 10 分钟:考点复习
这 10 分钟怎么用:先默写 sigmoid 的公式和 σ(0)、最大斜率两个数;再在纸上画一个三输入神经元,自己代一组数算出 a、y;然后过一遍五道课件例题;最后回查判别式和生成式各自的代表模型。
必背
- 判别式模型只学 p(y|x),如逻辑回归、SVM;生成式对 (x, y) 建模再推出 p(y|x),如朴素贝叶斯
- 判别式分类器四个部件:特征表示、分类函数、目标函数、优化算法;神经网络只换掉分类函数这一个部件
- sigmoid σ(z) = 1/(1 + e^(−z)) 把任意实数压到 0 到 1 之间;σ(0) = 0.5,斜率 σ(1 − σ) 在 z = 0 处最大为 0.25
- 逻辑回归就是一个神经元:先算加权和 z = θᵀx,再过 sigmoid 得到 0 到 1 之间的概率
- 线性回归和逻辑回归画成网络是同一张图,只差输出端的激活函数:线性回归用恒等函数,逻辑回归用 sigmoid
- 权重的正负决定把结果推向哪一类,绝对值决定推得多狠;情感例子里 awesome +10、abysmal −10、mediocre −2
课件例题
例 1(课件 p.9–12):判断猫还是狗,生成式和判别式各怎么做?
题面:生成式给「猫」「狗」各建一个模型,看新图更像哪个;判别式只找能把两类分开的规则,比如「狗戴项圈」。
提示
分别想:它学的是哪个概率?代表模型是谁?各自擅长什么?
解答
生成式对 (x, y) 的联合分布建模,再推出 p(y|x),代表是朴素贝叶斯,适合处理缺失变量、容易加先验。判别式只学 p(y|x),代表是逻辑回归和 SVM,数据复杂时(文本、图像)通常表现更好。项圈例子也暗示了风险:若训练集里恰好只有狗戴项圈,模型学到的是项圈而不是狗。
例 2(课件 p.13):逻辑回归的四个部件各是什么?
题面:判别式分类器 = 特征表示 + 分类函数 + 目标函数 + 优化算法。
提示
按顺序想:输入怎么表示、输出怎么算、好坏怎么量、参数怎么调。
解答
特征表示 x = [x₁, …, xₙ];分类函数是 sigmoid(多分类用 softmax);目标函数是交叉熵;优化算法是随机梯度下降 SGD。
例 3(课件 p.16):情感分类的三个词权重分别是 +10、−10、−2,评论只含 awesome 时预测是多少?
题面:「含 awesome」θ = +10,「含 abysmal」θ = −10,「含 mediocre」θ = −2,权重只是举例。
提示
只含 awesome 时,只有这一项特征是 1,加权和就是它的权重。
解答
只含 awesome 时 z = 10,σ(10) ≈ 0.99995,几乎肯定是正面。只含 mediocre 时 z = −2,σ(−2) ≈ 0.1192。正号把结果推向正面,负号推向负面,绝对值越大推得越狠。
例 4(课件 p.17、p.20):线性回归和逻辑回归画成网络,差在哪?
题面:两页的网络图都是输入 x₁…x_M 带权重汇到一个输出 y,y = σ(θᵀx)。
提示
两张图的结构一样,看 σ 在两页里各指什么函数。
解答
图一模一样,只差输出端的激活函数。线性回归的 σ(a) = a,就是恒等函数;逻辑回归的 σ(a) = 1/(1 + exp(−a))。
例 5(课件 p.19):sigmoid 在哪一段近似线性,哪一段被压平?
题面:曲线横轴 z 从 −8 到 8,标注「Nearly linear around 0」和「Outlier values squashed towards 0 or 1」。
提示
用斜率 σ(1 − σ) 在 z = 0、2、4 三处的值说话。
解答
斜率 σ(1 − σ) 在 z = 0 处最大为 0.25,z = 2 时 0.105,z = 4 时只剩 0.0177。所以中段近似线性,两端被压平到 0 或 1。图上箭头指的位置有误,按含义理解。
完整例题
题面(改编自课件 p.16):情感分类器用三个特征:评论含 awesome(权重 +10)、含 abysmal(−10)、含 mediocre(−2),含就记 1,不含记 0,不设偏置。分别求下面三条评论属于正面的概率,并判类别:(a) 只含 awesome;(b) awesome 和 mediocre 都含;(c) abysmal 和 mediocre 都含。
解法:
- 写出加权和:z = 10 × x_awesome − 10 × x_abysmal − 2 × x_mediocre。
- (a) z = 10 × 1 = 10,y = σ(10) ≈ 0.99995,判正面。
- (b) z = 10 − 2 = 8,y = σ(8) ≈ 0.9997。mediocre 把分数往下拉了 2,概率只降了一点点:z = 8 已经在 sigmoid 的平坦段。
- (c) z = −10 − 2 = −12,y = σ(−12) ≈ 0.000006,判负面。
- 对照 sigmoid 的斜率:z 越大,同样减 2 分,概率变化越小。这就是「两端被压平」在实际例子里的样子。
要点:先写加权和,再写 sigmoid,最后按 0.5 判类别。三步都写出来才算完整。
答题格式:「z = … = 数值;y = σ(数值) ≈ 概率;概率大于 0.5,判正面」。
变式题(先自己做)
(1) 自编情境:逻辑回归,x = (1, 1, 2)(第一项是偏置输入),θ = (0.2, −0.3, 0.1),求 a 和 y,判哪一类。 (2) 改编自课件 p.16:给情感分类器加一个偏置 θ₀ = −1(x₀ = 1)。只含 mediocre 的评论,概率变成多少? (3) 自编情境:某逻辑回归只有一个特征,θ₀ = 3,θ₁ = −1。x₁ 在什么范围时判正类?
提示
(1) a 就是 θ 和 x 的点积。(2) 偏置也要乘上 x₀ = 1 加进去。(3) 判正类等价于 a > 0。
判分点与答案(非官方评分标准)
判分点:① 先写加权和再写 sigmoid;② 判类别时写出和 0.5(或 a 和 0)的比较。
(1) a = 0.2 × 1 − 0.3 × 1 + 0.1 × 2 = 0.1,y = σ(0.1) = 0.525,略大于 0.5,判正类,但几乎拿不准。
(2) z = −1 − 2 = −3,y = σ(−3) ≈ 0.0474,比没有偏置时的 0.1192 更低。
(3) a = 3 − x₁ > 0,即 x₁ < 3 时判正类;x₁ = 3 时 y = 0.5,正好在分界线上。
闪卡自测
1. 判别式和生成式各学什么概率?各举一个代表模型。
判别式学 p(y|x),如逻辑回归、SVM;生成式学 p(x, y) 再推出 p(y|x),如朴素贝叶斯(p.12)。
2. 判别式分类器的四个部件是什么?
特征表示、分类函数、目标函数、优化算法。逻辑回归分别是 x、sigmoid、交叉熵、SGD(p.13)。
3. sigmoid 的公式?σ(0) 是多少?
σ(z) = 1/(1 + e^(−z)),σ(0) = 0.5(p.18–19)。
4. sigmoid 的导数怎么用它自己表示?最大值在哪?
σ′ = σ(1 − σ),在 z = 0 处最大,为 0.25(p.19)。
5. 逻辑回归的两步是什么?
先算加权和 a = θᵀx,再过 sigmoid 得到概率 y = σ(a)(p.18、p.20)。
6. 线性回归和逻辑回归画成网络后差在哪?
只差输出端的激活函数:线性回归用恒等函数,逻辑回归用 sigmoid(p.17、p.20)。
7. 情感例子里 mediocre 的权重是 −2,这个负号是什么意思?
含这个词会把预测往负面推;绝对值 2 比 awesome 的 10 小,推得不狠(p.16)。
8. 逻辑回归的分界线长什么样?
θᵀx = 0 这个超平面,是直的。y > 0.5 等价于 θᵀx > 0。
下一讲
一个神经元只能画直线。把几个神经元并排放成隐藏层,再接一个输出神经元,就是最简单的神经网络,见 L06b。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。