L04b 线性回归:三个点、一条线,把机器学习的整套流程走一遍
用一条直线预测房价:定义平方误差代价函数,用梯度下降找碗底,再用正则化把过拟合压回去。
一句话版
给一堆(面积,价格)的点找一条最贴的直线:用平方误差给每条候选直线打分,用梯度下降一步步走到分数最低的那条,再用正则化防止模型为了迎合训练数据把自己扭成麻花。
一个类比:调收音机旋钮,直到杂音最小
老式收音机有一个频率旋钮,你听不到电台在哪,只能听杂音大小。做法是先随便拧到一个位置,听一下,往杂音变小的方向拧一点,再听,再拧,直到杂音最小。
这整讲就是这个动作的数学版。旋钮是参数 θ₀ 和 θ₁,一个管直线的高低,一个管倾斜(p.8)。杂音大小是代价函数 J:把每个训练点的真实价格和直线给出的预测价格相减、平方、加起来再平均,数越大说明直线离数据越远(p.9)。**「往杂音变小的方向拧」**是梯度下降:算一下 J 在当前位置的坡度,往下坡方向挪一步,步子多大由学习率 α 决定(p.22)。
有两个细节收音机也能对上。旋钮有两个的时候,你得看着同一个杂音读数同时决定两个旋钮各拧多少,拧完一个再听一遍才决定另一个,读数已经变了(p.25)。而步子大小也讲究:每次只拧一点点,要拧很久;每次拧半圈,会在电台两边来回跳,永远停不下来(p.27)。
类比在哪里失效:收音机的杂音曲线可能有好几个低谷,拧到某个次优台就停了;线性回归的 J 是一只标准的碗,只有一个底,从哪儿开始都会走到同一个位置(p.13、p.15)。课件 p.20 那张多峰曲面画的是一般情况,故意让你看到「不同起点走到不同谷底」,它并非线性回归的 J。第二处失效是正则化:收音机没有「为了防止调得太准而故意留点杂音」这回事,机器学习有——训练集上分数太完美反而是坏信号(p.30)。
概念卡
1. 假设函数与记号(Hypothesis, Notation)
人话定义:h_θ(x) = θ₀ + θ₁x 就是那条直线,h 叫 hypothesis(假设函数),θ₀ 是截距、θ₁ 是斜率,两个 θ 就是要学的全部参数(p.4)。记号四件套:m 是训练样本数,x 是特征,y 是目标,(x⁽ⁱ⁾, y⁽ⁱ⁾) 是第 i 个样本,上标是编号(p.3)。
例子:课件的房价表第一行 x = 2104、y = 460。如果参数是 θ₀ = 50、θ₁ = 0.06(p.15 那条线),预测价是 50 + 0.06 × 2104 ≈ 176,离 460 差得远,说明这组参数不好。
常见误解
把 x⁽ⁱ⁾ 的上标当幂次 → 它是样本序号,第 i 个房子的面积。真正的幂次出现在 p.30 的 x²、x³,那是同一个特征取平方立方造出的新特征,两种上标写法不同、含义不同(p.3、p.30)。
2. 代价函数(Cost Function)
人话定义:J(θ₀, θ₁) = (1/2m) Σ_{i=1}^{m} (h_θ(x⁽ⁱ⁾) − y⁽ⁱ⁾)²。每个样本算「预测减真实」,平方掉正负号,全部加起来除以 2m。课件叫它平方误差函数。目标是找让 J 最小的 θ₀、θ₁(p.9)。
例子:课件 p.11–13 的迷你例子把 θ₀ 固定为 0,只剩 θ₁ 一个旋钮。三个点 (1,1)、(2,2)、(3,3)。θ₁ = 1 时直线正好穿过三点,J(1) = (0 + 0 + 0)/6 = 0。θ₁ = 0.5 时预测值是 0.5、1、1.5,J(0.5) = [(0.5 − 1)² + (1 − 2)² + (1.5 − 3)²]/6 = 3.5/6 ≈ 0.58。把所有 θ₁ 的 J 连起来就是一只碗。
常见误解
把两张图的横轴当成同一个东西 → 左图横轴是 x,固定一组 θ 画出一条线;右图横轴是 θ₁,每个 θ₁ 只对应一个 J 值。左图一条线压缩成右图一个点。系数 1/2m 里的 1/2 也常被问:它是为了求导时和平方的 2 约掉,不影响最低点在哪(p.9、p.11)。
3. 梯度下降(Gradient Descent)
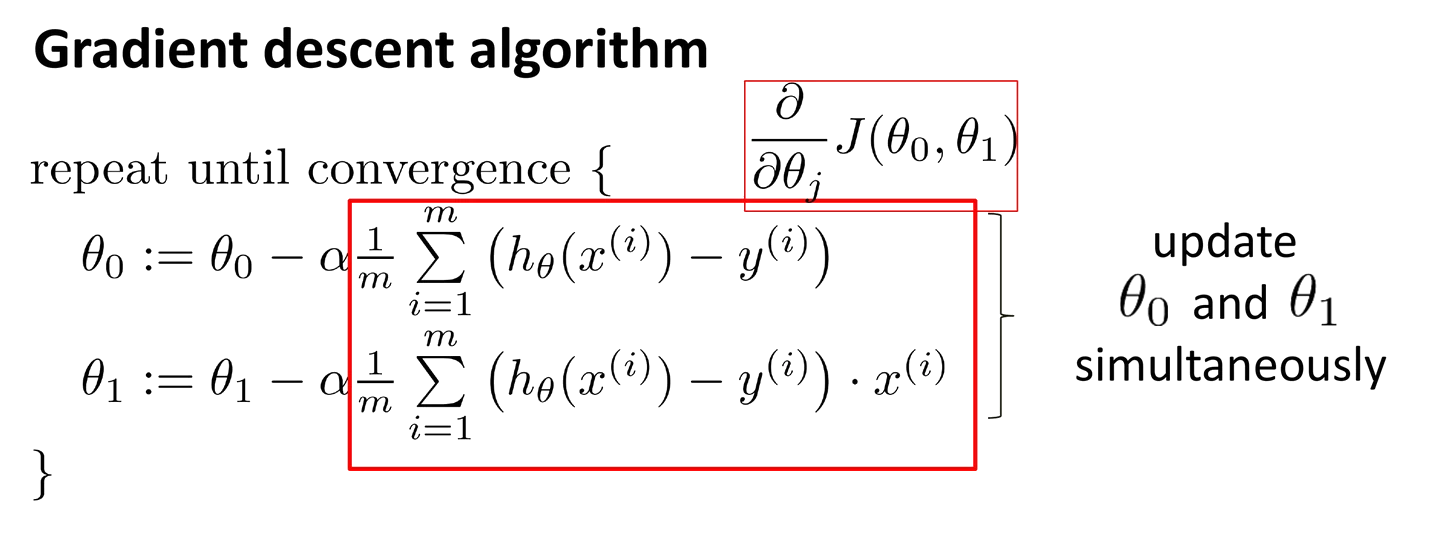
人话定义:随机选一组 θ,反复执行 θⱼ := θⱼ − α·∂J/∂θⱼ,直到 J 不再下降(p.18、p.22)。∂J/∂θⱼ 是 J 在当前点对 θⱼ 的坡度,减号表示往下坡走,α 是步长。代入线性回归求完导,两个参数各有一条更新式(p.23):
例子:还是三点例子,θ₀ 固定 0、θ₁ = 0.5。坡度 ∂J/∂θ₁ = (1/3)[(0.5 − 1)·1 + (1 − 2)·2 + (1.5 − 3)·3] = (1/3)(−7) ≈ −2.33。坡度为负,说明 θ₁ 该增大。取 α = 0.1,新 θ₁ = 0.5 − 0.1 × (−2.33) ≈ 0.73,往最优值 1 靠近了一步。
常见误解
两条更新式的求和里再套一个平方 → 求导后平方已经变成一次项,括号里是误差本身;系数从 1/2m 变成 1/m 也是同一个原因。θ₁ 那条和 θ₀ 那条唯一的差别是末尾多乘 x⁽ⁱ⁾(p.23)。
4. 同时更新与学习率(Simultaneous Update, Learning Rate α)
人话定义:两个偏导都要用同一组旧 θ 算,先存到 temp0、temp1,再一起赋值。课件 p.25 给出的错误版本是算完 temp0 立刻写回 θ₀,再用新 θ₀ 去算 θ₁ 的偏导,这样第二个偏导是在一个半新半旧的点上算的,课件的评语是会引入 bias and instability(p.26)。学习率 α 太小走得慢,太大会跨过碗底来回跳甚至越跳越远(p.27)。
例子:三点例子里每走一步,(θ₁ − 1) 会乘上因子 (1 − 14α/3)。α = 0.1 因子是 0.53,误差每步减半;α = 0.5 因子是 −1.33,绝对值大于 1,十步之后 θ₁ 跑到 −7.9。分界点 α ≈ 0.43。这些数只对这个例子成立,机制是通用的。
常见误解
以为线性回归的梯度下降会因初始值不同停在不同答案 → 课件 p.20–21 的多峰曲面演示的是一般函数;线性回归的 J 是凸的碗(p.13、p.15),任何起点都走到同一个碗底。考试问「会不会陷入局部最优」,答不会,理由是凸。
5. 欠拟合与过拟合(Underfitting, Overfitting)
人话定义:直线太简单、跟不上数据的弯曲,叫欠拟合、high bias;模型太复杂、把训练集里每个点都精确穿过,叫过拟合、high variance。过拟合的定义是训练集上 J ≈ 0 但对新样本预测很差(p.30)。
例子:课件 p.30 用同一组五个房价点画了三条曲线:一次式的直线(欠拟合)、二次式的平滑曲线(刚好)、加到四次项的扭曲曲线(过拟合)。p.31 把同样的问题换成分类,三条决策边界从直线到平滑曲线到绕着每个点转圈,判断标准一样。
常见误解
把「训练集上误差为零」当成好消息 → 它恰恰是过拟合的信号。课件的两条处理办法:减少特征(手动挑或用模型选择算法),或者正则化——保留全部特征、把参数值压小(p.32)。
6. 正则化与 λ(Regularization, L1 / L2)
人话定义:在 J 里加一项惩罚参数大小的东西。L2(Ridge)加 λ Σ_{j=1}^{n} θⱼ²,L1(Lasso)加 λ Σ_{j=1}^{n} |θⱼ|。求和从 j = 1 开始,截距 θ₀ 不罚。λ 是超参数,由人设定(p.35)。
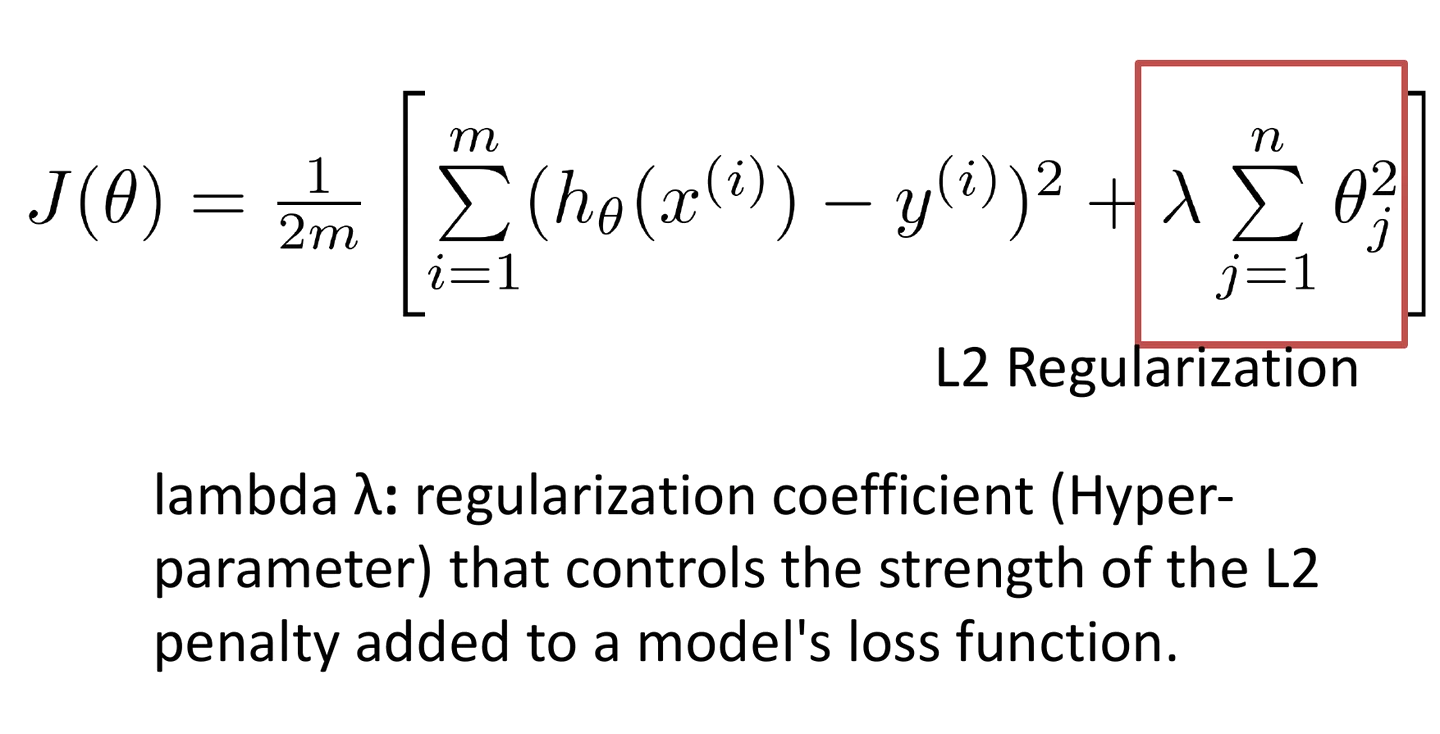
例子:课件 p.33 的直觉——四次多项式里把 θ₃、θ₄ 压到接近 0,它就退化成二次曲线,不删特征也能得到「刚好」的效果。p.36 四张图同一组数据只换 λ:λ = 0 剧烈摆动(过拟合),λ = 0.0001 几乎贴合目标曲线,λ = 1 变成近似直线(欠拟合)。
常见误解
把惩罚项写成从 j = 0 开始 → 课件明确是 j = 1 到 n,θ₀ 只是把线整体抬高压低,不参与「复杂度」,罚它没有意义。另一个常见错误是把惩罚项写在方括号外面,课件里它在括号内、同样被 1/2m 除(p.35)。
把它们串起来
整讲是一条流水线,每一站回答一个问题。模型长什么样:h_θ(x) = θ₀ + θ₁x,一条直线两个旋钮(p.4)。怎么给旋钮打分:J 把所有样本的预测误差平方后平均,J 是 θ 的函数,画出来是碗(p.9、p.13)。怎么找碗底:梯度下降,每步沿坡度反方向挪 α 那么大的一步,两个旋钮同时挪(p.23、p.25)。碗底就一定好吗:训练集上 J 压到 0 可能是过拟合,对新房子失效(p.30)。怎么办:在 J 里加 λ Σ θⱼ² 让参数不敢太大,λ 从 0 往上调,直到既不过拟合也不欠拟合(p.35、p.36)。
后面所有模型都是这条线换零件:逻辑回归换 h、神经网络换 h 和 J 的形状,梯度下降和正则化几乎原样保留。课件末页留的三个问题——L1 和 L2 哪个好、α 和 λ 怎么选、模型怎么评估——是下一份课件的入口(p.39)。
课件里的坑
- [课件有误] p.24 右栏那张外来的推导截图,Now, 下面第三行写成 (1/m)(h_Θ(xᵢ) − y)xᵢ,前两行都有的求和号 Σ 丢了,y 也丢了下标;到 Therefore, 的框里求和号又回来。以 p.23 的两条式子为准(p.24)
- [课件留白] p.24 右栏最终式末尾统一乘 xᵢ,只对 θ₁ 成立;要覆盖 θ₀ 需要约定 x₀ = 1,课件没写这个约定(p.24)
- [课件留白] p.13 左图 θ₁ = 0 的标签印在一条斜线旁边,θ₁ = 0 对应的应是贴着横轴的水平线,按公式理解(p.13)
- [课件留白] p.19 的手绘图把偏导写成 δJ/δθ,p.22 起统一用 ∂,是同一个东西(p.19)
- [课件留白] p.20–21 的多峰曲面并非线性回归的 J,是为了演示「随机初始化可能走到不同谷底」画的一般情况;线性回归的 J 只有一个底(p.15、p.20)
- [课件留白] p.31 的三张分类图课件只提问没给答案;对照 p.30,从左到右是欠拟合、刚好、过拟合(p.31)
- [课件留白] p.36 的 λ = 0.0001、0.01、1 是那个演示数据的专属数字,换问题最优 λ 完全不同(p.36)
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先默写三个公式——代价函数 J、两条梯度下降更新式、L2 正则化的 J;再把下面的「完整例题」不看答案算一遍,重点是同时更新那一步;最后回查两个最容易错的地方——惩罚项从 j = 1 开始、更新式里没有平方。三步做完再往下看答案。
必背
- 代价函数 J(θ₀, θ₁) = (1/2m) Σ_{i=1}^{m} (h_θ(x⁽ⁱ⁾) − y⁽ⁱ⁾)²,求和遍历全部样本,预测减真实再平方,系数是 1/2m 而非 1/m
- 三点例题 (1,1)(2,2)(3,3) 且 θ₀ = 0:J(1) = 0,J(0.5) = 3.5/6 ≈ 0.58;h 是 x 的函数、J 是 θ 的函数,左图一条线对应右图一个点
- 梯度下降更新式 θⱼ := θⱼ − α·∂J/∂θⱼ;代入线性回归后 θ₀ 的式子是 (1/m)Σ 误差,θ₁ 的式子末尾多乘 x⁽ⁱ⁾,系数都变成 1/m
- 两个参数必须同时更新:temp0、temp1 都用旧 θ 算完再一起赋值;先更新 θ₀ 再算 θ₁ 的梯度是错的
- α 太小收敛慢,α 太大跨过碗底来回震荡甚至发散;线性回归的 J 是凸的碗形,不会陷入局部最优
- 欠拟合对应 high bias,过拟合对应 high variance;过拟合的标志是训练集 J ≈ 0 但新样本预测差,处理办法是减特征或正则化
- L2 正则化代价函数 J(θ) = (1/2m)[Σ(h_θ(x⁽ⁱ⁾) − y⁽ⁱ⁾)² + λ Σ_{j=1}^{n} θⱼ²],惩罚项从 j = 1 起、θ₀ 不罚;L1 = Lasso 用 |θⱼ|,L2 = Ridge 用 θⱼ²,λ 是超参数
完整例题
手算一步两参数的梯度下降是我押的题型(我的判断,课件没标重点),它把代价函数、偏导和同时更新三件事串在一起。
题面:训练集三个点 (1,1)、(2,2)、(3,3),模型 h_θ(x) = θ₀ + θ₁x,初始 θ₀ = 0、θ₁ = 0.5,学习率 α = 0.1。求一步梯度下降后的 θ₀、θ₁,以及更新前后的 J。
- 算更新前的 J。预测值 0.5、1、1.5,误差 −0.5、−1、−1.5,平方和 0.25 + 1 + 2.25 = 3.5,J = 3.5/(2 × 3) ≈ 0.583(p.12)。
- 算两个偏导,都用旧 θ。∂J/∂θ₀ = (1/3)(−0.5 − 1 − 1.5) = −1;∂J/∂θ₁ = (1/3)[(−0.5)(1) + (−1)(2) + (−1.5)(3)] = (1/3)(−7) ≈ −2.33(p.23)。
- 先存 temp 再赋值。temp0 = 0 − 0.1 × (−1) = 0.1;temp1 = 0.5 − 0.1 × (−2.33) ≈ 0.733。然后 θ₀ := 0.1,θ₁ := 0.733(p.25)。
- 算更新后的 J。预测值 0.1 + 0.733 × {1, 2, 3} = 0.833、1.567、2.3,误差 −0.167、−0.433、−0.7,平方和 ≈ 0.706,J ≈ 0.706/6 ≈ 0.118。一步之内 J 从 0.583 降到 0.118。
- 对比错误的顺序更新。如果先把 θ₀ 写成 0.1 再算 ∂J/∂θ₁,得到 (1/3)[(0.1 − 0.5)(1) + (0.1 − 1)(2) + (0.1 − 1.5)(3)] = (1/3)(−6.4) ≈ −2.13,θ₁ 会变成 0.713 而非 0.733。两个数都在往 1 靠,但顺序更新用的已经是另一个点的坡度,多步之后误差会累积(p.26)。
- 读懂结果。两个偏导都是负的,说明直线又低又平,θ₀、θ₁ 都该增大;步子大小由坡度乘 α 决定,坡度大的 θ₁ 挪得更多。再走一步会到 (0.143, 0.838),J ≈ 0.025,继续逼近碗底 (0, 1)。
这道题的骨架值得单独记:先算误差 → 两个偏导(θ₁ 那条多乘 x)→ 两个 temp 一起赋值 → 重算 J 确认下降。
变式题(先自己做)
同样三个点,θ₀ 固定为 0,只学 θ₁。现在给代价函数加 L2 正则化,λ = 1:J(θ₁) = (1/6)[Σ(θ₁x⁽ⁱ⁾ − y⁽ⁱ⁾)² + λθ₁²]。问:θ₁ = 1 还是最优解吗?新的最优 θ₁ 是多少?
提示
先把 J 写成 θ₁ 的显式函数——三个点满足 y = x,所以平方误差部分是 (θ₁ − 1)² 乘以 Σx² = 14。加上惩罚项后对 θ₁ 求导令其为零。算完看看最优 θ₁ 往哪个方向偏,再想想 λ 变成 14 会怎样。
参考答案与自检(非官方评分标准)
自检要点:① θ₁ = 1 不再是最优;② 答案 14/15 ≈ 0.933,一定小于 1;③ 忘了 λ 也被 1/2m 除的话,导数会差一个常数倍,但这道题里不影响最优解的位置。
- 写显式函数:J(θ₁) = (1/6)[14(θ₁ − 1)² + θ₁²]。
- 求导令零:28(θ₁ − 1) + 2θ₁ = 0,30θ₁ = 28,θ₁ = 28/30 = 14/15 ≈ 0.933。
- 检查 θ₁ = 1 的值:J(1) = (1/6)[0 + 1] ≈ 0.167,不再是 0,因为惩罚项在罚它。
- 为什么变小:正则化把「拟合数据」和「参数别太大」两个目标加在一起,最优点被从 1 往 0 拉了一点。λ 越大拉得越狠——通式是 θ₁ = 14/(14 + λ),λ = 14 时直接压到 0.5。这就是 p.36 四张图从「刚好」滑向「欠拟合」的代数版本。
闪卡自测
1. 单变量线性回归的假设函数是什么?两个参数各管什么?
h_θ(x) = θ₀ + θ₁x。θ₀ 是截距,控制直线上下平移;θ₁ 是斜率,控制倾斜(p.4、p.8)。
2. 写出代价函数,说出三个最容易写错的细节。
J(θ₀, θ₁) = (1/2m) Σ_{i=1}^{m} (h_θ(x⁽ⁱ⁾) − y⁽ⁱ⁾)²。细节:求和从 1 到 m、预测减真实再平方、系数是 1/2m。1/2 是为了求导时约掉平方的 2(p.9)。
3. 三个点 (1,1)(2,2)(3,3),θ₀ = 0,J(0.5) 怎么算?
预测 0.5、1、1.5,误差平方 0.25 + 1 + 2.25 = 3.5,除以 2 × 3 得 0.583,课件写 0.58(p.12)。
4. h_θ(x) 的图和 J(θ₁) 的图横轴分别是什么?
前者横轴是 x,固定 θ 画出一条线;后者横轴是参数 θ₁,每个 θ₁ 对应一个 J 值。左图一条线压成右图一个点(p.11)。
5. 写出线性回归的两条梯度下降更新式,它们差在哪?
θ₀ := θ₀ − α(1/m)Σ(h_θ(x⁽ⁱ⁾) − y⁽ⁱ⁾);θ₁ := θ₁ − α(1/m)Σ(h_θ(x⁽ⁱ⁾) − y⁽ⁱ⁾)·x⁽ⁱ⁾。唯一差别是 θ₁ 那条末尾多乘 x⁽ⁱ⁾;系数都是 1/m,括号里没有平方(p.23)。
6. 顺序更新错在哪一行?
temp0 → θ₀ := temp0 → temp1 → θ₁ := temp1 这个顺序里,算 temp1 时用的 θ₀ 已经是新值,偏导是在半新半旧的点上算的。正确做法是两个 temp 都用旧 θ 算完再一起赋值(p.25–26)。
7. 学习率太小、太大各会怎样?
太小:每步挪一点,收敛慢但能到。太大:跨过碗底跳到对面,可能来回震荡、不收敛甚至发散(p.27)。
8. 线性回归的梯度下降会不会陷入局部最优?
不会。J 是凸函数,一维是抛物线、二维是碗形曲面,只有一个最低点,任何初始值都走到同一处。课件 p.20–21 的多峰曲面是一般情况的演示,与线性回归无关(p.13、p.15)。
9. 过拟合的定义是什么?对应 bias 还是 variance?
特征太多时模型把训练集拟合得极好(J ≈ 0)但对新样本失效。过拟合对应 high variance,欠拟合对应 high bias(p.30)。
10. 处理过拟合的两条路是什么?
一是减少特征,手动挑选或用模型选择算法;二是正则化,保留全部特征但把参数值压小,适合特征多且每个都有一点用的情况(p.32)。
11. 写出 L2 正则化的代价函数,惩罚项的求和从几开始?
J(θ) = (1/2m)[Σ_{i=1}^{m}(h_θ(x⁽ⁱ⁾) − y⁽ⁱ⁾)² + λ Σ_{j=1}^{n} θⱼ²]。从 j = 1 开始,θ₀ 不罚;惩罚项在方括号内,同样被 1/2m 除(p.35)。
12. L1 和 L2 各叫什么、惩罚项各是什么?λ 从 0 调大会发生什么?
L1 叫 Lasso,惩罚 λΣ|θⱼ|;L2 叫 Ridge,惩罚 λΣθⱼ²。λ = 0 等于没正则化(过拟合),λ 太大参数全被压没(欠拟合),中间某个值泛化最好(p.35–36)。
下一讲
课件末页留的三个问题——怎么划分训练集和测试集、怎么选 α 和 λ、怎么诊断偏差与方差——在本周第三份课件里回答,本讲的三联图会在那里再出现一次。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。