L01d 监督学习:答案是数还是类别,以及一副通用骨架
从零讲清回归和分类怎么分、降雨概率为什么算分类,再用三个点亲手算一遍均方误差,走通「模型 → 损失 → 优化」这副所有监督学习共用的骨架。
一句话版
监督学习手上的每条数据都带着标准答案。答案是一个数(房价、气温),叫回归;答案是一个类别(垃圾 / 正常、马 / 车),叫分类。
不管回归还是分类,做法都是同一副骨架:先定模型长什么样,再定怎么量它错了多少,最后一点点调参数,把错误量调到最小。
先认识这几个词
| 词 | 全称 / 读法 | 一句人话 |
|---|---|---|
| 回归 | Regression | 预测一个连续的数 |
| 分类 | Classification | 预测属于哪一个类别 |
| 模型 | model | 一个带待定参数的公式,比如 y = wx + b |
| 损失函数 | loss function | 量模型错了多少的公式 |
| MSE | Mean Squared Error,均方误差 | 每个误差平方后取平均 |
| 交叉熵 | Cross-Entropy | 分类常用的损失 |
| 梯度下降 | Gradient Descent | 每次朝让损失变小的方向挪一小步 |
一个类比:学估价的学徒
一个二手车行收了个学徒。师傅给他看几百辆车的资料:车龄、里程、品牌,以及每辆最后卖了多少钱。
学徒要学的是「看到一辆车的资料,说出它值多少钱」。这是回归,答案是一个数。如果师傅让他学的是「这辆车能不能收」,答案只有能和不能,那就是分类。
学徒怎么学?先给自己定个估价公式,比如「新车价减去每年折旧」。拿公式去估那几百辆车,和真实成交价比,算出平均差了多少。差太多就调公式里的数,比如折旧率改大一点,再估再比。差距越来越小,就是越学越好。
定公式、量差距、调数字,这三步就是监督学习的骨架。
类比在哪里失效:
- 学徒会用常识调公式,知道「事故车要打折」。机器只会按损失函数的指示调参数,不知道为什么。
- 学徒调参数靠感觉,机器有确定的规则:算出往哪个方向调能让损失下降最快,就往那个方向挪一小步。
从零讲起
1. 回归和分类:看答案是数还是类别
它解决什么问题
上一页把任务分成了监督、无监督、强化三类。监督学习这一类里,要预测的东西还分两种:一个连续的数,或者一个类别。两种任务用的损失、评价方法都不同,考试最爱拿模糊的场景让你判断。
直觉
看最终要交付的答案。
答案可以是任意一个数,两个数之间还有无穷多个取值,比如房价、气温,这是回归。答案只能从一张事先定好的表里挑一个,比如「下雨 / 不下雨」「house / townhouse」,这是分类。
两者都属于监督学习,输入可以完全一样,区别只在 y。
一步一步看
目标:同一批房子换掉要预测的 y,看任务怎样从拟合直线的回归变成画分界线的分类。
拿同一批房子的数据,看 y 换了以后任务怎么变:
-
输入都是房子的面积,每条数据都有标准答案,所以都是监督学习。
-
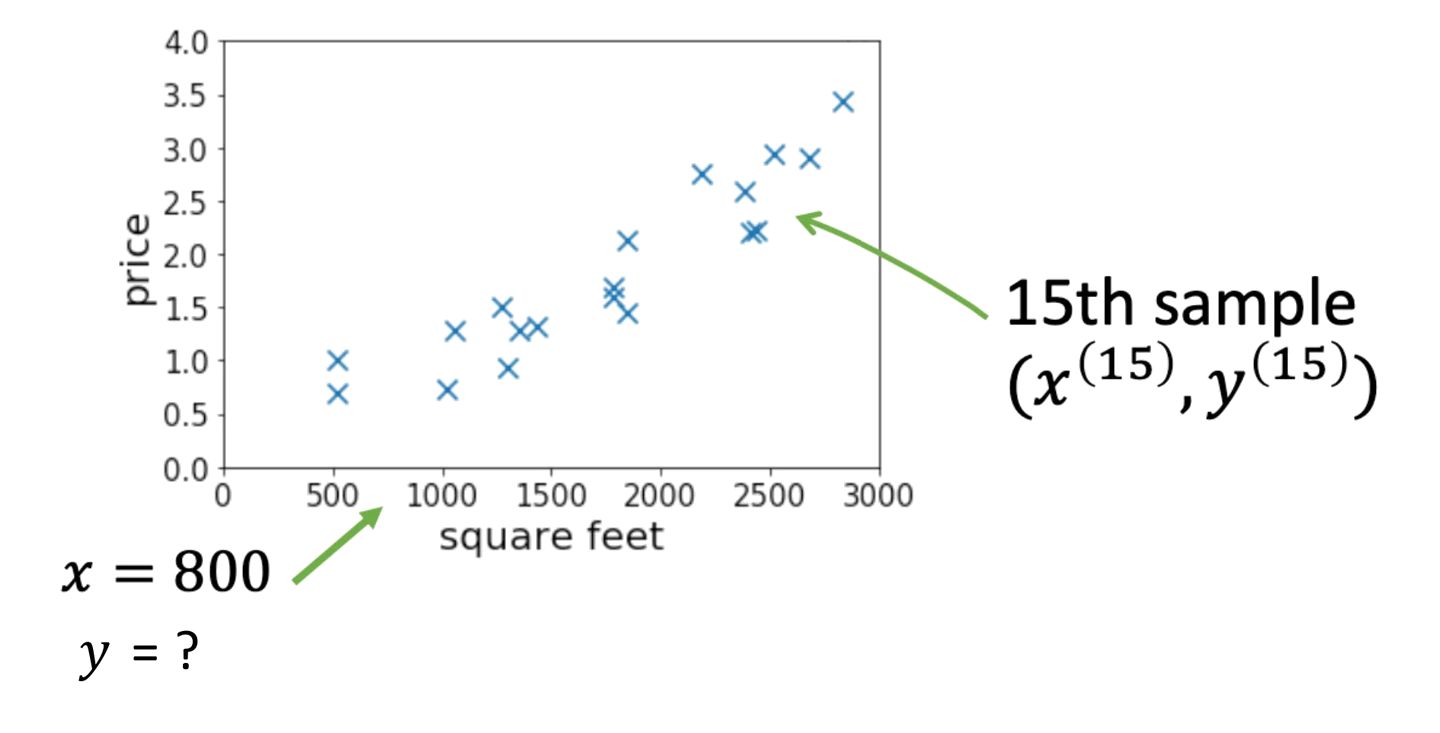
左边:答案是价格,一个连续的数。在散点上拟合一条线,往线上读数,这是回归。
-
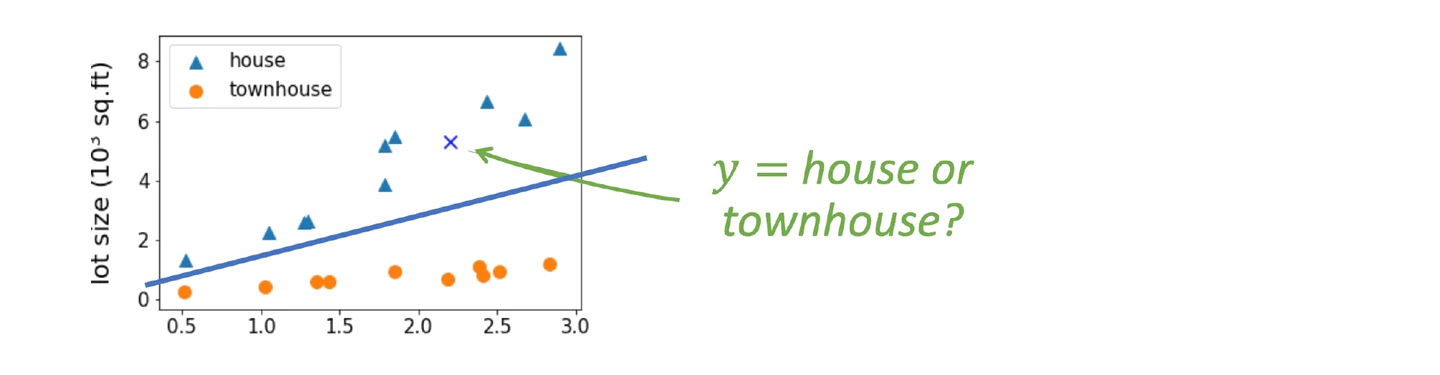
右边:答案是房型,house 或 townhouse 两类之一。在点之间画一条分界线,看新点落在哪一侧,这是分类。
-
两边的损失和评价指标也跟着分开:
| 回归 | 分类 | |
|---|---|---|
| 输出类型 | 连续值 | 离散类别 |
| 例子 | 预测房价、气温、股价 | 判断是否垃圾邮件、识别手写数字 |
| 常用损失 | 均方误差 MSE | 交叉熵 |
| 评价指标 | MSE / MAE / R² | 准确率 / 精确率 / 召回率 / F1 |
怎么判断
问一句:训练用的标签是数值还是类别?任务最终要交付的是一个数还是一个类别?
别被输出的样子骗。「预测明天下雨的概率」输出的是一个 0 到 1 之间的数,看着像回归。但训练时的标签是「下雨 / 不下雨」两个类别,概率只是在说「属于下雨这一类的可能性」,所以这是分类,确切地说是概率分类。概率可以就是最终输出,不必再换成硬标签。
常见误解
以为输出是小数就是回归
分类模型也常输出小数,那是「属于某一类的概率」。判断看标签:标签是类别,就是分类。
以为回归和分类是两种不同的学习范式
两者都属于监督学习,都有标准答案,只是答案的形态不同。三分类那一层看有没有标签,回归和分类是监督学习内部的再分。
试一下
三个任务各是回归还是分类:(1) 预测明天的最高气温;(2) 判断一张 X 光片有没有骨折;(3) 预测一部电影上映第一周的票房。
(1) 回归,气温是连续的数。(2) 分类,答案是「有 / 没有」两类。(3) 回归,票房是一个数。
2. 模型和损失:先定公式,再量它错了多少
它解决什么问题
知道是回归以后,机器到底怎么「学」?第一步要有一个带待定参数的公式,叫模型;第二步要有一把尺子,量这个公式在训练数据上错了多少,叫损失函数。没有这把尺子,就分不出两个公式哪个更好。
直觉
最简单的模型是一条直线:y = wx + b。w 管斜率,b 管截距,这两个数就是待学的参数。换一组 w 和 b,就是换一条线。
怎么量一条线好不好?对每条样本,看线上预测的 y 和真实的 y 差多少,这就是误差。误差有正有负,直接加会互相抵消,所以先平方再取平均,这就是均方误差 MSE。MSE 越小,线越贴近数据。
一步一步看
目标:在三条样本上先猜 w = 1 再换 w = 2,看 MSE 怎样量出哪条直线错得更少。
手上有三条样本:(1, 2)、(2, 4)、(3, 5)。为了好算,先固定 b = 0,只调 w。
-
先定模型 y = wx + b,参数还没定,表里的预测和误差都是问号。
-
随手猜 w = 1,画出 y = x。三个点的预测是 1、2、3,误差是 1、2、2,MSE 是 3。
-
把 w 调到 2,画出 y = 2x。预测是 2、4、6,误差是 0、0、−1,MSE 降到约 0.33。
怎么算
MSE = (1/n) × Σ (yᵢ − ŷᵢ)²
意思是:对每条样本,用真实值 yᵢ 减去模型的预测 ŷᵢ 得到误差,把误差平方,全部加起来,再除以样本数 n。
w = 1 时:MSE = (1² + 2² + 2²) ÷ 3 = 9 ÷ 3 = 3
w = 2 时:MSE = (0² + 0² + 1²) ÷ 3 = 1 ÷ 3 ≈ 0.33
意思是:第二条线的平均平方误差只有第一条的九分之一,在这把尺子下,y = 2x 比 y = x 好得多。
常见误解
以为误差直接加起来就行
误差有正有负,直接加会抵消。一条线一半点在上、一半点在下,误差和可能是 0,但线并不好。平方后都是正数,大误差还会被放大。
以为损失函数就是模型
模型是用来预测的公式,损失函数是给这个公式打分的尺子。同一个模型可以配不同的损失,回归常配 MSE,分类常配交叉熵。
试一下
同样三个点 (1, 2)、(2, 4)、(3, 5),模型改成 y = 1.5x(b = 0)。三个误差和 MSE 各是多少?它比 y = 2x 好还是差?
预测 1.5、3、4.5,误差 0.5、1、0.5。MSE = (0.25 + 1 + 0.25) ÷ 3 = 0.5。比 y = 2x 的约 0.33 大,所以差一些。
3. 优化:一点点调参数,把损失压到最小
它解决什么问题
上一步靠手猜,从 w = 1 换到 w = 2。参数一多,比如几百万个,就不可能靠猜。需要一个确定的规则,告诉机器每次往哪边调、调多少。这一步叫优化,最常用的方法是梯度下降。
直觉
想象你蒙着眼站在山坡上,要走到谷底。你看不见谷底在哪,但脚能感觉到哪边往下斜。每次朝最陡的下坡方向迈一小步,走着走着就到了低处。
山坡就是「损失随参数变化的曲线」,你站的位置就是当前参数,往下斜的方向由梯度告诉你。梯度下降就是:算出往哪边调参数能让损失下降最快,就往那边挪一小步,反复做。
一步一步看
目标:把四个 w 对应的 MSE 排成一行,看损失怎样先降后升,谷底落在哪一段。
同样三个点,b 固定为 0,把不同的 w 和对应的 MSE 列出来,看损失怎么随 w 变:
- w = 1 时 MSE = 3,在坡的高处。
- w = 1.5 时 MSE = 0.5,往下走了一大段。
- w = 2 时 MSE ≈ 0.33,更低。
- w = 2.5 时 MSE = 2.5,又爬上去了,说明谷底在 1.5 和 2.5 之间。
| w | 预测 | 误差 | MSE |
|---|---|---|---|
| 1 | 1, 2, 3 | 1, 2, 2 | 3 |
| 1.5 | 1.5, 3, 4.5 | 0.5, 1, 0.5 | 0.5 |
| 2 | 2, 4, 6 | 0, 0, −1 | 约 0.33 |
| 2.5 | 2.5, 5, 7.5 | −0.5, −1, −2.5 | 2.5 |
梯度下降不用把每个 w 都试一遍。它从某个 w 出发,每一步看坡往哪边斜就往哪边挪,挪到坡变平就停。这组数据的谷底在 w 约 1.8 的地方。
怎么判断
骨架三步各管一件事,考试问「监督学习的通用框架」时按顺序写:
- 模型:假设一个带参数的公式,比如 y = wx + b。
- 损失函数:量预测和真实值的差距,回归常用 MSE。
- 优化:调整参数使损失最小,常用梯度下降。
判断一个新模型怎么套这副骨架,只看第一步换成了什么。线性回归的模型是一条直线,神经网络的模型是多层网络,第二、三步的逻辑完全一样。
常见误解
以为梯度下降一步就能跳到最优
它每次只挪一小步,要走很多步才接近谷底。步子太大可能跨过谷底来回震荡,太小又走得很慢,这些细节第 4–5 周会正式讲。
以为学神经网络要换一整套方法
神经网络只是把第一步的模型换成多层网络,损失和优化的思路照旧。现在把三步骨架记牢,后面每个模型都是它的变体。
试一下
当前 w = 1.5,MSE = 0.5;试着往大调到 w = 2,MSE 约 0.33;再往大调到 w = 2.5,MSE = 2.5。下一步应该往哪边调?
往回调,回到 1.5 和 2.5 之间。从 2 到 2.5 损失变大了,说明已经越过了谷底,应该在 2 附近往小一点的方向找。
把它们串起来
监督学习的每条数据都有标准答案。答案是连续的数,是回归,用 MSE 当损失;答案是类别,是分类,用交叉熵当损失。判断时看标签和最终要交付的东西,不看输出长得像不像小数,所以降雨概率属于分类。
不管哪种,学习都走同一副骨架。先定模型,比如 y = wx + b;再用损失函数量它在训练数据上错了多少,比如 MSE;最后用梯度下降一步步调参数,把损失压低。三个点的例子里,从 y = x 调到 y = 2x,MSE 从 3 降到约 0.33。
以后学的每个监督模型都是这副骨架的变体,变的只是模型那一步。下一页离开有答案的世界:没有标签的数据怎么分组,没有答案只有奖惩的时候怎么学。
课件里的坑
- [降雨概率] 常见讲法说降雨概率「本质是二分类,概率只是中间输出」。更准的说法是:以下雨 / 不下雨标签训练的是概率分类,概率可以就是最终输出。判据落在标签上,不落在输出的样子上(p.76)
- [直线和曲线] 课件 p.72–75 先画直线、再画曲线拟合房价,两种都算回归。回归不等于「画直线」,曲线也是回归(p.72–75)
- [三步骨架的位置] 课件这几页只铺垫,不展开损失和优化的公式。梯度下降的具体更新式第 4–5 周才讲,这一讲只要求说出三步的名字和作用(p.72–75)
课后 10 分钟:考点复习
这 10 分钟怎么用:合上页面,先默写回归和分类的四行对照表;再在纸上用三个点 (1, 2)、(2, 4)、(3, 5) 重算一遍 y = x 和 y = 2x 的 MSE;然后过三道课件例题,每道先说标签是数还是类别;最后做变式题,重点看降雨概率那题。
必背
- 回归和分类都属于监督学习:回归输出连续值,分类输出离散类别。
- 回归常用损失 MSE,评价看 MSE / MAE / R²;分类常用交叉熵,评价看准确率 / 精确率 / 召回率 / F1。
- 判断回归还是分类看最终要的答案是数值还是类别;预测降雨概率若以下雨 / 不下雨标签训练,属于概率分类。
- 监督学习通用骨架:模型(假设 y = wx + b)→ 损失函数(回归常用均方误差 MSE)→ 优化(调 w、b 使损失最小,常用梯度下降)。
- 后面学神经网络时,变的只是第 1 步的模型形状,第 2、3 步的逻辑完全一样。
课件例题
例 1(课件 p.56):价格的趋势怎么知道?
题面:课件放了一张股票指数跨越一百多年的价格曲线,上面叠了一条向上的趋势线,问「价格趋势怎么知道?涨还是跌?涨多快?怎么比较?」
提示
「涨多快」要的是一个数还是一个类别?
解答
这是回归。要回答的是「涨多快」这种连续的数,趋势线就是拟合出来的那条线。它和分类构成一对:回归输出连续值,分类输出离散类别。
例 2(课件 p.72–75):一套 x 平方英尺的房子,价格怎么预测?
见下方完整例题第 (1) 问。
例 3(课件 p.76):给出面积和占地面积,这套是 house 还是 townhouse?
见下方完整例题第 (2) 问。
完整例题
题面(课件 p.72–76):手上有 n 条样本 (x⁽¹⁾, y⁽¹⁾), …, (x⁽ⁿ⁾, y⁽ⁿ⁾)。x 是房屋面积(平方英尺),y 是价格。散点图上,面积越大价格越高;图中标出了第 15 个样本。
(1) 有人的房子面积 x = 800,y 是多少?这是哪类任务,怎么做?如果还知道占地面积(lot size),输入变成什么? (2) 换一个问题:用 (面积, 占地面积) 判断一套房子是 house(独立屋)还是 townhouse(联排屋)。图上两类点分布在一条斜线两侧,新来一个点落在两类之间。这又是哪类任务?
解法:
- (1) 先看标签:每条样本都带价格 y,有标准答案,所以是监督学习。
- (1) 再看输出:价格是连续的数,所以是回归。
- (1) 怎么做:按三步骨架。模型先假设 y = wx + b;损失用 MSE 量线和散点差多少;优化调 w、b 使 MSE 最小。课件先后画了一条直线和一条曲线,两条都能拟合。拟合好以后,在横轴 800 处往上读到线上的高度,就是预测的价格。
- (1) 加特征:知道占地面积后,输入变成两个数 (面积, 占地面积),x 是二维向量,y 仍是一个价格。特征再多下去,x 就是 d 维向量,可以放楼层数、房屋状况、邮编等等。
- (2) 先看标签:每条样本标了 house 或 townhouse,有标准答案,仍是监督学习。
- (2) 再看输出:只能是两个类别之一,是离散的,所以是分类。那条斜线就是两类之间的分界线,新点落在哪一侧就判哪一类。
要点:两问输入几乎一样,都是房子的面积类特征。决定回归还是分类的是 y:价格是连续数,房型是类别。
答题格式:先写「有标签 → 监督」,再写「y 是连续值 / 离散类别 → 回归 / 分类」,最后一句说怎么得出预测。
变式题(先自己做)
(1) 自编情境:用历史「下雨 / 不下雨」标签训练,预测明天的降雨概率,属于回归还是分类? (2) 自编情境:「预测一位用户下个月在平台上的消费金额」属于回归还是分类? (3) 自编情境:三条样本 (1, 3)、(2, 5)、(3, 7),分别用 y = 2x 和 y = 2x + 1 拟合,各算 MSE,哪条更好?
提示
(1)(2) 别看输出长什么样,看训练用的标签是数值还是类别、任务最终要交付什么。(3) 先算每个点的预测,再算误差、平方、取平均。
判分点与答案(非官方评分标准)
判分点:① (1)(2) 写出判据与依据,不只给结论;② (3) 写出每个点的误差和 MSE 的计算过程。
(1) 概率分类。输出在 0 到 1 之间,看着像连续值,但标签是「下雨 / 不下雨」两个类别。类别概率可以就是最终输出,不必再取硬标签。
(2) 回归。要交付的就是那个金额数值本身,没有一张离散的类别表。和 (1) 放在一起看:判据是标签和交付物,不是输出的样子。
(3) y = 2x:预测 2、4、6,误差 1、1、1,MSE = (1 + 1 + 1) ÷ 3 = 1。y = 2x + 1:预测 3、5、7,误差全是 0,MSE = 0。第二条更好,三个点正好都在线上。
闪卡自测
1. 回归和分类的区别是什么?它们属于哪个范式?
回归输出连续值,分类输出离散类别。两者都属于监督学习(p.76)。
2. 回归和分类各用什么损失和评价指标?
回归常用 MSE,评价看 MSE / MAE / R²;分类常用交叉熵,评价看准确率 / 精确率 / 召回率 / F1(p.76)。
3. 「预测明天的降雨概率」属于哪一类?为什么?
概率分类。标签是下雨 / 不下雨两个类别,概率是属于下雨这一类的可能性;判断看标签和交付物,不看输出是不是小数(p.76)。
4. 监督学习模型的通用骨架是哪三步?
模型(假设 y = wx + b,w、b 待定)→ 损失函数(回归常用均方误差 MSE)→ 优化(调参数使损失最小,常用梯度下降)(p.72–75)。
5. MSE 怎么算?为什么要平方?
每个样本的误差平方后求平均。平方让正负误差不互相抵消,大误差也被放大(p.72–75)。
6. 梯度下降在做什么?
每次算出往哪边调参数能让损失下降最快,就朝那边挪一小步,反复做直到损失不再明显下降(p.72–75)。
7. 后面学神经网络时,三步骨架里哪一步会变?
只有第 1 步的模型形状变成多层网络,损失和优化的逻辑完全一样(p.72–75)。
8. 房价预测里,知道了占地面积,输入 x 变成什么?
变成二维向量 (面积, 占地面积),y 仍是一个价格;特征更多时 x 是 d 维向量(p.72–75)。
下一讲
L01e 讲没有标准答案的两类:k-means 怎样把一堆点自己分成几组,强化学习怎样只靠奖惩学会一套做法。
个人整理的学习笔记,不是官方材料;数字与结论以课件和讲师为准。